Почему Redis такой быстрый, несмотря на однопоточность?
Redis — очень быстрое in-memory KV-хранилище, которое может выдерживать довольно большие нагрузки. Но удивительнее всего тот факт, что он однопоточный.
Возникает вопрос: а как же однопоточное приложение так быстро работает и справляется с большой нагрузкой? На этот вопрос и отвечает сегодняшняя статья.
⭐️ Интересные идеи
➡️ Redis не совсем уж однопоточный. Однопоточная модель применяется для обработки клиентских запросов, но «под капотом» он использует дополнительные потоки для фоновых задач.
➡️ Главная причина высокой скорости работы — простота. Redis работает с данными в оперативной памяти, у которой очень высокая скорость доступа. Также базовая структура данных Redis — хэш-таблица, которая даёт временную сложность доступа к информации O(1).
➡️ Для более сложных кейсов у Redis есть набор структур данных, специально оптимизированных под его внутренние операции и use cases пользователей.
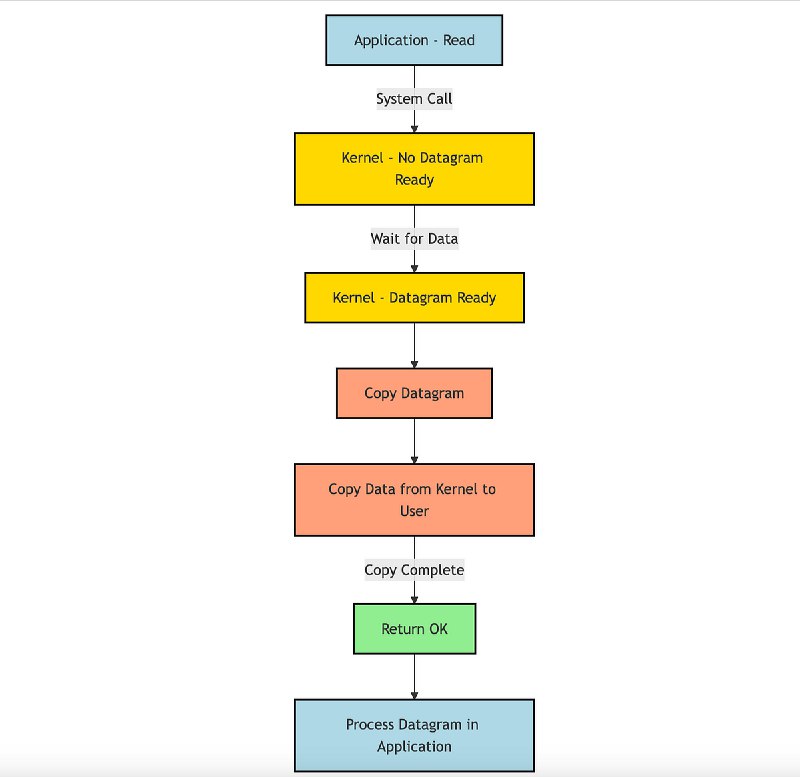
➡️ Redis активно использует мультиплексирование как на своей стороне (I/O), так и на стороне клиента (мультиплексирование подключения). Это позволяет обслуживать множество клиентских потоков без необходимости создавать подключение для каждого из них. Но у этого подхода есть и минусы: у Redis есть блокирующие операции (BLPOP, BRPOP), а пересылка больших чанков данных может замедлить всю работу.
➡️ Redis разработан так, чтобы как можно меньше нагружать CPU. Он выполняет минимум вычислений, поэтому узким местом чаще всего становятся память или пропускная способность сети.
➡️ В Redis реализованы специальные многопоточные оптимизации. Например, очистку памяти выполняет отдельный фоновый процесс.
Приятного чтения!
➖➖➖➖➖➖➖➖➖➖➖
// Понравился пост? Ставь 💛
// И обязательно подпишись на канал, чтобы не пропустить новые статьи
Post #44
334