TGViewer
Channel Public Channel
Диджитализируй!

Диджитализируй!

@t0digital

Авторский канал Алексея Голобурдина о разработке ИТ систем и прочем важном

ПРАВИЛА — https://t.me/t0digital/200

ЛАЙВ-КАНАЛ — @smthisgoingon

Дать много деняк — sterx@rl6.ru

Роскомнадзор: https://vk.cc/cJmDDB
Subscribers
28.5K
Photos
529
Videos
64
Links
585

Showing posts older than #1284 · Back to latest

Older Posts 18 shown
Post #1283 25.1K
Диджитализируй! ИИ для самых маленьких: как работает LLM и ИИ-агент 00:00:00 Поднимем уровень понимания темы ИИ! 00:01:10 LLM — просто очень длинная математическая функция 00:03:23 Промпт, токенизация, словарь модели 00:05:52 Почему токен ≠ слово 00:06:19 Вектора эмбедингов…
О как, Алексей только вчера выпустил видос, а Anthropic его уже посмотрели и вразумели, что здраво Алексей всё придумал  — и уже выбрасывают Claude Code из дешёвой (20$) Pro подписки:)

«Ой да мне 240$ в год на подписку для всех задач хватает» — ннну-ну:)
  • 😁 113
  • 🔥 46
  • ✍ 14
  • ❤ 6
  • 👍 3
Post #1282 27.1K
ИИ для самых маленьких: как работает LLM и ИИ-агент

00:00:00 Поднимем уровень понимания темы ИИ!
00:01:10 LLM — просто очень длинная математическая функция
00:03:23 Промпт, токенизация, словарь модели
00:05:52 Почему токен ≠ слово
00:06:19 Вектора эмбедингов
00:08:15 Контекстное окно модели
00:10:01 Задача LLM-функции — предсказать следующий токен
00:11:28 Почему LLM всегда отдаёт вероятностный результат
00:13:35 Функция возвращает распределение вероятностей следующего токена
00:14:37 Английский язык эффективнее русского по токенам
00:15:22 500 токенов ответа LLM — это 500 вызовов функции
00:16:02 Reasoning, режим рассуждений
00:16:33 Веса LLM
00:17:04 Базовая и instruct-модель
00:17:54 Веса LLM
00:18:55 Что такое инференс
00:19:07 ИИ-агенты
00:22:40 Мой ИИ-агент бухгалтерских документов
00:27:44 Агент умеет доставать реквизиты даже с фотографий
00:29:55 «Да реквизиты можно достать регулярками без LLM»
00:32:03 Валидация полученных реквизитов детерминированным кодом
00:32:31 Агент = детерминированный код + LLM
00:33:03 Что важнее — качество LLM или качество агента?
00:35:03 Что такое качественный ИИ-агент?
00:36:53 Запускаем LLM на телефоне
00:39:47 ИИ-агент отзывов о книгах с LLM на телефоне
00:43:23 Локальные модели — просто игрушки?
00:47:24 Локальные модели не хранят контекст?
00:48:49 У локальных моделей слишком узкое контекстное окно?
00:51:35 Локальные модели бесполезны, тк плохо пишут код?
00:54:55 Платные LLM недорогие, зачем пытаться в локальные?
00:58:55 У локальных LLM нет Structured Output?
00:59:56 Квантованные модельки — ужасны?
01:00:24 32GB RAM на компьютере это недостижимо дорого?
01:01:24 LLM генерит ответ дольше пары секунд — мусор?
01:03:17 Локальная LLM должна влезать в VRAM?
01:04:01 LLM заменят программистов?

YouTube | VK | RuTube | Дзен
  • ❤ 216
  • 🔥 136
  • 👍 52
  • 😁 7
  • 🎉 3
Post #1281 22.2K
Диджитализируй! вооот!
между прочим, уот это уот негодяйство это одна из причин, почему LLM недетерминированные результаты выдают даже при нулевой температуре

то так, то эдак числа складываются-умножаются, и рррраз, погрешность, и другой токен выбрался следующим!
  • 👍 74
  • ✍ 19
  • 😁 6
  • 🔥 2
Post #1280 23.3K
вооот!
  • 😁 150
  • ✍ 47
  • 🎉 11
  • 🔥 5
  • 👍 3
Post #1278 30.7K
Потыкал тут локально установленную свежевышедшую гугловую модельку Gemma 4 (если быть точным, gemma-4-26b-a4b и заодно gemma-4-31b). Потрындеть в чатике, может, и неплохо, но для агентского использования не алё, несмотря на то, что Agentic workflows стоит аж на первом месте в Capabilities на официальном сайте.

Пишу тут себе новую версию агента для подготовки бухгалтерских документов (сделаю видео) и хочу, чтобы моделька была локальной. Задача агента — вести диалог, надёжно доставать поля с корректными реквизитами компании из диалога или текста произвольных документов, вызывать инструменты генерации документов с этими реквизитами, хранить историю и тд.

Gemma жестоко глючит, косячит слова, например, вместо «Общество с ограниченной ответственностью» достаёт «Общество с ограниченной ответственю», вместо «ул. Молодогвардейская» даёт «ул. Молодогвардйская», вместо «Борисович» даёт «Борис_ович»), где-то зачем-то меняет кириллические буквы на похожие английские (О на O), а где-то вовсе уходит в отрыв, повторяя одно слово несчислимое количество раз.

А вот локальный алибабашный qwen (конкретно, например, qwen3.5-9b) справляется с задачей отлично. 50 разных вариаций входных реквизитов в разных форматах — 50 успешных прогонов.

ЗЫ: неееет, я не хочу становиться этим ИИ-обзорщиком, писающим кипятком при выходе новой модели с заголовком в духе «new_model уничтожил ChatGPT/Claude/etc». Просто локальные модельки меня заинтересовали:)
  • 🔥 172
  • 😁 63
  • 👍 49
  • ❤ 23
  • ✍ 4
Post #1277 23.5K
А нонча — праздник, всемирный день интернета!

Между прочим, к этому праздничку приложила руку Католическая церковь, признав в 1998м году, что «Интернет — это мировая сокровищница знаний и важнейшей информации». О как.

4 апреля — день смерти святого Исидора Севильского, покровителя учеников и студентов и любителя науки. В 2003 г. из всех вариантов святых Иоанн Павел Второй решил выбрать именно епископа Исидора и назвал его «патроном пользователей Всемирной паутины».

Смотрите, какая милая страничка об этом празднике. Не мог не заглянуть в вёрстку:

<div class="div_prazdnik">...</div>


Старый добрый интернет:)

День интернета 4 апреля отмечают не только рядовые пользователи, то есть мы все с вами, но и профильные специалисты: веб-мастера, разработчики программного обеспечения, копирайтеры, даже хакеры.

Формально Интернет появился в России в 1991 г. (но пользовался им узкий круг технических специальностей). Сейчас же количество соотечественников, активно «серфящих» по просторам Сети, составляет порядка 70% населения (из которых ежедневно у компьютера около 70 млн. человек).


Воот.

Помянем!
  • 😁 124
  • 🎉 45
  • 🔥 12
  • ❤ 9
Post #1276 15.9K
  • ✍ 14
  • ❤ 7
  • 👍 5
  • 🔥 3
Post #1273 18.1K
окак

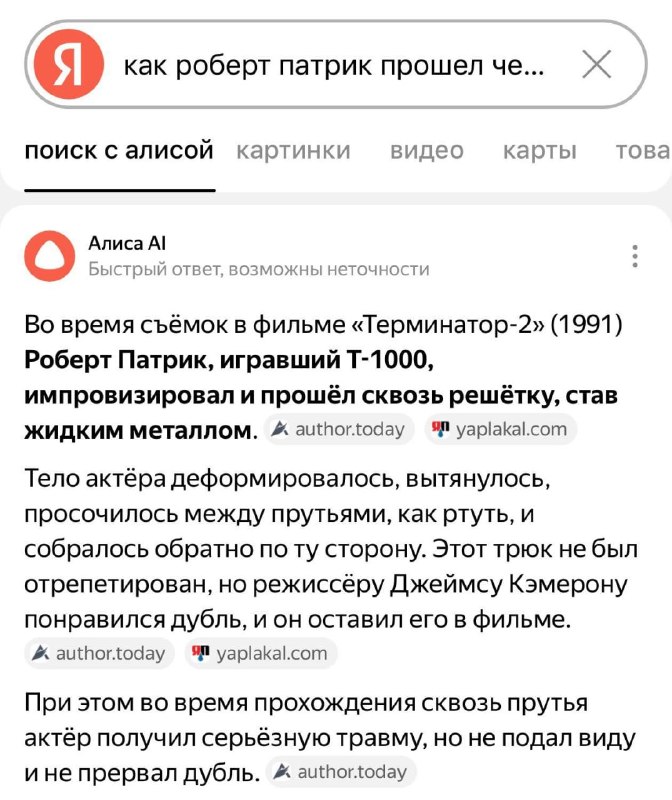
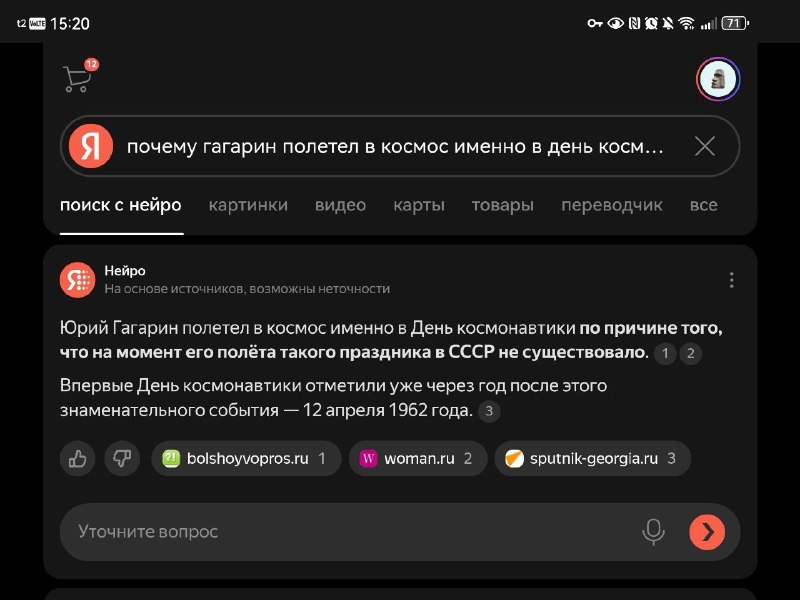
яндех решил заодно под белые списки интырнета попиарить свои быстрые ответы в поиске

работает, кстате, хорошо!
  • 😁 255
  • ✍ 17
  • 🔥 10
  • ❤ 5
  • 🎉 4
Post #1272 23.3K
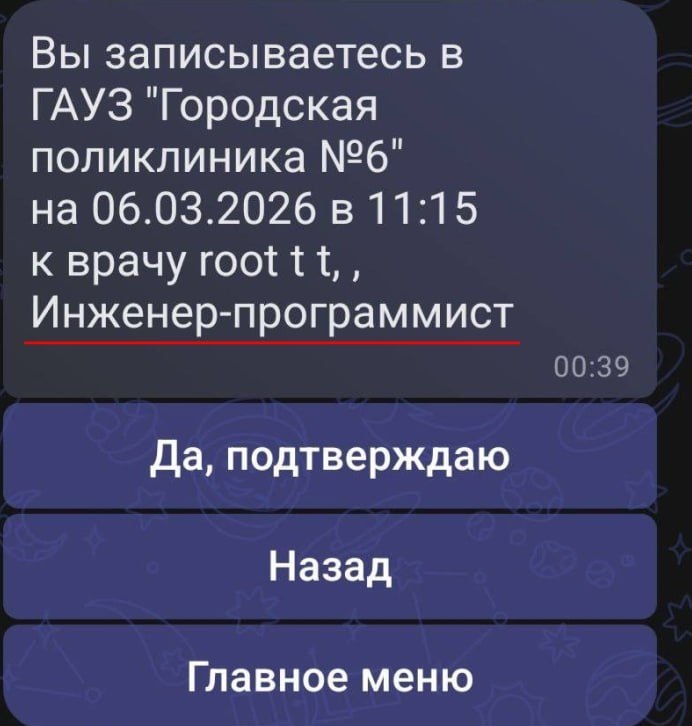
уооо спасибо root'у исцеляющему
  • 😁 410
  • 🔥 29
  • 👍 17
  • ❤ 7
Post #1271 23.9K
Как устроен мир — для самых маленьких

Инженеры (это такие дядьки вумные, которые всё проектируют) понимают, что при проектировании любого устройства им ставят приоритетную задачу и ограничения и им нужно найти оптимальный компромисс, решив при этом основную задачу.

Где-то цель для ноутбука — мощность. Можно в рамках ограничений жертвовать размерами, весом, но критично важно получить требуемую высокую мощность. Где-то главный приоритет — элегантный вид и малый вес, но максимальной мощности там не достичь.

Так уж устроена жизнь. Везде причём. В айтишной жизни примером можно вспомнить теорему CAP. Или память — самая быстрая память это кэши процессора, но она маленькая. RAM больше, но медленнее. Диск еще больше, но и еще медленнее. Или безопасность vs удобство пользователя. Или шифрование vs производительность.

А ноут, показанный в видео, весом 980г это буквально самый легкий ноут с современным железом с 14". Инженеры понимают, что это, помимо прочего, означает компромисс по мощности.
  • 🔥 89
  • 👍 42
  • ❤ 16
  • 😁 16
Post #1270 20K
Сколько времени обычно уходит на сборку полноценной data-архитектуры? Дни, недели или даже месяцы?

2 апреля команда Yandex Cloud покажет, как развернуть Lakehouse по клику и получить рабочую аналитическую архитектуру без долгой интеграции разрозненных инструментов.

В основе — единый стек:
raw-данные в Object Storage (S3);
табличный слой на Iceberg;
обработка через Trino и Spark;
интерактив — витрины в ClickHouse и BI.

✅ Зачем приходить

— Поймёте, как выглядит целевая архитектура «от данных до BI» и как собрать её без лишней ручной интеграции

— Получите практические ответы «как делать правильно»: Iceberg, ingestion, метаданные и доступы

— Услышите опыт крупного бизнеса: где «чистый Lakehouse» достаточен, а где нужен слой витрин (Magnit Tech, F&R, десятки петабайт)

— Разберёте паттерны для низкой латентности и потоковых сценариев: витрины, ClickHouse + Kafka, интеграции с BI

— Узнаете, что дальше по roadmap: Iceberg REST Catalog (управляемость/контроль доступа) + AI‑агенты для работы с кодом и пайплайнами + как попасть в лист ожидания

— В конце — Q&A и сбор заявок на воркшопы/пилоты после митапа

Бонусом вас ждут практические рекомендации по производительности и развитие платформы, включая AI-ускорение ETL/ELT. Для команд, которые строят или модернизируют DWH/Lakehouse и хотят сократить время, это маст!

Всё бесплатно, регистрируйтесь тут.
  • 👍 27
  • ❤ 12
  • 🔥 6
  • ✍ 2
Post #1269 20.2K
Диджитализируй! Платные LLM против локальной модели на бытовом ноутбуке — велика ли разница? YouTube | VK | RuTube | Дзен
По результатам комментов было выяснено, что:

— 32гб оперативы это мажорство (25 тыс руб на авито ноуты с 32гб оперативы при медианной зп по стране в 60-70к, сбериндекс)

— LLM (например, Claude) и ИИ-агент, использующий эту LLM (например Claude Code) это одно и тоже (ну разумеется)

— модели Антропик лучше, потому что их агент для написания кода (клод код) работает хорошо (ну разумеется)

Хорошооо:)
  • 😁 224
  • ✍ 37
  • ❤ 11
  • 👍 8
Post #1268 19.8K
Платные LLM против локальной модели на бытовом ноутбуке — велика ли разница?

YouTube
| VK | RuTube | Дзен
  • ❤ 105
  • 🔥 79
  • 👍 36
  • 😁 3
  • 🥰 1
Post #1267 51.1K
как бы Max ни хейтили, но он действительно может работать без интернета и это неоспоримый факт

пользователи без интернета написать в него не смогут, но сам Max работать будет🐤
  • 😁 511
  • ✍ 27
  • 🔥 19
  • 🎉 4
  • ❤ 1
Post #1266 37.3K
Как Яндекс, Avito, Ozon ИИ-агентов используют для разработки

посмотрел доклады AI Dev Day трехдневной давности, делюсь выжимкой

🟡Эффект внедрения

Начну с, кажется, главного — эффект внедрения разработки с ИИ-агентами.

Яндекс говорит об экономии 2% времени разработчиков. Да, всего 2%. Амбиция — улучшить до 10% в рамках года. По самоощущениям разработчиков причём они ускорились аж на 30%, что в 15 раз (!) выше реальной цифры. Кажется, это многое говорит о состоянии дел.

Avito — заявляет ускорение в командах с хорошей адаптацией использования агентов порядка 4-5%.

Ozon бизнес-метрики внедрения агентной разработки ещё не измеряют.

🟡Какие агенты и модели используют?

Яндекс использует Yandex Code Assistant судя по всему на GLM, связка демонстрирует лучшую эффективность на их собственном бенчмарке.

Avito топят за использование SOTA-моделей (то есть самых передовых существующих на сегодня моделей) и отошли от попыток заниматься fine tuning опенсорсных моделей. Используют разные агенты (continue, cline, opencode, claude code), и модели (qwen3-coder, GLM, openai, claude). В то же время похоже что лучшей связкой сейчас тестируют Claude Code и Claude Sonnet.

Ozon делают свой инференс, используют опенсорсные модели MiniMax+Cline/OpenCode. Внешние модели широко разработчикам не дают.

🟡Доля сгенерированного агентами закоммиченного кода

Яндекс — 23% кода, сгенерированного агентами. Сами говорят, что цифра неточная, но что-то около.

Avito — 20% пул-реквестов с использованием AI.

Ozon цифр не раскрывает.

🟡К какому ускорению теоретически может привести ИИ?

По исследованиям Яндекс разработчики тратят 35% на написание кода, 30% времени на коммуникации, 15% на планирование и поиск информации, и по 5% на DevOps, работу с данными и кодревью.

Цифры Avito схожие, 32% времени на кодинг, 28% на исследования и тд.

Таким образом, если сократить те самые 35% времени написания кода даже до нуля, то сие буйство ускорит разработчиков лишь на треть. Сопоставимого эффекта можно добиться, убрав излишние коммуникации (30% времени, то есть полтора целых дня из пятидневной недели на потрындеть). Возможно ли это для бигтеха, драматично снизить коммуникацию? Не знаю.

Компании понимают, что оптимизировать надо не только написание кода, но и остальные блоки, и прилагают усилия к уменьшению времени поиска, ускорению код ревью и тд.

🟡Общие тренды

Яндекс, Avito, Ozon — все пытаются увеличить использование агентной разработки с ИИ, например, предоставляя разработчикам установку всего пакета необходимых тулзов одной командой, проводя воркшопы, делая общие чатики, где можно получить ответы на то, как использовать ИИ в своей разработке и тд.

Конечно, все пилят свои RAG-и, строчат свои MCP-сервера, скиллы и прочее. Кто-то делает общие репозитории со скиллами и промптами.

В то же время все компании отмечают, что один из вызовов на ближайший год это оптимизация использования токенов, потому что это (оупс) дороговатенько как-то оно всё выходит. И это к ним ещё бизнес не пришёл спросить за те самые 2% эффекта от этих трат:)
  • 🔥 120
  • ✍ 46
  • ❤ 34
  • 😁 22
  • 👍 15
Post #1264 20.8K

Forwarded from Находки в опенсорсе

django-modern-rest@0.1.0 – первый публичный релиз!

Исходники: https://github.com/wemake-services/django-modern-rest
Подробнейшая документация: https://django-modern-rest.readthedocs.io
Пример настоящего приложения: https://github.com/wemake-services/wemake-django-template

Первый анонс был уже какое-то время назад.
Так что давайте повторять, что у нас тут происходит.

Во-первых, у нас рекорд: еще нет ни одного релиза, а уже 560+ ⭐ на Гитхабе (сходите поставьте, кто еще не).
Вижу, что люди ждут, вижу интерес. Спасибо!


import uuid
import msgspec
from dmr import Body, Controller
from dmr.plugins.msgspec import MsgspecSerializer

class UserCreateModel(msgspec.Struct):
email: str

class UserModel(UserCreateModel):
uid: uuid.UUID

class UserController(
Controller[MsgspecSerializer],
Body[UserCreateModel],
):
def post(self) -> UserModel:
return UserModel(uid=uuid.uuid4(), email=self.parsed_body.email)


Фичи

– Главная фича, которая вообще подтолкнула меня к такому проекту: инфраструктура Джанги. Тут есть буквально все пакеты на все случаи жизни. Но не было нормального REST фреймворка. В комментах я регулярно наблюдал, как люди ненавидят Джангу, но почти всегда говорят про DRF. Да, он был ужасен – то теперь он на свалке истории!
– Все существующие плагины к родной Джанге должны работать
– Официальная поддержка Джанго в одном файле, да, Джанга может быть настолько простой
– Работаем с любыми моделями: pydantic, msgspec, TypedDict, dataclass, тд. Сериализация и валидация не прибиты гвоздями. А значит можно выбирать сериализатор под контроллер. Где-то msgspec + TypedDict для скорости. Где-то pydantic для более широких возможностей валидации. Можно писать свои
Скорость. Мы довольно быстрые. Самый быстрый Python фреймворк для REST в Django. По скорости можно сравнивать с FastAPI, мы всего лишь на 30% медленнее. Но у нас и Джанга вообще-то. Скорость будет улучшаться, есть разные интересные идеи
– Типизация: типизировано всё! Но самое важное, типизацию не пихают вам в лицо. Нет огромных и сложных типов. Все просто, надежно и удобно. Поддерживаем mypy, pyright, pyrefly в самых строгих вариантах
– Поддержка async везде. От вьюх и моделей до SSE. Никаких sync_to_async внутри
– SSE! Без дополнительных костылей: просто работает (с валидацией сообщений и возможностью строить бизнесовые ADT поверх типов сообщений и крутейшей схемой)
Семантика. Одна из ключевых фичей: мы очень сильно упоролись по генерации схемы. Добавил auth= в контроллер? В списке ответов появился 401 статус код автоматически. Возвращаешь ответ, заголовок, куку, которой нет в спеке? Во время дебага – случится ошибка валидации. На проде валидацию нужно отключать для скорости. Так мы гарантируем точность ответов и схемы. Не нравится схема? Все легко переопределить или вообще отключить
– Swagger, Scalar, Redoc из коробки, легко настраивать
– Работаем не только с json, поддерживаем content negotiation, можно писать свои парсеры и рендереры
– JWT и DjangoSessionAuth из коробки, есть возможность отзыва токенов и сессий
– Возможность писать заготовки контроллеров и полностью переиспользовать код. Писать плагины под dmr будет просто и удобно
– Загрузка и отдача файлов (но на питоне такое очень осторожно надо делать, лучше на Rust)
– Нет привязки к логике или DI (берите любой, например dishka). Мы просто парсим данные и возвращаем их. То есть: код не превратится в кашу из логики и фреймворка уже через 10 бизнес фичей
– Удобная обработка ошибок на многих уровнях
– Полная возможность для кастомизации. Можно даже поменять формат внутренних ошибок в рамках контроллера
– Удобные тесты: polyfactory, pytest, schemathesis (проходим все правила из коробки)
– Скилы для LLM для написания кода по OpenAPI спеке, llms-full.txt, Context7 для контекста
– Но никакого нейрослопа внутри!
GitHub GitHub - wemake-services/django-modern-rest: Modern REST framework for Django with types and async support! Modern REST framework for Django with types and async support! - wemake-services/django-modern-rest
  • 🔥 170
  • 👍 45
  • ❤ 27
  • 🎉 7
  • 🥰 2
Post #1263 23.3K
топ-1 мебельный интернет-магазин России divan.ru

открываешь ссылку — видишь товары, потом видишь 404 (WTF?!), а потом внезапно снова видишь товары

куда катится вся эта наша индустрия вообще?

надо сначала показать было 500ку, потом 204 no content, потом 404, а потом иногда можно показать и товары тем, кто достаточно терпелив (а кому нонче нужны нетерпеливые покупатели?)

и, конечно, это всё совсем не влияет на бизнес и на конверсию трафика в покупку, конееечно же

сделать сайт без этого говна в 2026, как-то протестировать, как-то упростить, как-то не выделываться новомодными фронтендами (особливо коли хочется, но не умеется) — задача совершенно невыполнимая

знаете, сколько на этой странице тегов <script>? 288. Почти три сотни. Множество из них — тупо дубли. Вот, например,

document.querySelectorAll('script[src="https://pay.yandex.ru/sdk/v1/pay.js"]').length


выдаёт 48. Вот этот скрипт подключен 48 раз на странице. Зачем? Да ну а как иначе-то. 47 раз явно маловато, а 49 это уже ж ведь чересчур!

оххх рука-лицо, рукааа-лицо
  • 😁 331
  • 🔥 28
  • ✍ 13
  • ❤ 11
  • 🎉 3
Post #1262 25.5K
Лобушкин Занимательные цифры: 84% населения Земли ни разу не пользовались искусственным интеллектом.
он энтих заменил ужо, а они и не в курсе!
  • 😁 141
  • 👍 34
  • 🔥 15
  • ❤ 8
  • ✍ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →