


NVIDIA обучила семейство моделей Nemotron-Terminal для автономной работы в терминале Linux: устанавливать зависимости, писать и запускать код, отлаживать окружения и выполнять сквозные инженерные задачи без участия человека.
Семейство построено на базе Qwen3 и специально собранном датасете Terminal-Corpus. И фишка не в архитектуре, а в данных.
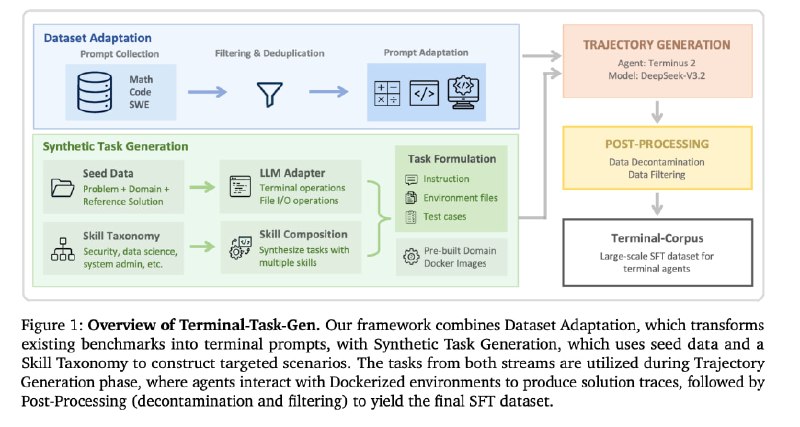
🟡NVIDIA собрала пайплайн Terminal-Task-Gen с 2 потоками.
Первый адаптирует готовые датасеты по математике, коду и SWE-задачам под терминальный формат (без участия LLM в процессе адаптации).
Второй генерирует синтетику 2 методами: seed-based (LLM создает новые задачи на основе существующих задач из смежных областей) и skill-based (LLM комбинирует до пяти примитивных навыков из таксономии по 9 доменам: Security, Data Science, System Administration и другим).
🟡В открытый релиз вошли все три модели на 8B, 14B, 32B параметров и 2 датасета:
Terminal-Corpus: около 366K траекторий выполнения задач, разбитых на два потока: ~226K адаптированных примеров из Math/Code/SWE и ~140K синтетических задач на основе skill-таксономии.
Synthetic-Tasks: задачи в стандартизированном формате: инструкция, Docker-окружение из 9 преднастроенных образов и верификационный набор на pytest.
🟡Результаты прогонов на бенчах.
На Terminal-Bench 2.0 все 3 модели показали кратный рост относительно базовой Qwen3: 8B - с 2.5% до 13%, 14B - с 4% до 20.2%, 32B - с 3.4% до 27.4%.
Для сравнения: Qwen3-Coder на 480B параметров набирает 23.9%, GPT-5-Mini - 24.0%, Grok 4 - 23.1%. Nemotron-Terminal-32B превосходит или вплотную конкурирует с ними всеми при разнице в размере на порядок.
🟡Несколько внезапных выводов из абляции.
Фильтрация неудачных траекторий вредит. Модель, обученная на всех траекториях включая ошибочные, набирает 12.4% против 5.06% у варианта только с успешными.
Curriculum learning (сначала простые данные, потом сложные) не дал преимуществ перед простым смешанным обучением.
Увеличение контекстного окна с 32K до 65K токенов также не помогло, длинные траектории оказались шумнее.
📌Лицензирование моделей: NVIDIA Open Model License
📌Лицензирование датасетов : CC-BY-4.0 License.
🟡Набор моделей
🟡Arxiv
@ai_machinelearning_big_data
#AI #ML #LLM #NemotronTerminal #NVIDIA