


Если подобным образом проанализировать все лейблы на реальных данных, получится, что:

- 32,7 % из них имеют всего одно возможное значение, например true или 0;
- 60 % — от 2 до 255 значений, то есть укладываются в 1 байт;
- 7,3 % — от 256 до 5275 значений;
- 0 % — больше 65 535 значений.

Это значит, что все возможные значения укладываются в два байта.

Мы решили хранить все ID (#0, #1, #2 и т. д.) не в четырёхбайтных значениях, а как два бита, указывающие количество байт, в которые укладывается число, плюс значение.

Это дало нам очередной выигрыш по памяти — теперь весь labelset для 1 миллиона метрик стал занимать 30 МБ. Это в 30 раз лучше стартовых 762 МБ.
. . .
Оптимальное хранение строк дало приличный выигрыш и в индексе. Если раньше в нём были строки и хэш-таблицы, которые не особенно оптимально хранятся в памяти, то в нашей реализации есть ID, которые выдаются по порядку. Это позволяет хранить в кэше четырехбайтные числа uint32 и заменить хэш-таблицы на sparse-векторы и Bitset.

В итоге основным потребителем памяти у нас стали точки. Prometheus хранит их достаточно компактно: он использует Gorilla Encoding и битовые операции. Это не значит, что оптимизировать нечего, но для этого надо внимательно посмотреть на данные.
. . .
Оказалось, что уникальных последовательностей временных меток всего 10 % от миллиона. Эта оптимизация позволила выиграть 55,5 % по памяти просто за счёт дедупликации.
. . .
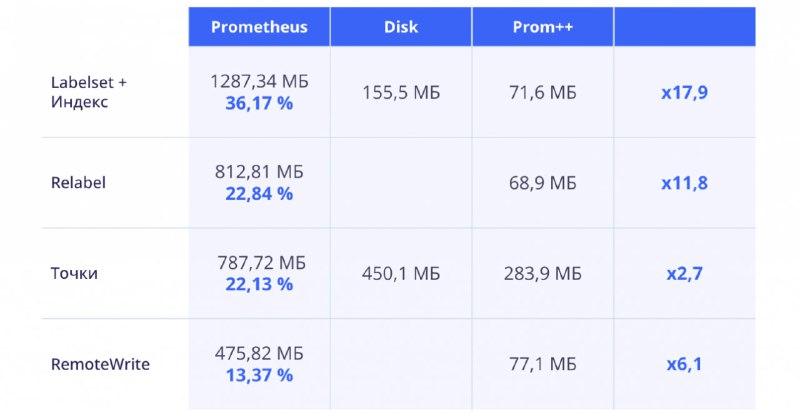
После всех преобразований мы получили выигрыш по хранению точек почти в три раза: изначальные 787,72 МБ превратились в 283,9 МБ. При этом чем больше данных и серий, тем лучше срабатывает наша оптимизация. Если на одном миллионе метрик мы выиграли по хранению точек в 2,7 раза, то на трёх миллионах это будет уже три с небольшим раза.
. . .
В процессе работы Prometheus пишет WAL. Мы оптимизировали журнал предзаписи примерно в 19 раз. Изначальные 6,2 ГБ без сжатия в Prometheus v2 для 1 миллиона метрик превратились в 153 МБ в Deckhouse Prom++.
Deckhouse Prom++: мы добавили плюсы к Prometheus и сократили потребление памяти в 7,8 раза
https://habr.com/ru/companies/flant/articles/878282/
+
Deckhouse Prom++
https://github.com/deckhouse/prompp/
Чат: @prom_plus_plus