
Diffusion Language Models на ICML 2026
Собрали несколько работ о дифффузионных моделях и побеседовали с их авторами.
Residual Context Diffusion Language Models
Известная статья на тему masked diffusion. Суть в том, чтобы уменьшить потерю подсчитанной информации, которая обычно выбрасывается при низких вероятностях демаскируемых токенов.
Как работает masked diffusion. На каждом шаге генерации выделяется фрагмент последовательности (блок), который будет демаскироваться одновременно (что и должно приводить к ускорению). Но если сразу размаскировать все токены, качество будет плохим. Поэтому размаскируем только те из них внутри блока, предсказанные вероятности которых высоки. Вероятности других — низкие —выбрасываем и перегенерируем их заново, обуславливаясь на все размаскированные до текущего шага токены.
Для решения проблемы отброшенных вычислений вероятности непринятых токенов подают на следующий слой через дополнительный residual-вход. Чтобы дообучить модель работать с новым входом, предлагают использовать простую замороженную модель, которая предоставит не очень качественные вероятности.
Часть о том, что надо обучаться с dummy-моделью, а инфериться на хорошей, — ограничение метода. Автор считает, что его можно минимизировать рекурсивным дообучением, но сдвиг между распределениями никогда не будет нулевым. В целом необходимость делать такие трюки кажется ему фундаментальным ограничением дискретной диффузии, и он верит в скейлинг непрерывных подходов для генерации текстов.
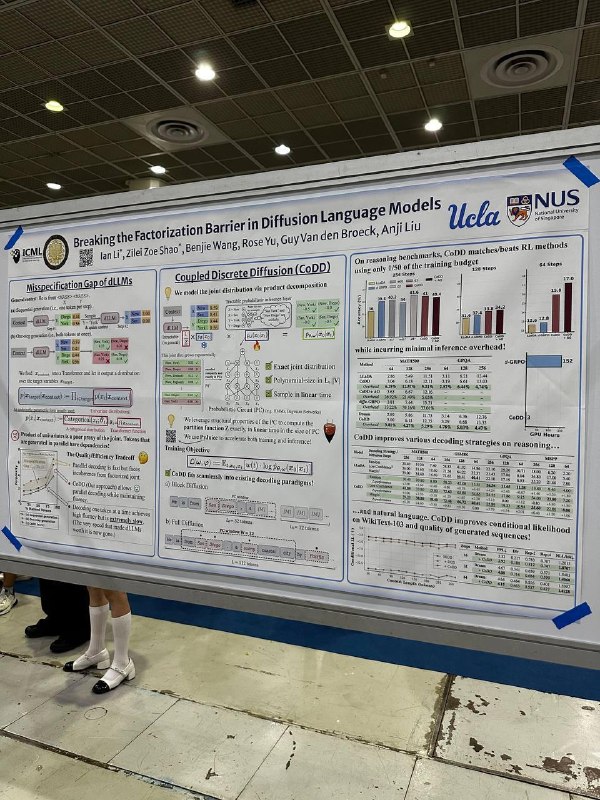
Breaking the Factorization Barrier in Diffusion Language Models
Работа об увеличении репрезентативности masked diffusion. Проблема в том, что помимо самих текстовых знаний модель должна выучить ещё и все возможные комбинации паттернов размаскирования. Это непростая задача, хочется уменьшить комбинаторную сложность в ней.
Предлагается учить peft-like-добавку определённой структуры, специально направленную на понимание паттернов семплирования. На инференсе будем параллельно вычислять эту добавку и основные веса для получения вероятности размаскирования токенов.
Использовать метод можно для двух целей. Основная, которую показывают в статье, — увеличение качества при фиксированной скорости. Дополнительная — увеличение скорости (количество размаскируемых токенов за форвард) при сохранении качества.
Метод поскейлили до LLaDA 8B и показали буст качества относительно LoRA-добавок — правда, померить на этом скейле смогли только ген-перплексию.
Scaling Beyond Masked Diffusion Language Models
Есть несколько конкурирующих подходов к тому, как делать диффузию для текстов. Самый популярный — masked diffusion. Так получилось, потому что на низких масштабах компьюта и размеров моделей было показано, что у этого класса моделей теоретически лучший баланс эффективности и качества в терминах ген-перплексии (что не слишком надёжно).
Авторы делают честное сравнение разных диффузионных подходов (и авторегрессии как бейзлайна), но теперь скейлят модели до 2B параметров и показывают, что uniform state diffusion — на деле лучший подход.
На постере и в беседе автор тизерит свою следующую работу, в которой для uniform state diffusion сделали алайн и победили Nemotron 8B и Diffusion Gemma 26B по скорости и качеству на агентских бенчах.
Learning Unmasking Policies for Diffusion Language Models
Также удалось пообщаться с автором. Идея — в обучении небольшой полиси-головы поверх замороженной диффузионной тушки. Сама полиси-сетка очевидно выучивает статистики из домен-специфичных данных потому что, по словам автора, для хорошего качества им приходилось учить отдельные политики для кода и математики.
Также есть параллельная работа, в которой тушку размораживают и дообучают голову вместе с ней. Это дороже, но перспективнее в плане качества.
Фишка метода из статьи — из-за отдельного обучения головы можно смотреть, какие домен-специфичные паттерны выучиваются. Так, для математики политика выучивает больше всего токенов семплить на последних блоках, что не сработало бы для кода.
Увидел интересное ❣ Сергей Кастрюлин
#YaICML2026
Душный NLP
Post #269
1.86K



- ❤ 18
- 👍 10
- 🔥 4
- ❤🔥 2