
IceCache: Memory-Efficient KV-cache Management for Long-Sequence LLMs
Статья развивает область retrieval-based KV-cache-методов. Основная их идея такава:
1) на префилле: сгружаем KV-кеш на CPU; за счёт этого экономим GPU-память;
2) на декодинге: загружаем обратно на GPU только подмножество наиболее релевантных KV, считаем аттеншен по части токенов; за счёт этого эффективно снижаем seqlen, экономим compute.
Существующие методы загружают кеш последовательными чанками. Проблема такого подхода в том, что релевантные токены разбросаны по памяти, и при загрузке их чанков на GPU переносится много лишних токенов.
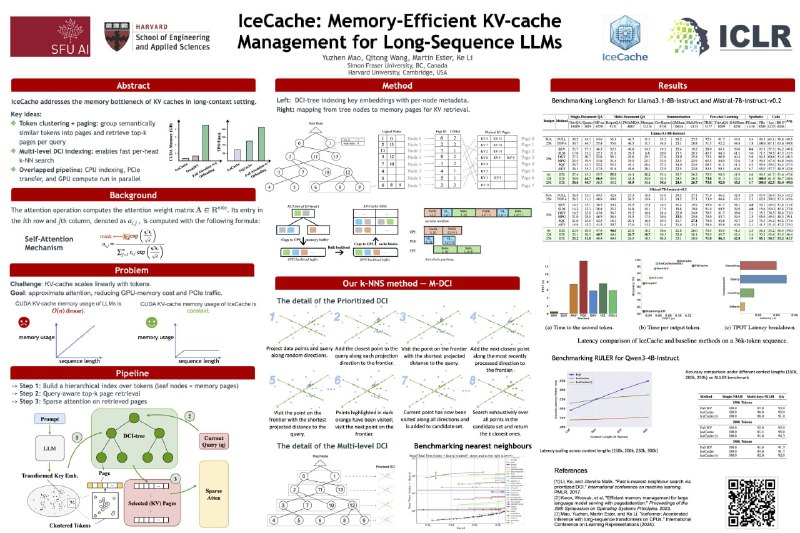
IceCache решает это через изменение layout’а KV-cache: страница в памяти определённому токену назначается не по его позиции, а на основе косинусной близости к опорным токенам.
Таким образом, страницы становятся «семантическими», релевантные токены лежат более компактно, занимают меньше чанков, благодаря чему можно уменьшить трансфер CPU —> GPU, а также сократить эффективный seqlen при вычислении аттеншена.
Реализация
В основе метода — кастомная структура данных DCI-tree для задачи приближенного поиска k-ближайших соседей. С её помощью токены распределяются по страницам памяти, а также на шаге декода выбираются наиболее релевантные токены.
На префилле параллельно с вычислением аттеншена происходит оффлоадинг KV-кеша на CPU, а затем индексирование ключей на CPU при помощи DCI-tree. На декодинге для данного query при помощи DCI-tree определяются страницы с релевантными токенами. Те из них, которые не использовались на предыдущем шаге декодинга, дозагружаются из CPU на GPU.
Первые токены в последовательности, attention-синки, всё время находятся в GPU-памяти. То же самое происходит с «хвостом» декодируемых токенов. Как только набирается окно из N декодированных токенов, они асинхронно сгружаются на CPU и индексируются DCI-tree.
Авторы реализовали DCI-tree на C, а также написали CUDA-кернел, эффективно копирующий страницы из CPU-памяти в нужные страницы PagedAttention. Код доступен на GitHub.
Метрики
Avg. accuracy:
1) до ~99% качества полного KV-кеша при бюджете 256 токенов;
2) при бюджете 64 — сопоставим или лучше бейзлайнов с x4 большим кешом.
Latency на llama3.1-8B с 36k seqlen:
1) time to second token: 5,9с., на уровне OmniKV;
2) time per output token: 0,11с., против 0,05с. у OmniKV.
Потенциальные проблемы
Наиболее слабое место метода — необходимость синхронизации GPU и CPU перед вызовом аттеншена на каждом шаге декодинга. Авторы прямо указывают, что половину времени декодинга занимает поиск по DCI-tree, исполняемый на CPU.
Вероятнее всего, для практического применения метода нужно будет заменить DCI-tree на структуру данных, в которой алгоритм поиска соседей адаптирован под GPU. При этом обновление дерева по-прежнему может асинхронно выполняться на CPU.
Разбор подготовил ❣ Михаил Катунькин
#YaICLR26
Душный NLP
Post #252
2.76K
- 🔥 15
- ❤ 6
- 🤝 4