TGViewer
Channel Public Channel
Data Science: Алгоритмы и Структуры данных

Data Science: Алгоритмы и Структуры данных

@structuredata

Мы не претендуем на оригинальность контента, мы лишь собираем материал из открытых источников.

Ссылка: @Portal_v_IT

Сотрудничество, авторские права: @oleginc, @tatiana_inc

Канал на бирже: https://telega.in/c/structuredata
Subscribers
7.64K
Photos
473
Videos
46
Links
3.4K

Showing posts older than #4833 · Back to latest

Older Posts 15 shown
Post #4832 497
Возвращение легенды: самый востребованный практикум Зерокодера по Claude Code снова пройдёт в августе.

CEO университета Зерокодер Кирилл Пшинник проведёт ещё один бесплатный онлайн-практикум, где в прямом эфире покажет, почему вокруг Claude Code столько шума и как использовать его на полную мощность.

На практикуме разберут:

• Как получить доступ к Claude Code из России и начать работать без ограничений;
• Как запускать сразу несколько ИИ-агентов для одного проекта;
• Как за 15 минут собрать рабочий сайт практически без ручного кода;
• Как автоматизировать аналитику и рутинные задачи без дополнительных сервисов;

Бонус: в конце практикума расскажем, как пользоваться Claude Code бесплатно и оформить виртуальную карту для оплаты других AI-сервисов

P.S. Это специальный повтор одного из самых популярных практикумов Зерокодера по Claude Code. Жмите на ссылку и успевайте зарегистрироваться!
Post #4825 545
👩‍💻 Хватит учить только синтаксис, начинай делать реальные проекты!

Python Ready — авторский канал, где Python перестаёт быть только теорией и становится рабочим инструментом. Мини-проекты, боты, советы, разборы задач, гайды и шпаргалки для каждого программиста.

🔥 Советую подписаться: @python_ready
Post #4824 618
Наглядное введение в нейросети на примере распознавания цифр

При помощи множества анимаций на примере задачи распознавания цифр и модели перцептрона дано наглядное введение в процесс обучения нейросети.

➡️Читать статью

Data Science: Алгоритмы и Структуры данных
Post #4823 628
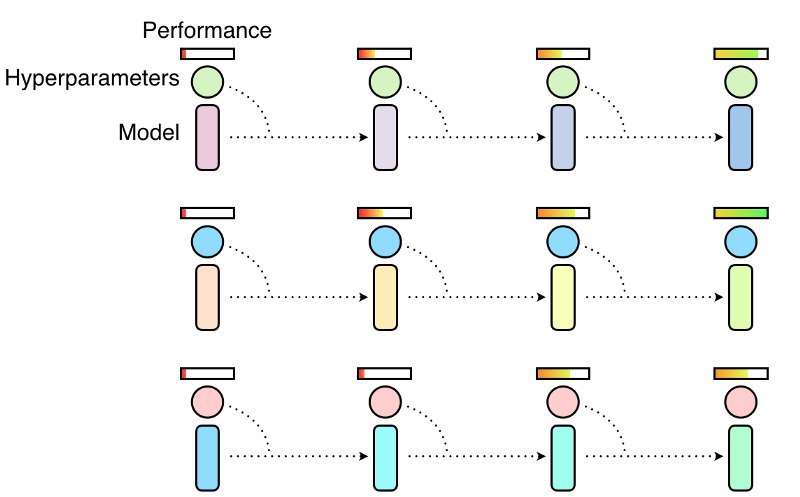
Новый подход в Deep Learning: популяционное обучение нейросетей

Из данной статьи вы узнаете о подходе, предложенном компанией DeepMind для настройки гиперпараметров в моделях Deep Learning: популяционное обучение нейросетей.

➡️Читать статью

Data Science: Алгоритмы и Структуры данных
Post #4822 591
Структура данных: Граф

Граф состоит из конечного набора вершин(узлов) и набора ребер, которые соединяют пару узлов.

Графы используются для решения многих реальных задач. К примеру для представления сетей: городских или телефонных или даже компьютерных сетей. Также представление графа заложено почти в каждой социальной сети.

Data Science: Алгоритмы и Структуры данных
Post #4821 599
Решение задачи: отсортировать почти отсортированный массив

Я же не зря завел данную задачу, аккуратно после темы кучи (Heap). Как раз подобный вид сортировки - лучше сделать как раз при помощи Heap!

Алгоритм

1. Создайте минимальную кучу (min Heap) размера k + 1, с первыми элементами k + 1 (это кстати у вас займет где-то O(k)

2. Один за другим удалите минимальный элемент из кучи, помещая элемент в массив результатов и добавьте новый элемент в кучу из оставшихся элементов

Data Science: Алгоритмы и Структуры данных
Post #4820 580
Как построить имитатор рынка с использованием цепей Маркова и Python

Модель поведения клиентов, визуализация результатов теста A/B, прогнозирование пользовательских показателей ... все с использованием простой марковской структуры!

➡️Читать статью

Data Science: Алгоритмы и Структуры данных
  • ❤ 1
Post #4819 591
Задача: отсортировать почти отсортированный массив

Дан массив из n элементов, где каждый элемент находится не более чем на k от своей целевой позиции. Разработайте алгоритм, который выполняет сортировку за время O(n log k)

Data Science: Алгоритмы и Структуры данных
Post #4818 557
Сортировка кучей (HeapSort)

Алгоритм сортировки в куче для сортировки в порядке возрастания:
1. Создайте максимальную кучу из входных данных.
2. На этом этапе самый большой элемент хранится в корне кучи. Замените его последним элементом кучи, а затем уменьшите размер кучи на 1. Наконец, скопируйте корень дерева.
3. Повторите шаг 2, пока размер кучи больше 1.

Data Science: Алгоритмы и Структуры данных
Post #4816 512
Китайская нейросеть, которая заменяет подписку на GPT — бесплатно и оффлайн

2026 год – новая эпоха для DeepSeek. Китайская нейросеть работает прямо на вашем устройстве, обгоняет западные модели и снимает все ограничения: без подписок, без интернета, без контроля.
Зерокодер обновил практикум и собрал все, что важно знать о локальных моделях и как с ними работать.

⚡️Что ждет вас на вебинаре?

– Покажем, как установить DeepSeek на компьютер и пользоваться нейросетью оффлайн, без подписки и передачи данных в облако;
– Объясним, чем отличаются версии DeepSeek и какие модели использовать для текста, кода, анализа данных, обучения и исследований;
– Проверим DeepSeek на реальных задачах: коде, документах, расшифровках созвонов и работе с собственными файлами;
– Покажем, как монетизировать навыки работы с локальными ИИ и как работать быстрее GPT бесплатно.

Регистрируйтесь прямо сейчас

Участники эфира получат чек-лист по выбору модели под задачу и подборку 20+ сценариев для ИИ-помощника на своем компьютере, который работает с вашими файлами.

Эфир подойдёт всем, кто хочет пользоваться ИИ без лимитов и зависимости от чужих серверов, монетизировать навыки и оставаться в тренде технологий 2026 года.

Бесплатный практикум – по ссылке.
Post #4815 521
Операции над биномиальной кучей

1. insert(H, k) - вставкляет ключ К в биномиальную кучу H. Эта операция сначала создает биномиальную кучу с одним ключом, а затем вызывает объеденение для H

2. getMin(H) - пройдется по списку корней биномиальных деревьев и выдаст вам минимальный ключ

3. extractMin(H) - сначала вызывается метод getMin(), чтобы найти минимальное ключевое значение, после чего создаст новое биномиальное дерево, правильно его отформатировав

4. delete(H) - операция удаления, как и с операцией удаления в бинарном дереве: сначала уменьшает ключ до минус бесконечности, а после вызывает extractMin()

5. reduceKey(H) - сравниваем ключ уменьшения с ключом родительским, и если родительский ключ больше , мы меняем ключи и повторяем для родительского узла. Останавливаемся тогда, когда родительский элемент имеет наименьший ключ.

6. union - операция объеденения, которая используется во многих других функциях, как вы могли наблюдать.

Data Science: Алгоритмы и Структуры данных
Post #4814 546
Свойства биномиального дерева

1. У данного дерева 2К узлов
2. Глубина дерева равна К
3. На глубине i имеется ровно kCi узлов для i = 0, 1, ..., k
4. Корень дерева имеет степень k, а потомки корня сами являются биномиальными деревьями с порядком k-1, k-2,..0 слева направо

Data Science: Алгоритмы и Структуры данных
Post #4813 669
Anaconda − самая популярная data science-платформа в Python.

Кроме обучающих видео, канал содержит видеозаписи конференций AnacondaCon с выступлениями представителей комьюнити по анализу данных, IT-профессионалов, аналитиков, разработчиков и бизнес-лидеров. anaconda.com

➡️Смотреть видео

⬇️ Скачать видео

Data Science: Алгоритмы и Структуры данных
Post #4812 670
Биномиальная куча

Основным применением двоичной кучи является реализация очереди приоритетов. Биномиальная куча - это расширение обычной двоичной кучи, которое обеспечивет более быструю операцию объеденения или слияния.

Биномиальное дерево порядка 0 имеет 1 узел. Кго уровня можно построить, взяв два биномиальных дерева порядка к-1 и сделав одно из них крайним левым дочерним элементом.

Data Science: Алгоритмы и Структуры данных
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →