
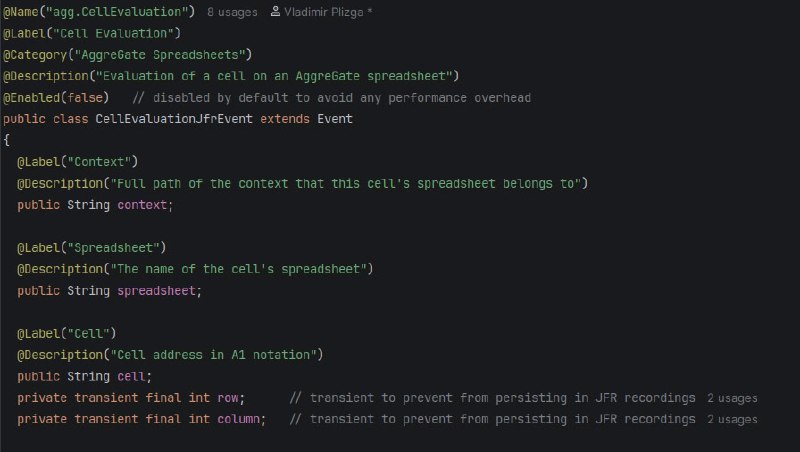


На моем тренинге по #JFR мы с участниками, кроме прочего, учимся делать собственные JFR события, чтобы эммитить их прямо из бизнес-логики, а потом анализировать так же, как встроенные события JVM. И хотя я стараюсь объяснять, зачем это надо, в воздухе нередко остаётся висеть незаданный вопрос участников: "А зачем бы я применил(а) это у себя в проекте?" 🧐
Делюсь свежим примером из своей практики 👇
Когда-то я рассказывал вам, что мы пилим свой условный аналог Excel на платформе AggreGate. Сейчас на этом решении наш партнёр реализует огромный проект для заказчика, и движок вычислений там используется в полный рост, потому что хотелки у заказчика тоже не слабые:
— десятки больших таблиц
— сотни тысяч ячеек в них
— ≈280К узлов в графе связей между ячейками разных таблиц 🕸
Ну и конечно же на этом фоне к нам в JIRA стали периодически поступать тикеты с интригующими заголовками в духе: "У нас где-то что-то когда-то почему-то не посчиталось/не обновилось/не сбросилось, но мы не поняли, где, когда и почему. Разбирайтесь😘"
Как вы наверняка догадываетесь, логировать вычисления в таких масштабах, а потом купаться в этих логах (или выгружать их в какой-то парсер-анализатор) — затея трудоёмкая и малоперспективная. Но видеть ход вычислений в точности до ячеек всё же надо. То есть нужен максимально простой, дешевый (с т.з. overhead'а) и пригодный для анализа результатов способ как-то фиксировать вычисления ✍️
И тут я снова вспомнил про кастомные события JFR, ведь у них очень простой, но при этом гибкий API, они весьма дешевы в эмиссии и хранении, а их анализ в Java Mission Control хоть и не так мощен, как какой-нибудь Logstash+Kibana, но всё же на порядок удобнее, чем с логами 🧶
Я завёл класс с описанием вычисления (см. скриншот 1) и стал эмитить с ним JFR события в двух местах:
— при инициации вычислений (на пользовательском вводе или открытии готовой таблицы)
— и при обновлении по слушателю (когда пересчёт одной ячейки аффектит другую).
Это позволило регистрировать 100% вычислений 💯
Зная масштабы проекта, я опасался, что JFR записи будут огромными и с ними будет тяжело работать, поэтому воспользовался фичей JFR API по добавлению кастомных настроек — поддержал фильтрацию регистрируемых вычислений по диапазону ячеек в обычной нотации Excel, например,
sheet_a!B5:F16 (скриншот 2). Но моему к приятному удивлению, это оказалось лишним: недавно коллеги по запарке оставили JFR-запись включенной без этого фильтра на 21 час, и в неё набежало 303 000 событий, а получившийся JFR файл весил 105 МБ. При этом он без труда открылся в JMC, а работать с ним было также легко, как и с маленьким (скриншот 3) 🌿Любопытно, что изначально я планировал управлять этой диагностикой через утилиту
jattach, но в закрытый контур заказчика втащить даже безобидную jattach оказалось нельзя (небезопасно типа). Тогда мне пришлось извернуться и написать на платформенном low-code-языке функции, которые через JFR API дёргают методы запуска/останова записи, да еще и конфигурируют нужные события. Как ни странно, функции получились довольно компактными и сработали чётко, а в качестве бонуса их вызов удалось вывести прямо в UI-интерфейс платформы для удобства администраторов 👷🏼Теперь мы этим активно пользуемся, и когда приносят очередную задачу по проблеме вычислений, знаем, с чего начинать анализ 🕵️♂️
Конечно, сама по себе диагностика на JFR-событиях сложные/редкие/заковыристые проблемы не решает. Но она прокладывает очень важный и довольно длинный кусочек мостика между "Черт возьми, что здесь вообще происходит!?" и статусом тикета "Resolved (Fixed)" ✅