Коллеги, привет! 👋
🔍 Проблема традиционного мониторинга БД
Интересный топик вычитал в блоге Grafana. Суть в том что большинство команд следит за производительностью баз данных с помощью внутренних метрик, таких как:
- Время выполнения запросов
- Количество соединений
- Загрузка процессора и памяти
- Количество ошибок
И у нас так же, однако такой подход имеет недостатки. Во-первых, он не отражает самое главное - пользовательский опыт. Внутренние метрики показывают техническое состояние БД, но не всегда коррелируют с тем, как сервис воспринимается конечными пользователями. Во-вторых, не учитывает сетевые задержки. Например, БД может отвечать быстро, но клиент получает данные с задержкой из-за проблем в сети. Ну и плюс к этому накладывается сложность интерпретации. Например, рост времени выполнения запросов может быть вызван как проблемами в самой БД, так и внешними факторами (нагрузка на сеть, изменения в коде приложения).
🚀 Синтетический мониторинг как решение
Синтетический мониторинг помогает устранить эти недостатки. Вместо пассивного сбора внутренних метрик он активно проверяет доступность и производительность БД с точки зрения приложения.
🔹 Как это работает?
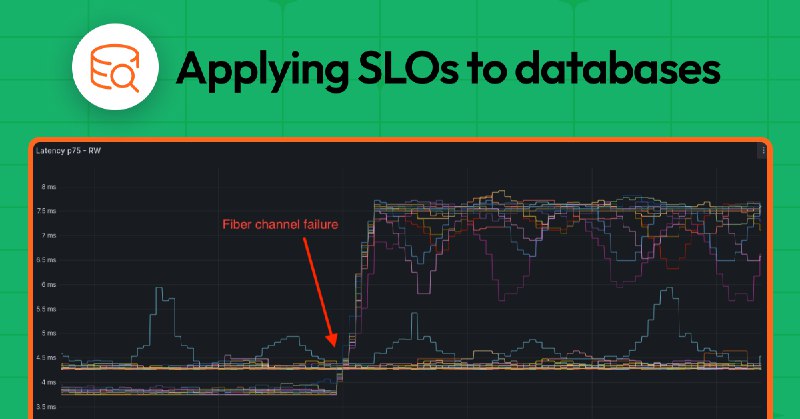
Специальный агент имитирует работу реального клиента, выполняя тестовые SQL-запросы (SELECT, INSERT, UPDATE, DELETE). Фиксируются метрики, такие как общая задержка ответа (включая сетевые задержки) и процент успешных запросов. Запросы выполняются из среды, максимально приближенной к реальному окружению приложений, что дает более точные данные. Автор приводит в пример когда БД и приложение находятся в разных кластерах кубера. В таком случае классический подход к мониторингу будет показывать, что всё хорошо даже если сеть сильно деградировала и клиенты базы данных испытывает сильные задержки.
Преимущества синтетического мониторинга:
- Объективная картина доступности БД – измеряются реальные задержки, включая сетевые.
- Раннее обнаружение проблем – можно выявить деградацию еще до того, как пользователи заметят ухудшение.
- Снижение ложных тревог – если БД работает медленно, но клиенты это не ощущают, инцидент можно не эскалировать.
- Подходит для SLO – позволяет определить уровень доступности БД с точки зрения пользователей, что важно при работе с SLO.
Про инструментарий советую почитать в оригинальной статье. Ссылка в начале статьи.
--
В общем, буду пробовать.
Всем хороших выходных!
Post #13
63