کانال تخصصی SQLSERVERافزایش کارایی دیتابیس با استفاده از نرم افزار DB Optimizer: دانلود ویدوئو آموزشی این نرم افزار که توسط Pinal Dave توضیح داده شده: http://en.savefrom.net/#url=http://youtube.com/watch?v=tI-c13KSH4U&feature=youtu.be&utm_source=youtube.com&utm_medium=short_d…
کانال تخصصی SQLSERVERافزایش کارایی دیتابیس با استفاده از نرم افزار DB Optimizer: دانلود ویدوئو آموزشی این نرم افزار که توسط Pinal Dave توضیح داده شده: http://en.savefrom.net/#url=http://youtube.com/watch?v=tI-c13KSH4U&feature=youtu.be&utm_source=youtube.com&utm_medium=short_d…
و اما مشکل بعدی Heap: میدونین که یکی از مشکلاتی که برای جدولمون داریم وجود Fragmentation و یا گسستگی بین داده ای جدول و به عبارتی پشت سر هم نیون صفحات ائن هستش. خوب توی جدول Clustered ما با وجود امکان Rebuild و یا Reorganize که امکان انجام Online اون هم وجود داره. میتونیم این مشکل رو حل کنیم اما توی جدول Heap برای حل کردن مشکل Forwarding Pointer یکی از روش ها Rebuild کردن جدول هستش، اما دقت کنید با Rebuild کردن جدول Heap کلیه ایندکس های نان کلاستر موجود در جدول مجددا ایجاد می شوند و این باعث پرهزینه شدن عملیات Rebuild می شود!!!
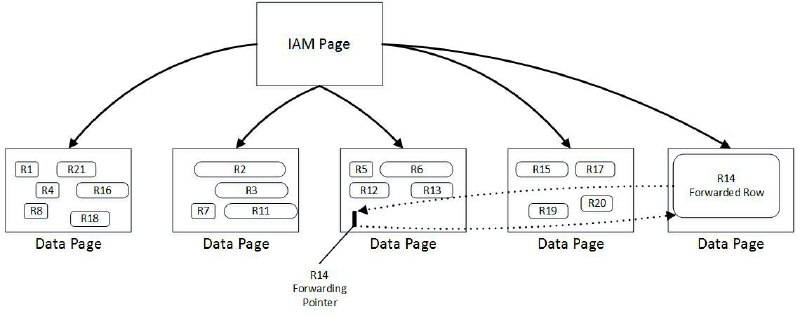
عملیات خواندن اضافه به دلیل وجود Forwarding Pointer. علی رغم اینکه جدول ما دارای 3 صفحه هستش، اما تعداد Read برابر با 5 تا هستش دقت کنید در تعداد بالای صفحه، تعداد این خواندن های اضافی قابل توجه اه
با یک نگاه سطحی، می بینید که توی حالت اول قرار دادن دوچرخه ها (Insert) خیلی راحته. هر جایی شد دوچرخه میندازی و ... اما توی حالت دوم، بایستس دوچرخه رو براسا نظم ونظام خاصی قرار بدیم. اما زمان برداشت دوچرخه (Read) خوب مشخصا، توی حالت دوم (Clustered ) خیلی راحت تر میتونیم دو چرخه رو پیدا کنیم و ... این یک توضیح اولیه. اما اگر بخوایم تفائت ها رو حرفه ای تر بررسی کنیم، یک موردش Forwarding Pointer هست که توسط دوستمون Hamid اشاره شد. زمانی که توی جدول هیپ شما رکوردی رو به روز می کنین و به واسطه افزایش حجم، جای اون رکورد دیگه توی صفحه مربوطه نباشه، SQL اون رکورد رو به صفحه ای جدید منتقل و یک Pointer از صفحه قدیمی به صفحه جدید حاوی رکورد ایجاد می کنه ( چون توی Heap بین صفحات لینک وجود نداره) . حالا مشکل کجا پیش میاد؟؟؟ زمانی که شما میخواین رکوردها رو بخونین، وقتی میرسه به صفحه دارای Pointer مجبوره بره یه صفحه جددی که رکورد مربوطه در اون هست، اون رکورد رو بخونه و مجدد برگرده به صفحه ای که در اون بوده و در ادامه مجددا صفحه ای که قبلا خونده شده رو بازخوانی میکنه. این مورد رو در شکل زیر بهتر متجوه خواهید شد:
#سؤال: جدول هیپ (Heap ) چیست؟ مزایا و معایبش چیه؟ چرا همیشه توصیه میشه از داشتن این جداول توی دیتابیسون پرهیز کنیم؟؟
با تشکر از Hmaid , MOhsen که موارد جامع و خوبی رو در گروه اشاره کردند. پس اگر یک جدول فاقد ایندکس کلاستر (Clustered Index) باشه بهش میگیم هیپ (Heap) پس دقت کنید یک جدول اگر چندین ایندکس نان کلاستر داشته باشه، اما فاقد ایندکس کلاستر باشه هیپه ( باز معادل همون تعریف اوله !!!) خوب زمانی که شما برای جدولتون Clustered Index ایجاد میکنین، رکوردهاتون به ترتیب کلدی ایندکس روی دیسک قرار می گیرین، در این حالت جدول شما رو بهش میگی Clustered دیگه هیپ نیست. در جدول هیپ رکرودها بر اسا نظم و ترتیب خاصی توی جدول قرار نمی گیرند ( به همین دلیل بهش هیپ یا پشته می گیم ) اما توی جدول Clusterewd باید الزاما رکوردها براسا ترتیب (صعودی/نزولی) کلید ایندکس توی جدول (ساختار B-Tree) قرار بگیرند. با شکل زیر مفهوم هیپ و Clustered رو بهتر متوجه خواهید شد: 👇👇👇