TGViewer
Channel Public Channel
SQL Portal | Базы Данных

SQL Portal | Базы Данных

@sqlportal

Присоединяйтесь к нашему каналу и погрузитесь в мир баз данных

Связь: @devmangx

РКН: https://clck.ru/3H4Wo3
Subscribers
13.7K
Photos
1.1K
Videos
142
Links
808

Showing posts older than #2060 · Back to latest

Older Posts 20 shown
Post #2059 1.14K
Шпаргалка по системному дизайну для собеседований

Если ты хочешь уверенно пройти системное интервью в Google, Meta, Amazon или Netflix — тебе сюда

Автор собрал шпаргалку с ключевыми концептами, книгами и курсами для подготовки

⏩Архитектура масштабируемых систем
⏩Балансировка нагрузки, кэширование, очереди (Kafka, Redis)
⏩SQL vs NoSQL, шардирование, репликация
⏩REST vs gRPC, WebSockets, CDN
⏩CQRS, event-driven, микросервисы vs монолит
⏩Надёжность: circuit breaker, leader election (Raft, Paxos)
⏩Безопасность: OAuth, JWT, rate limiting

—> Полный гайд тут

👉 @SQLPortal
  • ❤ 1
Post #2058 1.06K
SQL Debugging: вопрос с собеседования

Этот запрос должен возвращать всех клиентов, а также их отправленные заказы, если они есть.

Что с ним не так? Сработает ли такой запрос? Если нет, как его исправить?

👉 @SQLPortal
  • 👍 2
Post #2057 1.21K
Наткнулся на интересный кейс на Хабре — DBA с 15-летним опытом решил создать собственную систему мониторинга СУБД.

Так появился Lumen — инструмент для мониторинга SQL Server и PostgreSQL, вдохновлённый Spotlight for SQL Enterprise.

Он собирает данные о сессиях, блокировках, запросах, планах выполнения, памяти, дисках, бэкапах и репликации. Есть Playback для разбора прошлых инцидентов, 100 встроенных правил алертов и отдельный AI Operator на базе локальной LLM, который следит за состоянием серверов и помогает разбирать возникающие проблемы.

Выглядит как довольно интересный проект для DBA и тех, кто плотно работает с базами данных.

https://habr.com/ru/articles/1080080/

👉 @SQLPortal
  • 👍 3
Post #2056 1.2K
Бесплатная книга по Deep Learning

Один из самых лучших учебников по глубокому обучению теперь доступен бесплатно в онлайн-формате. Внутри вас ожидает материал по нейронным сетям, компьютерному зрению, Keras, Transformers, генеративному ИИ.

Каждый раздел здесь сопровождается практическими примерами, а сам код можно запускать прямо в браузере через Google Colab.

👉 @SQLPortal
  • ❤ 1
Post #2054 1.29K
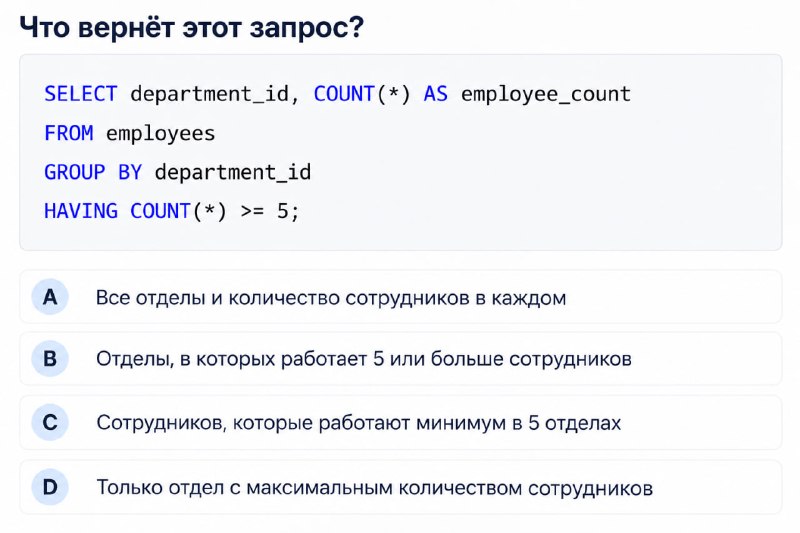
SQL-вопрос:

Что вернёт этот запрос?

👉 @SQLPortal
  • ❤ 2
  • 🤔 1
  • 💊 1
Post #2053 1.33K
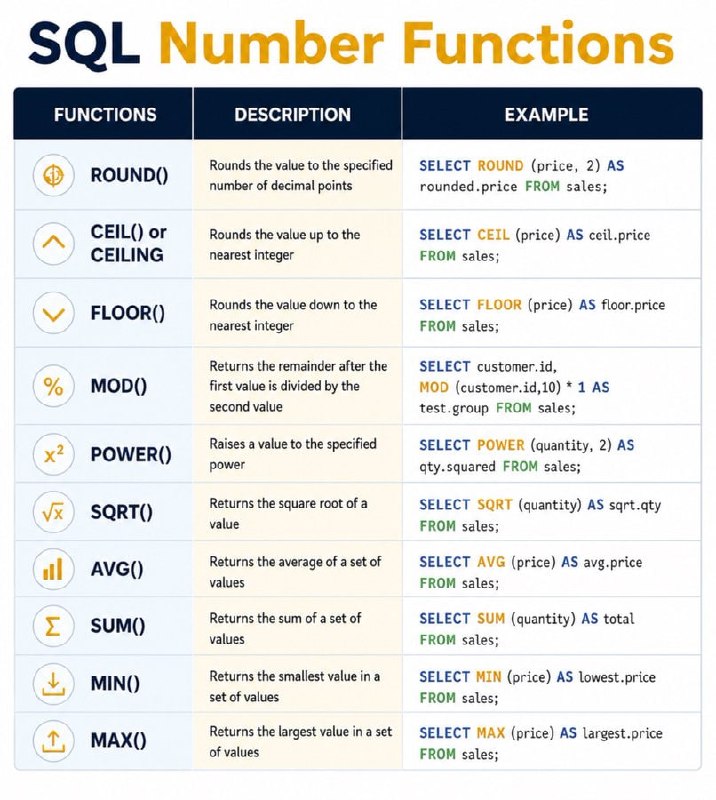
SQL number functions помогают очищать, вычислять и агрегировать числовые данные: округлять значения, задавать границы, находить остаток от деления, возводить числа в степень и сравнивать итоговые значения с помощью AVG, SUM, MIN и MAX.

👉 @SQLPortal
  • ❤ 3
Post #2052 1.25K
Как импортировать большой dump mysql-dump.sql.gz размером более 10 ГБ?

gunzip < mysql-dump.sql.gz | mysql -u <user> -p <database>


Этот вариант работает медленно. Некоторые говорят, что подход на картинке быстрее. Так ли это?

Вопрос: как добавить SQL statements в начало и конец dump прямо во время выполнения импорта?

#MySQL #DBA Tips

👉 @SQLPortal
  • 👍 1
Post #2051 1.28K
БОЛЬШОЙ SQL-ГРЕХ

Использовать операторы NOT IN или IN, когда в данных присутствует NULL.

В SQL оператор IN — это сокращённая запись нескольких условий OR, а сравнение value = NULL всегда возвращает UNKNOWN. Из-за этого запрос может вернуть неожиданный результат или вообще пустую выборку.

Если нужно учитывать NULL, обрабатывайте его явно. Добавьте условие IS NULL к IN или используйте другой подход, корректно учитывающий NULL.

Всегда тестируйте SQL-запросы с NULL, чтобы убедиться, что они работают так, как ожидается.

👉 @SQLPortal
  • 👍 6
  • ❤ 1
Post #2050 1K
pg_cron — это расширение PostgreSQL, которое запускает задачи по расписанию прямо внутри базы, используя стандартный синтаксис cron. Если ты пишешь фоновые джобы, которые в основном сводятся к SQL-запросам, проще отдать это Postgres’у через pg_cron. Получается проще, стабильнее и без внешнего планировщика.

Настройка
В managed PostgreSQL (например, Crunchy Bridge и похожие провайдеры) pg_cron обычно уже доступен.
Если поднимаешь Postgres сам, ставишь пакет:
sudo apt install postgresql-18-cron


Дальше подключаешь расширение при старте сервера через postgresql.conf:
shared_preload_libraries = 'pg_cron'
cron.database_name = 'postgres'


shared_preload_libraries
обязателен — без него расширение не загрузится.

Как работает
По умолчанию задачи выполняются в той базе, где создано расширение.
Можно явно указать другую базу через cron.schedule_in_database.
Задачи выполняются от имени роли, которая их создала. Значит, права на таблицы и команды берутся из этой роли.

Создание задач
Основная функция — cron.schedule. У неё несколько перегрузок, поведение зависит от количества аргументов.

Типичный вариант из трёх частей:
имя задачи
cron-расписание
SQL-команда

Пример:
SELECT cron.schedule(
'nightly_vacuum',
'0 3 * * *',
'VACUUM ANALYZE big_table'
);


Управление и мониторинг
Список задач лежит в cron.job.

Там есть:
имя
расписание
SQL
активна ли задача

История запусков — cron.job_run_details.

Там видно:
время старта
длительность
успех или ошибка

Повторов при ошибке нет. Задача просто логируется и ждёт следующего запуска.

Частые кейсы
чистка старых логов
nightly VACUUM для горячих таблиц
агрегация метрик по часам
перенос старых строк в архив
обновление materialized views

Реже используемые сценарии
Иногда pg_cron используют не только для базы:
батчинг запросов к внешним API (в связке с http)
ETL-процессы и выгрузка в data warehouse (например, через pg_lake)
прогрев кэша через pg_prewarm перед пиками нагрузки

👉 @SQLPortal
  • ❤ 2
  • 👍 1
Post #2049 1.23K
Избегать SQL — значит избегать настоящего бэкенда.

API меняются.
Фреймворки уходят в историю.
Базы данных переживают миграции, переписывания и смену стека.

Большинство проблем с производительностью на бэкенде возникают не из-за медленного кода приложения.

Обычно виноваты:

* плохие запросы;
* отсутствующие индексы;
* неудачная схема БД;
* слабая модель данных;
* неправильные паттерны чтения и записи.

Отсутствующий индекс не лечится микросервисами.

Дублирование данных не исправляется кэшем.

Медленные отчёты не ускоряются переписыванием API.

Если ты не понимаешь ACID, уровни изоляции, блокировки, дедлоки, индексы, партиционирование и планы выполнения запросов, рано или поздно система начнёт разваливаться под нагрузкой.

SQL — это не опция.

Хорошее знание SQL делает тебя сильнее в проектировании систем, распределённых системах, производительности и надёжности.

Изучи SQL.

Всё остальное строится поверх него.

👉 @SQLPortal
  • 👍 5
Post #2047 1.28K
Вопрос по SQL:

Что вернёт этот запрос?

👉 @SQLPortal
  • ❤ 1
Post #2046 1.41K
Немного разобрался с тем, как работают блокировки в PostgreSQL. Главный вывод: разные SQL-команды захватывают разные режимы блокировок, и многие из них специально сделаны совместимыми друг с другом, чтобы минимизировать конкуренцию за блокировки.

Даже обычный SELECT захватывает блокировку, которая препятствует выполнению некоторых «тяжёлых» операций (например, VACUUM FULL, REINDEX и т. п.). Оказалось, существует удивительно много сочетаний SQL-команд, которые могут или не могут выполняться одновременно.

И ещё: вот отличный сайт, который наглядно показывает в виде графа, какие SQL-команды могут выполняться параллельно.

👉 @SQLPortal
  • 👍 3
  • ❤ 1
Post #2045 1.26K
Системный дизайн: База данных

По мере роста числа пользователей одного сервера, на котором размещены веб-уровень и уровень данных, становится недостаточно. Поэтому нам потребуется несколько серверов:

- один для обработки веб- и мобильного трафика — веб-уровень (web tier);
- другой для базы данных — уровень данных (data tier).

Разделение серверов, обрабатывающих веб- и мобильный трафик, и серверов базы данных позволяет масштабировать эти уровни независимо друг от друга.

Какую базу данных использовать?

Можно выбрать между традиционной реляционной базой данных — RDBMS, или SQL-базой данных — и нереляционной базой данных — NoSQL.

Реляционные базы данных представляют и хранят данные в виде таблиц и строк. С помощью SQL можно выполнять операции JOIN между различными таблицами базы данных.

Нереляционная база данных может быть подходящим выбором, если:

- приложению требуется сверхнизкая задержка;
- данные неструктурированы или не имеют связей;
- требуется только сериализация и десериализация данных — JSON, YAML и т. д.;
- необходимо хранить огромные объёмы данных.

👉 @SQLPortal
  • ❤ 1
  • 👍 1
Post #2044 1.24K
Почему в PostgreSQL так любят numeric — большой разбор одного из самых распространённых типов для хранения денежных значений.

Автор сравнивает numeric с bigint и double precision, разбирает точность вычислений, округление и хранение денег, а заодно смотрит, какие подходы используют PostgreSQL, SQL Server, MySQL, платёжные системы и крупные ERP.

Полезный материал, чтобы разобраться, когда действительно нужен numeric, а когда можно обойтись целыми числами — и почему float для финансовых расчётов может стать плохой идеей.

https://habr.com/ru/companies/tantor/articles/1070300/

👉 @SQLPortal
  • ❤ 2
  • 👀 1
Post #2043 1.14K
Забираем годный репозиторий для тех, кто хочет разобраться в SQL глубже — здесь на практике показывают, как работают уровни изоляции транзакций в разных СУБД.

На конкретных SQL-примерах разбираются Lost Update, Read Skew, Write Skew и другие проблемы конкурентных транзакций. Можно сравнить поведение PostgreSQL, MySQL, SQL Server, Oracle, CockroachDB и других баз.

Отличный способ наконец понять, чем Read Committed отличается от Repeatable Read и Serializable не только в теории.

https://github.com/ept/hermitage

👉 @SQLPortal
  • ❤ 2
  • 👍 1
Post #2042 1.26K
Один из самых умных трюков для защиты данных, которые я видел в продакшене?

—> Временной RLS (Temporal RLS)

Row-Level Security — это функция PostgreSQL, позволяющая управлять тем, какие строки может видеть пользователь, прямо на уровне базы данных.

Вместо того чтобы фильтровать данные в коде приложения, RLS переносит контроль доступа в саму БД

Представь себе WHERE, который всегда включён — и индивидуален для каждого пользователя или роли.

Пример использования:

Финтех-компании нужно было дать аналитикам доступ к транзакциям, но с задержкой в 24 часа, чтобы снизить риск мошенничества и инсайдерской торговли

Вместо написания логики в приложении или BI-инструменте, они полностью реализовали это на уровне базы данных.

Как?

1. Включили RLS на таблице

2. Определили политику фильтрации строк

3. Включили принудительное применение RLS для всех обращений (необязательно, но рекомендуется)

Даже если кто-то подключится к базе напрямую через psql, BI-инструмент или SQL-клиент — он увидит только строки, старше 24 часов. Без исключений.

⏩Безопасность обеспечивается у источника

⏩Политики версионируются вместе со схемой

⏩Код приложения не участвует

Вывод:

RLS — это не только про фильтрацию арендаторов. С его помощью можно строить умные правила: задержка по времени, доступ по пользователям, мягкое удаление — и всё это реализуется самой БД

👉 @SQLPortal
  • ❤ 5
  • 👍 1
Post #2041 1.2K
Опытные коллеги здесь? 👀

👉 @SQLPortal
  • 😁 6
Post #2040 1.35K
Приложения и базы данных, которые стоят за ними.

Instagram — PostgreSQL
Reddit — PostgreSQL
Twitch — PostgreSQL
Notion — PostgreSQL
Figma — PostgreSQL
ChatGPT — PostgreSQL
Skype — PostgreSQL

GitHub — MySQL
Shopify — MySQL
Slack — MySQL
YouTube — MySQL
Uber — MySQL
Airbnb — MySQL
Facebook — MySQL

Netflix — Cassandra

Discord — ScyllaDB

Забавно, насколько большая часть крупнейших сервисов в мире до сих пор держится на PostgreSQL и MySQL.

👉 @SQLPortal
  • ❤ 6
  • 🔥 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →