
Долгое время полнотекстовый поиск считался одной из слабых сторон Postgres. Если требовался качественный поиск с ранжированием по релевантности, обычно приходилось разворачивать Elasticsearch, подключать Algolia или использовать другие внешние сервисы, постоянно синхронизируя данные.
Проблема была не в том, что PostgreSQL не умеет искать по тексту. Умеет. Но встроенная функция
ts_rank использует относительно простой алгоритм ранжирования, который уступает современным поисковым движкам.Из-за этого многие команды были вынуждены:
• Поднимать отдельный кластер Elasticsearch только ради поиска.
• Поддерживать пайплайны синхронизации данных между системами.
• Платить за управляемые поисковые сервисы.
• Мириться с не самым качественным ранжированием результатов.
Теперь появилась альтернатива —
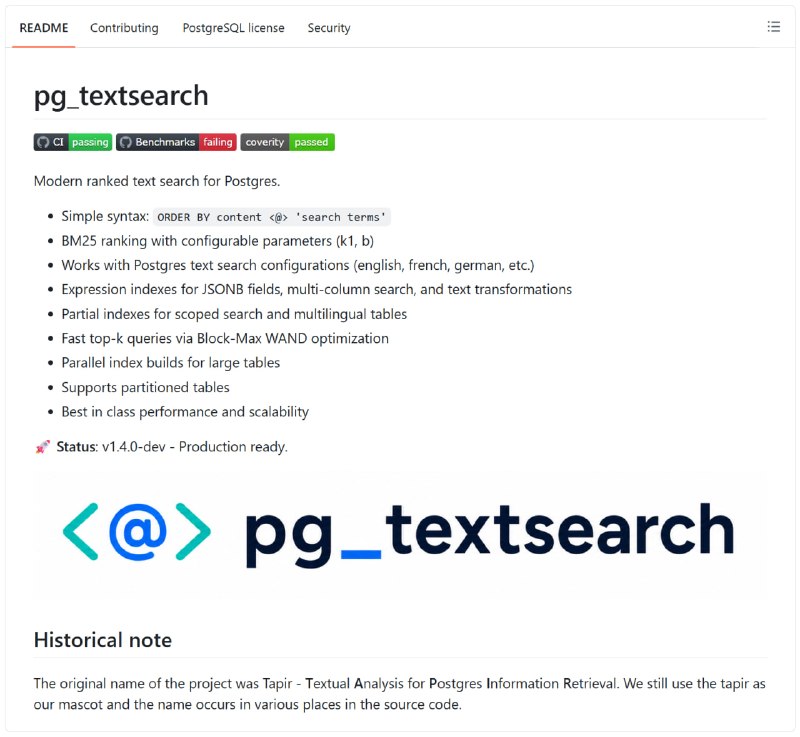
pg_textsearch, новое open-source расширение для PostgreSQL от TigerData.Что оно предлагает:
• Поддержку алгоритма BM25 — того самого, который используется в Elasticsearch, Lucene и большинстве современных поисковых систем.
• Простой SQL-синтаксис для поиска:
ORDER BY content <@> 'search terms'
• Совместимость с конфигурациями полнотекстового поиска PostgreSQL для разных языков.
• Возможность объединить поиск по ключевым словам и векторный поиск через
pgvector, что особенно полезно для RAG-приложений.Расширение распространяется с открытым исходным кодом по лицензии PostgreSQL и позволяет реализовать современный поиск прямо внутри Postgres, без необходимости использовать отдельную поисковую инфраструктуру.
https://github.com/timescale/pg_textsearch
👉 @SQLPortal