TGViewer
Channel Public Channel
Data Science. SQL hub

Data Science. SQL hub

@sqlhub

По всем вопросам- @workakkk

@itchannels_telegram - 🔥лучшие ит-каналы

@ai_machinelearning_big_data - Machine learning

@pythonl - Python

@pythonlbooks- python книги📚

@datascienceiot - ml книги📚

РКН: https://vk.cc/cIi9vo

#VRHSZ
Subscribers
36K
Photos
1.2K
Videos
99
Links
1.2K

Showing posts older than #1025 · Back to latest

Older Posts 19 shown
Post #1023 3.99K
💻Распространённые ошибки в составлении SQL запросов

▶️Использование SELECT *

- Проблема: Выбор всех столбцов с помощью SELECT * приводит к передаче ненужных данных, увеличению использования памяти и снижению производительности запросов.
- Решение: Укажите в операторе SELECT только необходимые столбцы.

-- Пример проблемы
SELECT * FROM employees;

-- Улучшенный запрос
SELECT employee_id, first_name, last_name FROM employees;


▶️Отсутствие индексации

- Проблема: Отсутствие индексов может привести к полному сканированию таблицы и снижению производительности запросов.
- Решение: Создайте и используйте индексы для часто используемых в выражениях WHERE столбцов.

-- Создание индекса
CREATE INDEX idx_last_name ON employees(last_name);

-- Использования индекса в запросе
SELECT * FROM employees WHERE last_name = 'Smith';


▶️Чрезмерное использование подзапросов

- Проблема: Подзапросы могут работать медленнее, чем JOIN, особенно при работе с большими наборами данных.
- Решение: Используйте JOIN, когда это возможно, а подзапросы оставьте для ситуаций, в которых они более эффективны.

-- Пример проблемы (подзапрос)
SELECT department_name FROM departments WHERE department_id IN (SELECT department_id FROM employees);

-- Улучшенный запрос (JOIN)
SELECT DISTINCT d.department_name FROM departments d JOIN employees e ON d.department_id = e.department_id;


▶️Неэффективные JOIN

- Проблема: Выбор неправильного типа JOIN (например, Cartesian JOIN) или неправильное указание условий соединения может привести к неправильным результатам или замедлению запросов.
- Решение: Разберитесь в различных типах JOIN (INNER, LEFT, RIGHT, FULL) и используйте их по назначению.

-- Пример проблемы (Cartesian JOIN)
SELECT * FROM employees, departments;

-- Улучшенный запрос (INNER JOIN)
SELECT e.employee_name, d.department_name FROM employees e
INNER JOIN departments d ON e.department_id = d.department_id;


▶️Неиспользование выражений WHERE

- Проблема: Отсутствие фильтрации данных с помощью выражений WHERE может привести к запросу ненужных данных.
- Решение: Всегда включайте выражения WHERE, ограничивающие набор результатов.

-- Пример проблемы (без выражения WHERE)
SELECT * FROM orders;

-- Улучшенный запрос (с выражением WHERE)
SELECT * FROM orders WHERE order_date >= '2023-01-01';


▶️Игнорирование планов выполнения запросов

- Проблема: Игнорирование планов выполнения запросов может привести к упущенным возможностям оптимизации.
- Решение: Используйте такие инструменты, как EXPLAIN, для анализа планов выполнения и внесения необходимых оптимизаций.

-- Просмотр плана выполнения
EXPLAIN SELECT * FROM products WHERE category = 'Electronics';


▶️Отсутствие оптимизации больших наборов данных

- Проблема: Запросы, хорошо работающие с небольшими наборами данных, могут плохо работать с большими объёмами данных.
- Решение: Реализуйте такие стратегии, как пагинация, разбиение данных на разделы и оптимизация индексов для больших наборов данных.

-- реализация пагинации
SELECT * FROM products LIMIT 10 OFFSET 20;


▶️Повторяющиеся агрегации

- Проблема: Повторение одних и тех же агрегаций в нескольких частях запроса может быть неэффективным.
- Решение: Используйте CTE (Общие табличные выражения) для хранения промежуточных результатов и избегайте лишних вычислений.

-- Пример проблемы (повторяющаяся агрегация)
SELECT department, SUM(salary) AS total_salary FROM employees GROUP BY department;

-- Улучшенный запрос (с CTE)
WITH DepartmentSalaries AS (
SELECT department, SUM(salary) AS total_salary FROM employees GROUP BY department
)
SELECT * FROM DepartmentSalaries;


▶️Неадекватная обработка ошибок

- Проблема: Неправильная обработка ошибок может привести к сбоям в работе приложения или неправильным результатам.
- Решение: Реализуйте надлежащую обработку ошибок в SQL запросах или в коде приложения.

-- Пример обработки ошибок в SQL (MySQL)
BEGIN;
-- SQL выражение
IF some_condition THEN
ROLLBACK; -- Откат транзакции при ошибке
ELSE
COMMIT; -- Коммит транзакции при успешном выполнении всех выражений
END IF;


@sqlhub
  • 👍 40
  • ❤ 9
  • 🔥 5
  • 👎 2
Post #1021 4.16K
💻 BEGIN, COMMIT, ROLLBACK (работа с транзакциями)

⏩Транзакции – это способ группировки одной или нескольких операций с базой данных в единую единицу работы. Транзакция может состоять из одной или нескольких SQL-операций и использоваться для обеспечения согласованности данных. Транзакция обеспечивает гарантированное выполнение либо всех входящих в неё SQL-операций, либо ни одной. Транзакции управляются командами BEGIN, COMMIT, ROLLBACK.

⏩Транзакции выполняются внутри сессий. Сессия — это одно соединение с базой данных, которое начинается при подключении к базе данных и завершается при её отключении. Транзакция начинается с команды BEGIN и завершается командой COMMIT (успешное завершение) или ROLLBACK (откат). Указывать BEGIN, COMMIT и ROLLBACK не обязательно, часто их использование подразумевается неявно. В случае если сессия неожиданно прерывается, тогда все транзакции, которые были начаты в текущей сесcии – автоматически откатываются.

⏩Подробнее:
— BEGIN – инициирует новую транзакцию. После выполнения этой команды все последующие операции с базой данных будут выполняться в рамках этой транзакции.
— COMMIT – завершает текущую транзакцию, применяя все её операции. Если все операции в транзакции были успешными, результаты этих операций фиксируются (становятся постоянными). Изменения становятся видны последующим транзакциям.
— ROLLBACK – откатывает текущую транзакцию, отменяя все её операции, если в процессе выполнения транзакции возникли ошибки или отмена транзакции производится приложением исходя из внутренней логики работы.

⏩Если данные, внесённые с помощью транзакции на изображении верны – нужно выполнить инструкцию подтверждения транзакции:
COMMIT;


📎 Читать подробнее

@sqlhub
  • 👍 25
  • ❤ 4
  • 🔥 3
Post #1020 4.3K
Как правильно подставлять значения из переменных / списков / словарей в SQL запрос в Python?

⏩Лучше всего использовать SQL запросы с использованием параметров:
cursor.execute("SELECT * FROM my_table WHERE id = ?", [123])
# parameter placeholder ------------------------> ^
# список/кортеж со значениями параметров -----------> ^^^^^


⏩Какие преимущества приносит использование параметров?
— Защита от SQL-инъекций

— Правильное квотирование литералов в зависимости от их типа (пример со строками, пример с датами).

— Оптимизация — сокращение времени работы SQL запроса. Благодаря использованию параметров следующие шаги не выполняются при повторном запуске (зависит от БД):
— проверка синтаксиса SQL запроса
— проверка прав доступа к объектам БД
— построение плана выполнения SQL запроса

— Защита от переполнения/вытеснения кеша SQL запросов. Например "безобидный" запрос qry = f"SELECT first_name, last_name FROM users WHERE id = {user_id}", который часто выполняется в нагруженной системе с различными значениями user_id может вытеснить из кеша запросов полезные запросы.

⏩ Пример использования параметров в SQL запросе:
import sqlite3

con = sqlite3.connect(":memory:")
cur = con.cursor()
cur.execute("create table lang (name, first_appeared)")

cur.execute("insert into lang values (?, ?)", ("C", 1972))

lang_list = [
("Fortran", 1957),
("Python", 1991),
("Go", 2009),
]
cur.executemany("insert into lang values (?, ?)", lang_list)

cur.execute("select * from lang where first_appeared=:year", {"year": 1972})
print(cur.fetchall())

con.close()

При таком подходе можно использовать cursor.executemany() - это значительно быстрее и эффективнее по сравнению с вставкой в цикле по одной строке.

📎 Читать подробнее

@sqlhub
  • 👍 17
  • ❤ 3
  • 🔥 2
  • 😁 1
Post #1017 4.81K
💻 Vitess 19 для кластеризации БД

Состоялся релиз мажорной версии открытого масштабируемого решения для кластеризации баз данных MySQL — Vitess 19.
В этой версии разработчики добавили улучшения, направленные на оптимизацию масштабируемости, производительности и удобства использования с базами данных.

Изменения и дополнения в Vitess 19:
⏩прекращение поддержки MySQL 5.7. Разработчики советуют пользователям выполнить обновление до MySQL 8.0, используя Vitess 18, прежде чем переходить на Vitess 19. Однако Vitess 19 по-прежнему будет поддерживать импорт из MySQL 5.7;
⏩добавлены новые метрики для консолидации потоков и версия сборки в /debug/vars, чтобы обеспечить более глубокое понимание и отслеживаемость;
⏩улучшена совместимость запросов, реализована поддержка операций удаления из нескольких таблиц, новый запрос SHOW VSCHEMA KEYSPACES и несколько других улучшений синтаксиса SQL, которые расширяют совместимость Vitess с MySQL;
⏩поддержка отсрочки попыток переключения в случае блокировки. Поддержка принудительного отключения;
⏩улучшение процесса инкрементного резервного копирования: поддержка имён резервных копий и пустых резервных копий.

«Следуя тенденции последних трёх лет, новая версия Vitess быстрее предыдущей во всех тестах, которые мы отслеживаем в Arewefastyet. Мы исправили несколько проблем с производительностью, доработали интерфейс и код», — пояснили разработчики, порекомендовав изучить документацию проекта и список исправлений.

🖥 Исходный код проекта опубликован на GitHub под лицензией Apache License 2.0.

@sqlhub
  • 👍 9
  • ❤ 2
  • 🔥 1
Post #1015 4.66K
💻AlPort опубликовал наиболее полный рейтинг генеративных технологий, который учитывает локальные особенности продуктов

В рейтинг попали самые перспективные разработки в сфере генеративного искусственного интеллекта по ключевым категориям. Туда попали сразу две нейросетки от Яндекса — текстовая YandexGPT и мультимодальная YandexART. Также Яндекс вместе с Stability AI, Open AI, Google, Microsoft, Tencent и Baidu стал одной из 11 компаний со всего мира, которые разрабатывают более одного типа GenAI-моделей.

📎 Статья

@sqlhub
  • 👍 7
  • ❤ 5
  • 🔥 3
  • 🤬 1
Post #1013 4.97K
SQL_cheatsheet.png971 KB
💻 Cheatsheet SQL

Шпаргалок по SQL много не бывает, так что держите, полезно освежить перед собеседованием

Здесь освещаются самые основные операторы, такие как JOIN, IN, LIKE, BETWEEN, ORDER BY, а также много всего ещё
Пользуйтесь)

@sqlhub
  • 🔥 20
  • ❤ 10
  • 👍 2
  • 🎉 1
Post #1011 5K
💻 Зачем нужен SELECT ... FOR UPDATE?

▶️Итак, ответ. Пока у вас транзакции следуют строго одна за другой - у вас всё хорошо и нет проблем. Кроме производительности. А чтобы улучшить производительность — необходимо разрешить транзакции выполнять параллельно. И вот тут начинается богатый и поразительный мир concurrently control. При том, не только в БД, а везде где хоть что-то выполняется параллельно.

Допустим есть пользователь, у него есть 100 денег на счету. Пользователь может их тратить, вы проверяете баланс SELECT balance ..., затем обновляете баланс при покупке UPDATE ... SET balance = ? WHERE .... И вот в счастливый день как-то так вышло, что приходят сразу 2 запроса на покупки для этого пользователя. Одна на 50 денег, вторая на 70. Одна из них должна быть отклонена, т.к. денег недостаточно. Но в результате получается что обе покупки прошли и у вас проблема, вы продали то, что не надо было. И это даже не видно по балансу пользователя. Как же?

Это типичный race condition, обе транзакции сначала данные читают, потом локально что-то делают, потом что-то пишут.
⏩читать им никто не мешает, потому обе транзакции прочитали что у пользователя 100 денег
⏩обе транзакции закономерно решили что денег достаточно
⏩обе транзакции обновили баланс пользователя
При конкурентном доступе к ресурсу подрались только на последнем шаге, транзакция которая начала обновлять данные позже сначала подождала завершение первой транзакции. А затем банально перезаписала баланс на тот который считала правильным сама — lost update аномалия.

▶️Вот как раз для того чтобы предупредить СУБД о том, что мы планируем с данными что-то делать, а потому нам надо сериализовать транзакции иначе, и существует FOR SHARE, FOR UPDATE дополнения. Потому они кстати и задокументированы в разделе Explicit Locking

📎 Подробнее прочитать можно тут

@sqlhub
  • ❤ 17
  • 👍 9
  • 🔥 4
  • 👎 1
Post #1009 4.93K
💻SQL в качестве API

📌Интересная статья, которая позволит посмотреть на SQL с другой стороны
Статья обсуждает использование SQL в API для обработки сложных запросов, в результате автор приходит к выводу, что применение SQL в API может быть безопасным и удобным.

📎 Статья

@sqlhub
  • ❤ 7
  • 🔥 4
  • 👍 3
  • 🥰 1
Post #1007 5.06K
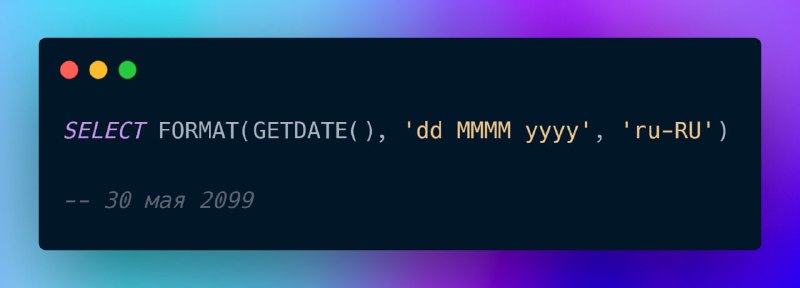
💻Склонение месяцев в SQL

Вроде мелочь, а вполне-таки реальный кейс
В общем, необходимо вносить в договор дату в формате: "30 мая 2099 г."
Эта дата хранится в БД, ее нужно просто подгрузить и нормально отформатировать.
Для этого можно обращаться к месяцу с помощью: LOWER(DATENAME(month, @Tdate)), однако в таком случае получается месяц в именительном падеже - "май".

И тут полезно вспомнить, что форматирование даты с правильными склонениями месяца работает из коробки:
SELECT FORMAT(GETDATE(), 'dd MMMM yyyy', 'ru-RU')

-- 30 мая 2099


@sqlhub
  • 👍 33
  • 🔥 11
  • ❤ 8
  • 🤯 1
Post #1005 4.76K
💻BYTE и CHAR в Oracle: разница, хранение, кодировка

Если в двух словах
Выбор между BYTE и CHAR зависит от кодировки и объема данных, которые вы собираетесь представлять в байтах.
⏩BYTE фиксирует объем данных в байтах и идеален для однобайтовых кодировок, таких как ASCII где каждому символу соответствует один байт. Так, VARCHAR2(10 BYTE) вмещает любую комбинацию из десяти байтов.
⏩CHAR же определяет количество символов, не учитывая их объем в байтах; выбрав VARCHAR2(10 CHAR), вы гарантируете пространство на 10 символов, независимо от их размера в байтах. Для иллюстрации вот простой SQL-пример:
-- BYTE: сохраняет байты
CREATE TABLE bytewise (name VARCHAR2(10 BYTE));

-- CHAR: распределяет пространство с учетом количества символов
CREATE TABLE charwise (name VARCHAR2(10 CHAR));

Если BYTE обеспечивает компактность данных, то CHAR гарантирует гибкость, позволяя сохранять символы различной ширины. Ваш выбор зависит от типов символов, которые вы планируете использовать.


Детали при работе с UTF-8
Важно понимать последствия выбора типа данных при работе с многобайтовыми символами кодировки, такой как UTF-8, где один символ может занимать до 4 байтов.
⏩Если вы опираетесь на BYTE, это может привести к проблемам в системах, поддерживающих много языков.
⏩Для предотвращения потери или обрезки данных CHAR будет более надежной опцией, так как он обеспечивает достаточное пространство для любого символа, независимо от его веса.


Критерии для выбора между BYTE и CHAR:
⏩Однородность данных: Если данные подчиняются стандартному размеру в байтах, особенно в случаях, когда важно экономить место, BYTE будет наилучшим выбором.
⏩Многоязычная поддержка: CHAR выигрывает, когда важна поддержка множества языков, это помогает предотвратить проблемы с несоответствием размера хранения.
⏩Производительность: BYTE может быть быстрее по сравнению с CHAR из-за обработки меньшего объема данных, что делает его подходящим для приложений с высокими требованиями к производительности.

📎 Подробнее про BYTE и CHAR можно прочитать тут

@sqlhub
  • 👍 11
  • ❤ 3
  • 👎 1
  • 🔥 1
Post #1003 5.35K
💻Немного о недавнем обновлении PostgreSQL 16

PostgreSQL 16 вносит немало улучшений в планировщик запросов и позволяет выполнять многие SQL-запросы быстрее, чем в предыдущих версиях PostgreSQL.

Вот некоторые из изменений:
⏩Разрешена инкрементальная сортировка в большем количестве случаев, включая DISTINCT

⏩Добавлена возможность для агрегатов, имеющих ORDER BY или DISTINCT, использовать предварительно отсортированные данные

⏩Разрешена мемоизация в UNION ALL

⏩Разрешено выполнять anti-join с ненулевым входом в качестве внутреннего отношения

⏩Разрешено распараллеливание FULL и RIGHT OUTER хэш-соединения

⏩Разрешено оконным функциям использовать более быстрый режим ROWS, когда режим RANGE активен, но не нужен

⏩Оптимизация постоянно увеличивающихся оконных функций ntile(), cume_dist() и percent_rank()

⏩Разрешено удаление left join и unique joins в секционированных таблицах

⏩Можно использовать Limit вместо Unique для реализации DISTINCT, когда это возможно

⏩Ослаблены слишком строгие правила в select_outer_pathkeys_for_merge()

📎 Статья с подробным описанием улучшений

@sqlhub
  • ❤ 14
  • 👍 8
  • 🔥 3
  • 🤔 2
Post #1002 5.69K
💻Проверка наличия записи в SQL: альтернатива SELECT COUNT(*)

Для того чтобы проверить наличие записи, используйте оператор EXISTS:
IF EXISTS (SELECT 1 FROM ваша_таблица WHERE ваш_столбец = ваше_значение)
PRINT 'Запись существует';
ELSE
PRINT 'Запись не найдена';

Замените ваша_таблица, ваш_столбец и ваше_значение релевантными данными. Этот способ является эффективным для поиска записей.

*️⃣Использование SELECT COUNT(*) для проверки наличия записи может показаться удобным, однако это не всегда эффективный подход, особенно при работе с обширными базами данных.
В MS SQL Server целесообразно использовать SELECT TOP 1 для сохранения ресурсов:
IF EXISTS (SELECT TOP 1 1 FROM ваша_таблица WHERE ваш_столбец = ваше_значение)
PRINT 'Запись существует';

В MySQL и PostgreSQL применяйте LIMIT 1 для ограничения выборки:
SELECT 1 FROM ваша_таблица WHERE ваш_столбец = ваше_значение LIMIT 1;

Такие запросы быстро останавливают выполнение, как только найдено первое соответствие.

*️⃣Миф о SELECT COUNT(*). Несмотря на то что многие СУБД оптимизируют SELECT COUNT(*), в работе не все из них показывают одинаковую эффективность. В случае сомнений используйте EXISTS или LIMIT/TOP.

@sqlhub
  • 👍 27
  • 🔥 6
  • ❤ 3
Post #1001 5.74K
💎 Шпаргалки для всех: сокровищница знаний

Этот ресурс - настоящее сокровище для любого разработчика.

В нем содержится около 6000 разнообразных шпаргалок в виде изображений: от программирования и работы с базами данных до софт-скиллов.

Здесь вы найдете не только классические шпаргалки по регулярным выражениям и SQL, но и информацию о кофейных напитках, командах в Minecraft и французской грамматике.

▪ Смотреть

@sqlhub
  • ❤ 11
  • 👍 6
  • 🔥 2
Post #999 5.58K
💻Методы оптимизации SQL-запросов

1️⃣Использование EXPLAIN для анализа запросов

2️⃣Продвинутые стратегии индексирования
├── Пересмотр покрывающих индексов
├── Частичные индексы для отфильтрованных данных
└── Стратегии индексирования для соединений

3️⃣Переписывание и оптимизация запросов
├── Пересмотр подзапросов к JOIN'ам
├── Общие табличные выражения (CTE) и рекурсивные запросы
└── Ограничение наборов результатов с помощью OFFSET-FETCH

4️⃣Денормализация данных для повышения производительности
├── Выбор кандидатов на денормализацию
├── Создание денормализованных таблиц
└── Баланс между согласованностью данных и производительностью

5️⃣Использование временных таблиц для оптимизации запросов
├── Временные таблицы для промежуточных результатов
├── Создание и наполнение временных таблиц
└── Временные таблицы и агрегации

6️⃣Оптимизация подзапросов и агрегаций
├── Оптимизация подзапросов
└── Оптимизация агрегаций

7️⃣Избегайте курсоров и циклов для повышения производительности
├── Операции на основе множеств
├── Пакетная обработка
└── Оптимизация циклов с помощью операций на основе множеств

Примеры некоторых из этих приёмов

Пересмотр подзапросов к JOIN'ам.
Оригинальный подзапрос:
SELECT * FROM employees
WHERE department_id IN (SELECT department_id FROM departments WHERE region = 'West');

Переписан с использованием JOIN:
SELECT e.* FROM employees e
INNER JOIN departments d ON e.department_id = d.department_id
WHERE d.region = 'West';


Общие табличные выражения (CTE) предоставляют удобный способ упростить сложные запросы и улучшить их читаемость:
WITH RecursiveCTE AS (
SELECT employee_id, first_name, manager_id, 0 AS depth
FROM employees
WHERE manager_id IS NULL
UNION ALL
SELECT e.employee_id, e.first_name, e.manager_id, rc.depth + 1
FROM employees e
INNER JOIN RecursiveCTE rc ON e.manager_id = rc.employee_id
)
SELECT * FROM RecursiveCTE;


➖ Более подробно можно прочитать тут

@sqlhub
  • 👍 27
  • ❤ 5
  • 🔥 3
  • 🤔 1
Post #997 5.37K
💻 Делаем SQL-запросы чище

Периодически в коде запросов и "заточенных" под них индексов наблюдаю примерно подобные куски:
coalesce("Фамилия", '') || ' ' || coalesce("Имя", '') || ' ' || coalesce("Отчество", '')


Понятно, что тут хотели обезопасить себя от заполненности любого из полей NULL-значением, чтобы случайно вся строка не заNULL'илась.

Правда, тут возникают некоторые артефакты в виде "висящих пробелов" типа ' Иван Иванович' или 'Иванов Иван '.

Но ведь есть решение изящнее и проще - функция concat_ws:
concat_ws(' ', "Фамилия", "Имя", "Отчество")


RTFM!

@sqlhub
  • 👍 23
  • 🔥 10
  • ❤ 5
  • 👎 1
Post #996 5.16K
⚡️ Rexi — полезный инструмент для тестирования регулярных выражений прямо из терминала


Инструмент написан Python, на основе библиотеки textual. Он предлагает дружелюбный интерфейс для интерактивной работы с регулярными выражениями.

▪ Поддерживает оценку регулярных выражений в режимах match или finditer.
▪Предлагает мгновенную обратную связь по результатам сопоставления или поиска.

▪Github

@sqlhub
  • ❤ 8
  • 👍 2
  • 🔥 1
Post #994 6K
💻Топ 7 SQL-запросов для очистки данных

1️⃣Удаляем дубликаты записей
DELETE FROM your_table
WHERE rowid NOT IN (
SELECT MAX(rowid)
FROM your_table
GROUP BY column1, column2, ...
);


2️⃣Удаляем строки с NULL-значениями
DELETE FROM your_table
WHERE column1 IS NULL OR column2 IS NULL;


3️⃣Заменяем NULL-значения на дефолтное выражение
UPDATE your_table
SET column1 = 'default_value'
WHERE column1 IS NULL;


4️⃣Переводим текст в верхний регистр
UPDATE your_table
SET column1 = UPPER(column1);


5️⃣Обрезаем лишнее
UPDATE your_table
SET column1 = TRIM(column1);


6️⃣Конвертируем строки в формат дат
UPDATE your_table
SET date_column = TO_DATE(date_string, 'YYYY-MM-DD');


7️⃣Извлекаем год/месяц/день
SELECT EXTRACT(YEAR FROM date_column) AS year,
EXTRACT(MONTH FROM date_column) AS month,
EXTRACT(DAY FROM date_column) AS day
FROM your_table;


Эти запросы могут помочь вам привести датасет в порядок, используйте)

@sqlhub
  • 👍 43
  • 🔥 9
  • ❤ 6
  • 👎 2
  • 🥰 2
Post #992 5.16K
💻Про NOT NULL и NULL в SQL

☑️IS NOT NULL + OR
Иногда внутри SQL-запроса возникает необходимость проверить наличие/отсутствие NULL-значения в некотором наборе полей:
a IS NOT NULL OR b IS NOT NULL OR c IS NOT NULL

Но то же самое по смыслу условие можно записать гораздо короче с помощью функции coalesce:
coalesce(a, b, c) IS NOT NULL


☑️IS NOT NULL + AND
Немного изменим условие - заменим OR на AND:
a IS NOT NULL AND b IS NOT NULL AND c IS NOT NULL

Тут нам поможет ROW-конструктор:
(a, b, c) IS NOT NULL


☑️IS NULL + AND
Теперь заменим IS NOT NULL на IS NULL:
a IS NULL AND b IS NULL AND c IS NULL

Тут достаточно вспомнить из логики, что (A and B) эквивалентно not(not A or not B), а (A or B) - not(not A and not B), поэтому легко применяем not к варианту IS NOT NULL + OR:
coalesce(a, b, c) IS NULL

Или с помощью ROW-конструктора:
(a, b, c) IS NULL


☑️IS NULL + OR
Остался последний вариант:
a IS NULL OR b IS NULL OR c IS NULL

Тут мы можем "обратить" вариант IS NOT NULL + AND:
NOT (a, b, c) IS NOT NULL

Заметьте, что пара NOT тут "не сокращается", иначе получился бы предыдущий вариант.

Подробнее об особенностях работы со сложными выражениями тут — "PostgreSQL Antipatterns: вычисление условий в SQL". И ещё годная статья — "«Ленивый сахар» PostgreSQL"

@sqlhub
  • 👍 18
  • 🔥 10
  • ❤ 5
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →