TGViewer
Channel Public Channel
SQL Ready | Базы Данных

SQL Ready | Базы Данных

@sql_ready

Авторский канал про Базы Данных и SQL
Ресурсы, гайды, задачи, шпаргалки.
Информация ежедневно пополняется!

Cотрудничество: @energy_c

РКН: https://clck.ru/3QREBc
Subscribers
17.5K
Photos
1.4K
Videos
112
Links
759

Showing posts older than #2137 · Back to latest

Older Posts 12 shown
Post #2131 1.8K
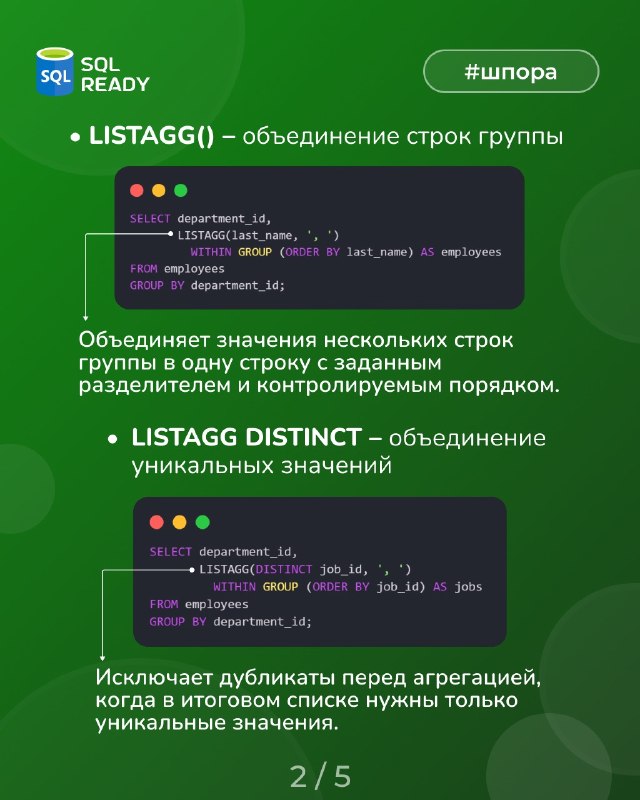
🖥 Oracle — агрегация данных и отчётность!

Шпаргалка по агрегации данных и формированию отчётности в Oracle SQL: объединение значений с LISTAGG, выбор значений по рангу с KEEP (DENSE_RANK FIRST/LAST), построение промежуточных и общих итогов с ROLLUP и GROUPING SETS, а также идентификация уровней агрегации с помощью GROUPING и GROUPING_ID. Полезно для построения сводных выборок, многоуровневых отчётов и обработки агрегированных данных непосредственно средствами SQL.

➡️ SQL Ready | #шпора
  • 👍 10
  • ❤ 6
  • 🤝 4
Post #2130 1.81K
Составные индексы: правила проектирования и типичные ошибки!

Составные индексы используются для ускорения запросов по нескольким колонкам, но порядок полей внутри индекса напрямую влияет на его эффективность.

Представим таблицу заказов, где часто выполняются запросы по пользователю и дате создания заказа.
CREATE TABLE orders (
id BIGSERIAL PRIMARY KEY,
user_id BIGINT NOT NULL,
status VARCHAR(30),
created_at TIMESTAMP NOT NULL,
amount NUMERIC(10,2)
);


Обычный индекс на каждую колонку не всегда является оптимальным решением. СУБД может использовать несколько индексов одновременно, но такой план не всегда будет эффективнее одного правильно спроектированного составного индекса.
CREATE INDEX idx_orders_user
ON orders(user_id);

CREATE INDEX idx_orders_created_at
ON orders(created_at);


Для частого сценария поиска заказов конкретного пользователя за период лучше создать составной индекс:
CREATE INDEX idx_orders_user_created_at
ON orders(user_id, created_at);


Такой индекс эффективно работает для запросов, где используется первая колонка индекса или полный набор колонок.
SELECT *
FROM orders
WHERE user_id = 42
AND created_at >= '2026-01-01';


В B-tree индексе данные сначала сортируются по user_id, а внутри одинаковых значений user_id — по created_at.

Поэтому СУБД быстро находит записи пользователя и затем выполняет поиск по диапазону дат. Также индекс будет использоваться:
SELECT *
FROM orders
WHERE user_id = 42;


Но он плохо подходит для поиска только по второй колонке:
SELECT *
FROM orders
WHERE created_at >= '2026-01-01';


Причина в структуре B-tree: данные сначала организованы по первой колонке индекса.

Для такого запроса отдельный индекс по дате будет более подходящим:
CREATE INDEX idx_orders_created_at
ON orders(created_at);


Ещё одна распространённая ошибка — добавление большого количества колонок в индекс.
CREATE INDEX idx_orders_all_columns
ON orders(user_id, status, created_at, amount);


Каждый дополнительный столбец увеличивает размер индекса и стоимость операций записи.

Перед созданием индекса нужно анализировать реальные запросы приложения, а не добавлять поля на всякий случай.
EXPLAIN ANALYZE
SELECT *
FROM orders
WHERE user_id = 42
AND status = 'paid'
ORDER BY created_at DESC;


Для такого запроса может быть эффективнее индекс, учитывающий фильтрацию и сортировку:
CREATE INDEX idx_orders_user_status_created_at
ON orders(user_id, status, created_at DESC);


Правильно спроектированный составной индекс уменьшает количество операций чтения, снижает нагрузку на CPU и помогает оптимизатору выбрать более дешёвый план выполнения.

🔥 Главное правило простое: индекс создаётся под реальные запросы приложения, а не просто под структуру таблицы.

➡️ SQL Ready | #практика
  • 👍 12
  • ❤ 8
  • 🤝 5
Post #2129 1.78K
Оконный фрейм по группам значений!

ROWS считает физические строки. GROUPS считает группы строк с одинаковым значением ORDER BY.
SELECT price,
count(*) OVER (
ORDER BY price
GROUPS BETWEEN 1 PRECEDING AND 1 FOLLOWING
)
FROM products;


Если по одной цене находится 50 товаров, вся эта пачка считается одной группой. Поэтому можно строить окна относительно соседних значений, не вычисляя dense_rank() и не добавляя ещё один уровень запроса.

Ещё интереснее EXCLUDE, который можно использовать прямо внутри оконного фрейма:
SELECT id,
avg(score) OVER (
ORDER BY created_at
ROWS BETWEEN 10 PRECEDING AND 10 FOLLOWING
EXCLUDE CURRENT ROW
) AS neighbors_avg
FROM measurements;


Среднее здесь считается по соседним строкам, но текущая строка автоматически исключается.
SELECT price,
sum(amount) OVER (
ORDER BY price
GROUPS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
EXCLUDE GROUP
)
FROM sales;


EXCLUDE GROUP исключит из расчёта всю текущую peer-группу, а не только одну строку.

🔥 GROUPS + EXCLUDE позволяют описывать сложные окна непосредственно в OVER, где обычно появляются dense_rank(), дополнительные CTE и self join.

➡️ SQL Ready | #совет
  • 👍 13
  • 🔥 7
  • ❤ 5
Post #2127 2.17K
😍 PostgreSQL Zero to Hero — большой русскоязычный материал по изучению PostgreSQL!

Здесь разобраны основы SQL, проектирование баз данных, индексы, транзакции, MVCC, WAL, оптимизация запросов, репликация, бэкапы и многое другое. Подойдёт разработчикам, которые хотят системно изучить PostgreSQL и разобраться не только с SQL, но и с архитектурой, производительностью, эксплуатацией базы данных.

Оставляю ссылочку: GitHub 📱


➡️ SQL Ready | #репозиторий
  • 🔥 11
  • 👍 5
  • ❤ 3
  • 🤝 3
Post #2126 2.16K
📂 Шпаргалка по структурам данных!

Например, стек работает по принципу LIFO — последний добавленный элемент извлекается первым, а очередь наоборот использует FIFO — первым выходит тот, кто пришёл первым.

На картинке — 7 основных структур данных: массивы, связные списки, стек, очередь, хеш-таблица, дерево и граф. Полезная база, которую стоит знать каждому разработчику.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс
  • 🔥 19
  • 👍 9
  • ❤ 8
  • 🤝 1
Post #2125 2.51K
❤️ SQL-шпаргалка — основные конструкции и приёмы работы с базами данных!

Справочник по SQL с примерами запросов и пояснениями. Здесь на небольших таблицах разобраны INNER, LEFT, RIGHT, FULL и CROSS JOIN, а также показаны различия синтаксиса между PostgreSQL, MySQL, SQLite и SQL Server. Для команд указано, что именно они делают и в каких ситуациях применяются.

📌 Оставляю ссылочку: tools.sitebyme.ru

➡️ SQL Ready | #ресурс
  • 🔥 15
  • ❤ 8
  • 👍 6
Post #2124 2.62K
Проверяйте преобразование без исключений!

Обычный cast падает с ошибкой, если значение нельзя преобразовать. Из-за этого в ETL и в запросах к промежуточным данным часто приходится заранее чистить данные или писать PL/pgSQL с обработкой исключений.
SELECT value::integer
FROM staging;
-- ERROR при первом плохом значении


PostgreSQL умеет проверять, является ли строка допустимым значением конкретного типа, не вызывая ошибку.
SELECT value
FROM staging
WHERE pg_input_is_valid(value, 'integer');


Типом может быть не только integer:
SELECT pg_input_is_valid('192.168.1.10', 'inet');
SELECT pg_input_is_valid('550e8400-e29b-41d4-a716-446655440000', 'uuid');
SELECT pg_input_is_valid('2026-09-08', 'date');


А pg_input_error_info() позволяет получить причину, почему преобразование невозможно.
SELECT *
FROM pg_input_error_info('2026-02-30', 'date');


🔥 pg_input_is_valid() позволяет валидировать грязные входные данные средствами самой системы типов PostgreSQL.

➡️ SQL Ready | #совет
  • 🔥 16
  • 👍 8
  • 🤝 4
Post #2122 1.96K
  • 🔥 17
  • 👍 4
  • 🤝 3
  • ❤ 1
Post #2117 2.26K
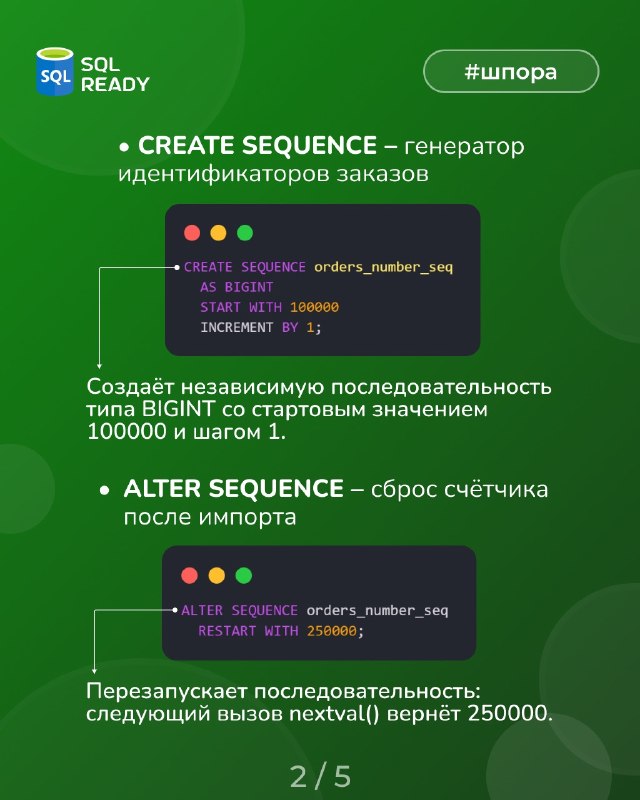
🖥 PostgreSQL — управление последовательностями!

Шпаргалка по работе с последовательностями в PostgreSQL: создание и удаление sequence, получение новых и текущих значений, сброс и синхронизация счётчика после импорта, а также привязка последовательности к столбцу. Помогает управлять генерацией идентификаторов и корректно работать со счётчиками при конкурентных вставках и загрузке данных.

➡️ SQL Ready | #шпора
  • 👍 13
  • ❤ 7
  • 🤝 3
  • 🔥 2
Post #2116 2.25K
😎 PostgreSQL FAQ — справочник по частым проблемам и вопросам!

Здесь собраны разборы типичных ситуаций при работе с PostgreSQL: проблемы с подключением и настройкой, ошибки в SQL, оптимизация медленных запросов, партиционирование, размеры таблиц, timestamp with time zone, pg_dump и другие нюансы. Есть конкретные команды, примеры диагностики и рекомендации по тому, какие данные собирать для поиска проблем.

Оставляю ссылочку: GitHub 📱


➡️ SQL Ready | #репозиторий
  • 🔥 12
  • ❤ 8
  • 👍 6
  • 🤝 2
Post #2115 2.17K
Настройки только для одного запроса!

Необязательно менять statement_timeout, work_mem или другие параметры для всей сессии. SET LOCAL действует только до конца текущей транзакции.
BEGIN;

SET LOCAL lock_timeout = '500ms';

ALTER TABLE orders
ADD COLUMN source text;

COMMIT;


Так миграция не будет бесконечно ждать блокировку: если таблица занята дольше заданного времени, PostgreSQL завершит операцию ошибкой.
BEGIN;

SET LOCAL work_mem = '512MB';

SELECT customer_id, count(*)
FROM events
GROUP BY customer_id;

COMMIT;


Можно даже точечно дать тяжёлому запросу больше памяти, не увеличивая work_mem для остальных запросов соединения.

🔥 SET LOCAL позволяет тюнить PostgreSQL под конкретную операцию и автоматически возвращает настройки назад после COMMIT или ROLLBACK.

➡️ SQL Ready | #совет
  • ❤ 10
  • 👍 7
  • 🔥 5
  • 🤝 1
Post #2113 2.09K
✍️ Попалась интересная статья на Хабре: «Почему в БД на PostgreSQL популярен тип numeric?»!

В этой статье:
• Разберётесь, почему для денег и точных расчётов часто выбирают numeric, несмотря на его производительность;
• Узнаете, чем на практике отличаются numeric, целые типы и double precision;
• Посмотрите, какие требования к точности и округлению предъявляют SQL, платёжные системы и финансовые стандарты.

🔊 Продолжай читать на Habr!


➡️ SQL Ready | #статья
  • ❤ 12
  • 🔥 7
  • 👍 5
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →