TGViewer
Channel Public Channel
SQL Ready | Базы Данных

SQL Ready | Базы Данных

@sql_ready

Авторский канал про Базы Данных и SQL
Ресурсы, гайды, задачи, шпаргалки.
Информация ежедневно пополняется!

Cотрудничество: @energy_c

РКН: https://clck.ru/3QREBc
Subscribers
17.5K
Photos
1.4K
Videos
112
Links
762

Showing posts older than #2041 · Back to latest

Older Posts 16 shown
Post #2040 1.94K
🧐 SQLler — интерактивный тренажёр для изучения SQL!

На сайте можно изучать SQL на практике, выполняя запросы прямо в браузере. Здесь собраны уроки по основным темам: подзапросы, агрегатные функции и другие конструкции, которые используются при работе с базами данных. Ресурс подойдёт новичкам, а также разработчикам и аналитикам, желающим закрепить знания с помощью практики.

📌 Оставляю ссылочку: sqller.com

➡️ SQL Ready | #ресурс
  • 🤝 12
  • 🔥 6
  • ❤ 3
  • 👍 3
Post #2039 1.85K
Вычисляемые значения на стороне PostgreSQL!

Если значение полностью зависит от других колонок, не обязательно считать его перед каждым INSERT и UPDATE.

PostgreSQL умеет делать это сам и всегда гарантирует корректный результат.
INSERT INTO orders(price, quantity)
VALUES (100, 3);

SELECT total
FROM orders
WHERE id = 1;


Поле total заполнится автоматически. Его нельзя случайно забыть обновить или вычислить по старой формуле.
UPDATE orders
SET quantity = 5
WHERE id = 1;

SELECT total
FROM orders
WHERE id = 1;


После изменения исходных данных значение пересчитается автоматически.
ALTER TABLE products
ADD COLUMN search_name text
GENERATED ALWAYS AS (lower(name)) STORED;


Это удобно для нормализованных значений, поисковых ключей, вычисляемых сумм и любых других детерминированных данных, которые должны всегда оставаться консистентными.

🔥 Если колонка полностью вычисляется из других колонок, пусть этим занимается PostgreSQL. Логику проще поддерживать, когда вычисление в одном месте.

➡️ SQL Ready | #совет
  • 🔥 16
  • 👍 8
  • ❤ 5
  • 🤝 1
Post #2037 1.91K
📂 Напоминалка по выбору NoSQL баз данных для проектов!

Например, MongoDB подходит для работы с гибкими документными структурами, Redis — для высокопроизводительного кэширования и хранения данных в памяти, а Cassandra — для распределённых систем с огромными объёмами данных и высокой доступностью.

На картинке — сравнение популярных NoSQL решений, их особенностей и основных сценариев использования: от поиска и аналитики до IoT, социальных сетей, e-commerce и real-time приложений.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс
  • 🔥 13
  • 👍 6
  • 🤝 5
Post #2036 1.98K
😍 CitForum Database — большая база материалов по SQL и СУБД!

На сайте собрана крупная библиотека материалов по базам данных: SQL, проектирование БД, транзакции, индексы, оптимизация запросов и администрирование различных СУБД. Здесь можно найти статьи, учебные пособия, техническую документацию и обзоры по PostgreSQL, MySQL, Oracle, Microsoft SQL Server и другим системам управления базами данных.

📌 Оставляю ссылочку: citforum.ru

➡️ SQL Ready | #ресурс
  • 👍 11
  • ❤ 6
  • 🔥 6
  • 🤝 1
Post #2031 1.79K
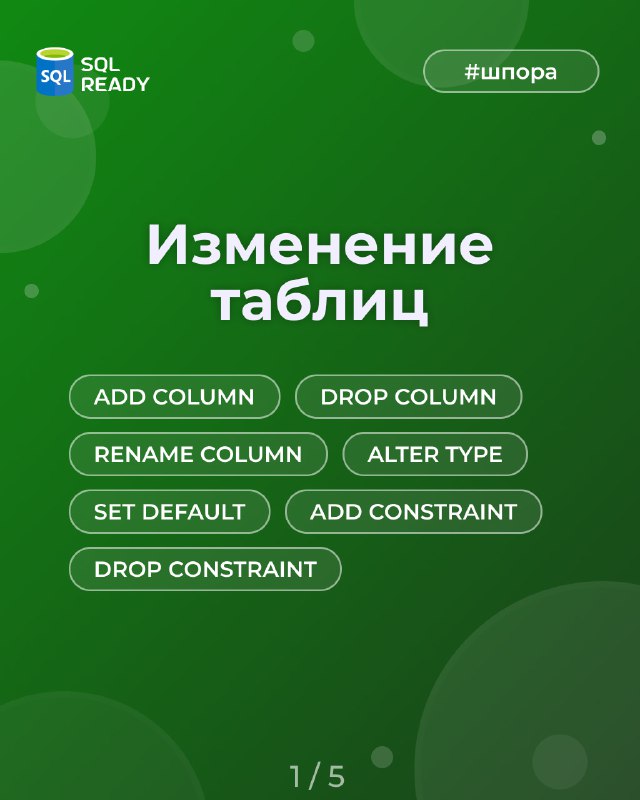
🖥 Разберем ALTER — команда для изменения структуры таблиц!

Добавить колонку, переименовать её, изменить тип или задать ограничение — всё это делается через ALTER TABLE. Один из важнейших инструментов в работе с готовыми таблицами.

➡️ SQL Ready | #шпора
  • 👍 15
  • ❤ 7
  • 🤝 5
  • 🔥 4
  • 😁 3
Post #2030 1.64K
Индексы по выражениям — ускоряем поиск по вычисляемым значениям!

Обычный индекс работает только тогда, когда база может сравнить значение напрямую с колонкой. Если в условии WHERE применяется функция к полю, оптимизатор часто не может использовать обычный индекс.

Таблица:
users(id, email)


Создадим индекс на email:
CREATE INDEX idx_users_email
ON users(email);


Теперь простой поиск по точному значению использует этот индекс:
SELECT *
FROM users
WHERE email = 'test@mail.com';


Но в реальных проектах часто нужна нормализация данных. Например, искать email без учёта регистра через LOWER():
SELECT *
FROM users
WHERE LOWER(email) = 'test@mail.com';


Проблема в том, что PostgreSQL должен применить LOWER() к каждой строке, а потом сравнить результат. Обычный индекс по email для такого условия уже не подходит.

Решение — создать индекс не на колонку, а на результат выражения:
CREATE INDEX idx_users_lower_email
ON users(LOWER(email));


Теперь база хранит вычисленные значения в индексе и может быстро находить совпадения:
EXPLAIN ANALYZE
SELECT *
FROM users
WHERE LOWER(email) = 'test@mail.com';


Та же техника работает и для других преобразований. Например, если часто ищем заказы по году создания:
CREATE INDEX idx_orders_year
ON orders(EXTRACT(YEAR FROM created_at));


Теперь запросы по этому выражению могут использовать индекс вместо полного прохода таблицы.

Индекс нужно создавать под реальные запросы. Лишние увеличивают время INSERT/UPDATE и занимают место.

🔥 Индексы по выражениям полезны, когда одно и то же вычисление постоянно используется в WHERE, JOIN или ORDER BY.

➡️ SQL Ready | #практика
  • ❤ 16
  • 👍 8
  • 🔥 8
Post #2028 1.72K
🐱 Полезную статью нашёл на Хабре: «PostgreSQL для бэкендера: 10 фич, которыми мало пользуются, а зря»!

В этой статье:
• Рассматриваются возможности PostgreSQL, которые помогают решать типовые backend-задачи на уровне базы;
• Разбираются эффективные инструменты для работы с очередями, запросами, индексами и поиском;
• Показывается, как использовать встроенные механизмы PostgreSQL для повышения производительности приложений.

🔊 Продолжайте читать на Habr!

➡️ SQL Ready | #статья
  • ❤ 12
  • 👍 7
  • 🔥 5
Post #2027 1.9K
📂 Напоминалка по SQL JOIN и объединению данных!

Например, INNER JOIN возвращает только совпадающие записи, LEFT/RIGHT JOIN сохраняют данные одной из сторон, а FULL JOIN объединяет полный набор данных из обеих таблиц. Дополнительные проверки через NULL позволяют находить отсутствующие связи между сущностями.

На картинке — основные типы JOIN и визуальное представление того, какие строки попадут в результат выполнения запроса.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс
  • 👍 15
  • ❤ 7
  • 🔥 6
  • 👎 1
Post #2026 1.63K
Почему ROW_NUMBER(), RANK() и DENSE_RANK() в SQL дают разный результат!

Есть такие оконные функции в SQL, которые выглядят почти одинаково, но используются для разных задач. ROW_NUMBER(), RANK() и DENSE_RANK() все умеют добавлять номера к строкам, но поведение меняется, когда в данных появляются одинаковые значения.

На тестовых данных разница может быть незаметной. Но в реальных задачах это влияет на рейтинги пользователей, отчёты, аналитику и любые запросы, где важно правильное место записи.

Например, есть таблица с результатами:
score
-----
100
100
90
80


Если нужно просто пронумеровать строки после сортировки, обычно используют ROW_NUMBER():
SELECT
score,
ROW_NUMBER() OVER (
ORDER BY score DESC
) AS position
FROM results;


Результат:
score | position
------+---------
100 | 1
100 | 2
90 | 3
80 | 4


ROW_NUMBER() всегда выдаёт уникальный номер для каждой строки. Даже если два значения одинаковые, они всё равно получат разные позиции.

Это удобно, когда нужна обычная последовательная нумерация. Например, для пагинации, выбора последней записи из группы или получения одной строки после сортировки. Но для рейтингов такой вариант часто подходит не всегда.

Если два пользователя набрали одинаковое количество баллов, обычно ожидается, что они займут одинаковое место. Для такой задачи используется RANK():
SELECT
score,
RANK() OVER (
ORDER BY score DESC
) AS position
FROM results;


Результат:
score | position
------+---------
100 | 1
100 | 1
90 | 3
80 | 4


RANK() учитывает одинаковые значения и присваивает им одинаковый номер. Но после одинаковых результатов появляются пропуски. В примере выше два участника заняли первое место, поэтому следующий результат получает третье место.

Иногда такое поведение является правильным. Например, в спортивных рейтингах, где нужно учитывать фактическое количество участников с одинаковым результатом. Но бывают случаи, когда пропуски не нужны. Тогда используется DENSE_RANK():
SELECT
score,
DENSE_RANK() OVER (
ORDER BY score DESC
) AS position
FROM results;


Результат:
score | position
------+---------
100 | 1
100 | 1
90 | 2
80 | 3


DENSE_RANK() работает похоже на RANK(), но продолжает нумерацию без пропусков. Получается простое правило: ROW_NUMBER() — когда каждая строка должна получить свой уникальный номер; RANK() — когда одинаковые значения должны иметь одинаковое место, а пропуски после них допустимы; DENSE_RANK() — когда одинаковые значения должны иметь одинаковое место, но нумерация должна идти без пропусков.

Есть ещё один практический момент, который часто забывают при использовании ROW_NUMBER(). Если несколько строк имеют одинаковое значение для сортировки:
SELECT
id,
score,
ROW_NUMBER() OVER (
ORDER BY score DESC
) AS position
FROM results;


то порядок таких строк может быть нестабильным. База данных не обязана всегда возвращать их в одинаковой последовательности.

Поэтому в реальных проектах часто добавляют дополнительное поле для сортировки:
SELECT
id,
score,
ROW_NUMBER() OVER (
ORDER BY score DESC, id
) AS position
FROM results;


🔥 ROW_NUMBER(), RANK() и DENSE_RANK() решают похожую задачу, но предназначены для разных сценариев. Главное — понимать, нужна ли вам обычная нумерация строк или именно логика рейтинга.

➡️ SQL Ready | #практика
  • ❤ 21
  • 🔥 8
  • 👍 7
  • 👎 1
Post #2024 2.02K
🤔 Learn PostgreSQL — информативное руководство!

Этот репозиторий поможет разобраться с PostgreSQL с нуля и понять, как работать с базой данных на практике. Здесь простым языком объясняются SQL-запросы, создание таблиц, связи между ними, индексы, объединения, агрегатные функции и др. Материал построен последовательно и с большим количеством примеров.

Оставляю ссылочку: GitHub 📱


➡️ SQL Ready | #репозиторий
  • 👍 12
  • ❤ 6
  • 🔥 4
Post #2023 1.91K
✍️ PostgreSQL Wiki — справочник и документация по PostgreSQL!

На сайте опубликованы статьи, руководства, инструкции и практические материалы по работе с одной из самых популярных СУБД. Здесь можно найти информацию по установке, настройке, администрированию, оптимизации производительности, репликации, резервному копированию, расширениям и др.

📌 Оставляю ссылочку: wiki.postgresql.org

➡️ SQL Ready | #ресурс
  • 👍 10
  • 🔥 5
  • 🤝 3
  • ❤ 2
Post #2022 1.79K
Используй RETURNING как временную таблицу!

Многие после UPDATE делают отдельный SELECT, чтобы получить изменённые данные.

Но PostgreSQL уже умеет вернуть результат изменения через RETURNING.
UPDATE orders
SET status = 'paid',
paid_at = now()
WHERE id = 1001
RETURNING id, status, paid_at;


Один запрос вместо двух. RETURNING можно сразу передавать дальше.

Например, обновили заказ и сразу записали историю изменения:
WITH changed AS (
UPDATE orders
SET status = 'cancelled'
WHERE id = 1001
RETURNING id, status
)
INSERT INTO order_history(order_id, new_status)
SELECT id, status
FROM changed;


Без промежуточных переменных и без повторного поиска строки.

Также можно использовать это для атомарного переноса данных:
WITH moved AS (
DELETE FROM queue
WHERE id = 55
RETURNING *
)
INSERT INTO archive_queue
SELECT *
FROM moved;


🔥 Получается "забрать строку и положить в другую таблицу" одной транзакционной операцией. Часто заменяет сложный код в сервисах и убирает лишние запросы к базе.

➡️ SQL Ready | #совет
  • ❤ 18
  • 🔥 9
  • 👍 7
Post #2020 1.58K
Почему CONCAT_WS в PostgreSQL часто лучше обычной конкатенации строк!

Есть такие SQL-функции, которые вроде бы выглядят слишком простыми, чтобы о них писать отдельный пост. Но именно они часто убирают кучу мелких проблем в реальных проектах, CONCAT_WS — хороший пример.

Когда работаешь с тестовыми данными, кажется, что собрать строку очень просто. Есть имя, фамилия, отчество — соединяем их через пробел и получаем красивый результат.

Обычно первый вариант выглядит так:
SELECT
first_name || ' ' || middle_name || ' ' || last_name AS full_name
FROM users;


На первый взгляд всё нормально. Но потом база начинает жить настоящими данными. У одного пользователя нет отчества. У другого не заполнена фамилия. После миграции часть полей приходит пустыми. И вот здесь простой запрос начинает вести себя не так, как ожидает разработчик.

Например:
first_name = 'John'
middle_name = NULL
last_name = 'Smith'


Кажется логичным получить:
John Smith


Но PostgreSQL вернёт:
NULL


Причина в том, что NULL — это не пустое значение. Это отсутствие значения. При обычной конкатенации строк неизвестная часть делает неизвестным весь результат.

Конечно, можно начать добавлять COALESCE:
SELECT
first_name || ' ' ||
COALESCE(middle_name || ' ', '') ||
last_name
FROM users;


Для двух-трёх полей это ещё нормально. Но в реальном запросе таких частей может быть намного больше: адрес, название компании, описание товара, дополнительные параметры.

И постепенно вместо простой сборки строки появляется большая конструкция из проверок.

В PostgreSQL для таких задач есть более удобный вариант:
SELECT
CONCAT_WS(
' ',
first_name,
middle_name,
last_name
) AS full_name
FROM users;


CONCAT_WS расшифровывается как "concatenate with separator". Первый аргумент — разделитель, который нужно использовать между значениями.

Главная особенность в том, что функция сама пропускает NULL. То есть:
John + NULL + Smith


превратится в:
John Smith


а не в строку с лишним пробелом или неожиданный NULL.

На практике это особенно удобно, когда собираете данные для отображения пользователю. Например, адрес:
Germany, Berlin, Alexanderplatz 10


может состоять из нескольких частей, но квартира или дополнительный номер могут отсутствовать. Не хочется писать отдельные проверки для каждого поля только ради красивого вывода.

Но есть нюанс, который часто забывают. CONCAT_WS пропускает NULL, но пустую строку считает настоящим значением.

Например, после загрузки данных из CSV можно получить:
middle_name = ''


Для пользователя это выглядит так же, как отсутствие значения. Но PostgreSQL различает эти случаи. В результате можно получить: John Smith с двойным пробелом.

Поэтому в системах, где данные приходят из разных источников, часто сначала нормализуют значения:
NULLIF(middle_name, '')


После этого пустые строки становятся NULL, и CONCAT_WS уже работает предсказуемо. На небольших примерах это кажется мелочью. Но когда у тебя несколько миллионов записей и данные собираются из разных сервисов, именно такие детали начинают влиять на качество данных и количество лишнего кода.

🔥 CONCAT_WS — хороший пример того, как правильный инструмент делает SQL проще. Если нужно собрать строку из нескольких необязательных полей — часто лучше использовать её, чем вручную обрабатывать каждый NULL.

➡️ SQL Ready | #практика
  • 👍 14
  • ❤ 9
  • 🔥 5
Post #2018 1.54K
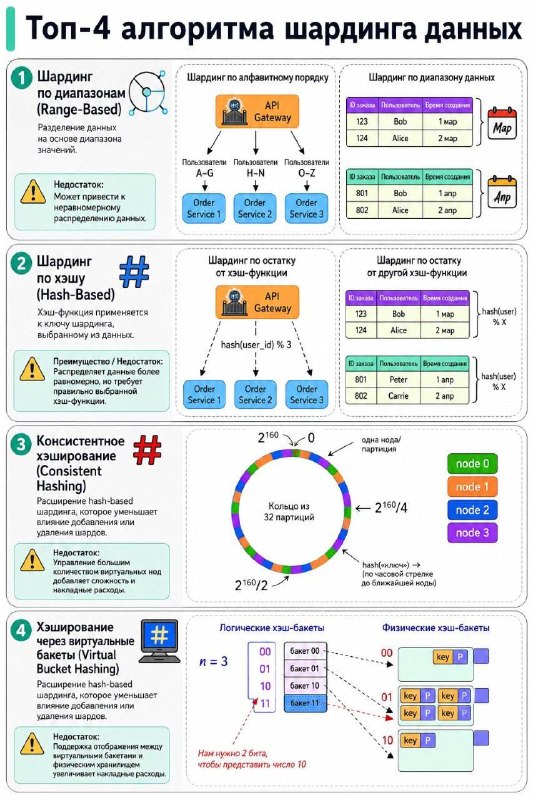
📂 Напоминалка по шардингу данных!

Например, range-based шардинг делит данные по диапазонам значений, hash-based — распределяет записи через хэш-функцию, а consistent hashing помогает минимизировать перераспределение данных при добавлении новых нод.

На картинке — 4 алгоритма шардинга, которые полезно знать при проектировании масштабируемых систем и высоконагруженных баз данных.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс
  • ❤ 12
  • 👍 4
  • 🤝 2
Post #2017 1.72K
Обычное сравнение через = и != ломается, как только появляется NULL!

old_value IS DISTINCT FROM new_value


В SQL NULL никогда не равен даже другому NULL, поэтому сравнение начинает вести себя не так, как ожидается.
SELECT
NULL = NULL,
NULL != NULL;


Оба выражения вернут не TRUE и не FALSE, а NULL. Именно из-за этого часто ломается логика сравнения.
SELECT *
FROM users
WHERE old_email != new_email;


Кажется, что запрос покажет все изменённые email. Но если одно из значений NULL, строка может просто не попасть в выборку.

Для таких случаев в PostgreSQL есть специальный оператор.
SELECT *
FROM users
WHERE old_email IS DISTINCT FROM new_email;


Теперь NULL корректно участвует в сравнении. PostgreSQL считает NULL обычным сравниваемым состоянием.
NULL IS DISTINCT FROM NULL        -- false
NULL IS DISTINCT FROM 'test' -- true
'a' IS DISTINCT FROM 'b' -- true


Пригодится в аудитах изменений, UPSERT-логике, ETL и триггерах, где важно понять: значение реально изменилось или нет.

🔥 Оператор, который убирает большое количество багов при работе с NULL.

➡️ SQL Ready | #совет
  • ❤ 11
  • 👍 8
  • 🔥 4
Post #2015 1.7K
📂 Напоминалка по генерации уникальных ID в SQL и распределённых системах!

Например, Auto-Increment подходит для простых SQL-проектов, где одна база данных управляет последовательностью записей, а Snowflake/UUID чаще используют в высоконагруженных системах с микросервисами, где требуется генерация ID без единой точки отказа.

На картинке — 5 основных подходов к созданию уникальных идентификаторов.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс
  • 🔥 9
  • 👍 7
  • 🤝 3
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →