TGViewer
Channel Public Channel
SQL Ready | Базы Данных

SQL Ready | Базы Данных

@sql_ready

Авторский канал про Базы Данных и SQL
Ресурсы, гайды, задачи, шпаргалки.
Информация ежедневно пополняется!

Cотрудничество: @energy_c

РКН: https://clck.ru/3QREBc
Subscribers
17.5K
Photos
1.4K
Videos
113
Links
765

Showing posts older than #1826 · Back to latest

Older Posts 16 shown
Post #1825 2.61K
VACUUM — чистим таблицу и ускоряем работу базы!

В большинстве СУБД удалённые или обновлённые строки не удаляются мгновенно, а остаются как «мертвые» записи. Со временем это замедляет запросы и увеличивает размер таблиц — нужна очистка.

Сначала удаляем устаревшие записи из таблицы:
DELETE FROM sessions WHERE expired = true;


Однако физически строки всё ещё занимают место.

Чтобы освободить пространство и обновить статистику, запускаем:
VACUUM ANALYZE sessions;


Для диагностики можно получить подробный отчёт о процессе очистки:
VACUUM VERBOSE sessions;


🔥 Регулярный VACUUM поддерживает производительность и точность планов запросов.

➡️ SQL Ready | #практика
  • 🔥 15
  • ❤ 10
  • 👍 9
Post #1823 2.54K
  • 👍 12
  • 🔥 7
  • 🤝 7
  • ❤ 2
  • 👎 2
Post #1822 2.44K
  • 👍 10
  • 🔥 6
  • 🤝 4
  • ❤ 1
  • 👎 1
Post #1821 2.53K
Передавайте списки значений через массивы вместо длинных IN!

Когда из приложения нужно передать список id в SQL, многие пишут IN (... , ... , ...), что увеличивает текст SQL и усложняет работу с prepared statements:
WHERE id IN (1,2,3,4,5,6,7)


PostgreSQL умеет принимать массив и сравнивать его через ANY — это короче и позволяет избежать генерации динамического SQL:
WHERE id = ANY($1)


Приложение просто передаёт массив параметром, а текст запроса остаётся неизменным независимо от длины списка:
SELECT *
FROM users
WHERE email = ANY($1);


На практике полезно явно указывать тип массива ($1::bigint[]), а также помнить, что NULL внутри массива влияет на результат сравнения.

🔥 Этот паттерн особенно удобен для batch-запросов, API-фильтров и массовых выборок, где количество значений может сильно меняться.

➡️ SQL Ready | #совет
  • 👍 14
  • 🔥 12
  • ❤ 10
  • 😁 1
Post #1819 2.15K
🐱 Крутейшая статья вышла на Хабре: «Научил ИИ-агента помнить важное и забывать лишнее в SQLite»!

В этой статье:
• Разбирается, почему классический RAG плохо подходит для долгоживущих AI-агентов;
• Показана архитектура когнитивной памяти на SQLite: граф узлов и рёбер, сущности, гибридный поиск и механизм разрешения конфликтов знаний;
• Объясняется, как реализовать память агента с механизмом забывания и консолидацией фактов.


🔊 Продолжайте читать на Habr!


➡️ SQL Ready | #статья
  • ❤ 12
  • 👍 7
  • 🔥 6
  • 🤝 3
Post #1818 2.13K
SEMI JOIN через EXISTS — как корректно проверять наличие связанных строк!

Частая задача в SQL — выбрать строки из одной таблицы, если в другой таблице существует хотя бы одна связанная запись.

Таблицы:
customers(id, name)
orders(id, customer_id, created_at)


Нужно получить клиентов, у которых есть хотя бы один заказ.

Попытка через JOIN:
SELECT
c.id,
c.name
FROM customers c
JOIN orders o
ON o.customer_id = c.id;


Запрос вернёт клиентов, но если у клиента несколько заказов, он появится в результате несколько раз.

Чтобы убрать дубликаты, часто добавляют DISTINCT:
SELECT DISTINCT
c.id,
c.name
FROM customers c
JOIN orders o
ON o.customer_id = c.id;


Результат будет корректным, однако такой запрос выражает задачу менее точно: JOIN формирует строки для каждого совпадения, а DISTINCT затем устраняет повторяющиеся значения.

В подобных задачах фактически требуется semi join — вернуть строку из customers, если существует хотя бы одна связанная строка в orders.

В большинстве СУБД это обычно выражают через EXISTS:
SELECT
c.id,
c.name
FROM customers c
WHERE EXISTS (
SELECT 1
FROM orders o
WHERE o.customer_id = c.id
);


Подзапрос проверяет наличие хотя бы одной строки в orders, связанной с текущим клиентом.

Оптимизатор часто может завершить проверку сразу после нахождения первого совпадения, поэтому EXISTS является естественным инструментом для проверки существования строк.

Практический пример — клиенты, которые делали заказы после определённой даты:
SELECT
c.id,
c.name
FROM customers c
WHERE EXISTS (
SELECT 1
FROM orders o
WHERE o.customer_id = c.id
AND o.created_at >= '2025-01-01'
);


EXISTS не возвращает данные из подзапроса — он только проверяет факт существования строки.

Поэтому внутри обычно пишут:
SELECT 1


или:
SELECT *


В контексте EXISTS список выбираемых выражений не влияет на результат.

🔥 EXISTS — стандартный и выразительный способ реализовать semi join. Он точно отражает намерение запроса и часто позволяет оптимизатору построить более эффективный план выполнения.

➡️ SQL Ready | #практика
  • 👍 13
  • 🔥 9
  • ❤ 6
  • 🤝 6
Post #1816 2.57K
❤️ RusauSQL — подробный учебник по SQL для тестировщиков и разработчиков!

Это большой гайд по SQL, где последовательно объясняется, как работать с базами данных и писать запросы. На сайте разбираются фундаментальные вещи: что такое SQL, как устроены таблицы и базы данных, как выполнять запросы, проверять данные и взаимодействовать с сервером через язык запросов. Отличный ресурс, если хочешь разобраться в SQL с практической стороны и понять работу баз данных.

📌 Оставляю ссылочку: rusau.net

➡️ SQL Ready | #сайт
  • 👍 12
  • ❤ 8
  • 🔥 7
  • 🤝 2
Post #1815 2.54K
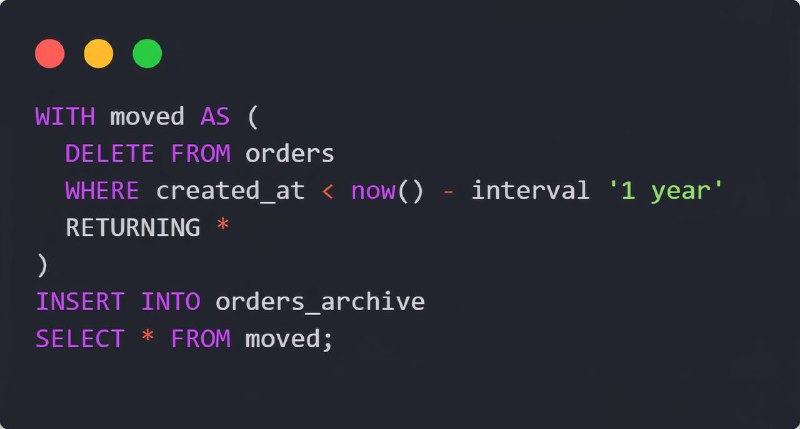
Атомарное перемещение данных между таблицами!

Иногда нужно архивировать старые данные: удалить их из основной таблицы и одновременно сохранить в архиве. Многие делают это двумя запросами (INSERT => DELETE):
DELETE FROM orders
RETURNING *


RETURNING позволяет сразу вернуть удалённые строки как результирующий набор, не выполняя повторный SELECT.
WITH moved AS (...)


CTE превращает результат удаления во временный набор данных, который можно использовать в следующей операции:
INSERT INTO orders_archive
SELECT * FROM moved;


В итоге строки удаляются и архивируются одним атомарным запросом, без повторного чтения таблицы.

🔥 Полезный паттерн для архивирования, миграций, дедупликации и batch-операций над большими таблицами.

➡️ SQL Ready | #совет
  • 👍 15
  • 🤝 14
  • 🔥 10
  • ❤ 1
Post #1813 2.63K
📂 Напоминалка по SQL JOIN!

Например, LEFT JOIN позволяет получить все строки из левой таблицы, даже если соответствующих записей в правой таблице нет, а FULL OUTER JOIN возвращает все строки из обеих таблиц, заполняя отсутствующие значения NULL.

На изображении показаны 4 основных типа SQL JOIN, которые чаще всего используются при объединении данных из нескольких таблиц.

📌 Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс
  • 👍 14
  • 🔥 10
  • 🤝 8
  • ❤ 3
Post #1808 2.68K
🖥 Анализ средней длительности сессий пользователей по устройствам!

В этой задаче напишем SQL-запрос, который поможет вычислить среднее время сессии для пользователей на разных устройствах за последние 30 дней.

Что делаем:
• Фильтруем сессии по времени и устройствам.

• Считаем длительность каждой сессии.

• Группируем и находим среднее время по типам устройств.


Такой анализ помогает понять, в каких моментах сфокусироваться на улучшении UX и маркетинговых кампаниях.

➡️ SQL Ready | #задача
  • 🔥 15
  • 👍 10
  • ❤ 8
  • 🤝 1
Post #1806 2.46K
💡 Rows — умные таблицы с встроенным ИИ!

Сервис для работы с данными в формате таблиц (аналог Excel / Google Sheets) с интегрированными AI-инструментами. Позволяет анализировать данные, создавать формулы по описанию и подтягивать информацию из интернета и API. Подходит для аналитики, автоматизации и обработки больших массивов данных.

📌 Оставляю ссылочку: rows.com

➡️ SQL Ready | #ресурс
  • 👍 15
  • ❤ 8
  • 🔥 8
  • 🤝 1
Post #1805 2.41K
Агрегирование по группам с оконными функциями!

Когда нужно посчитать агрегаты по группе и при этом сохранить исходные строки, многие делают подзапрос с GROUP BY и потом джойнят его обратно:
SUM(o.total) OVER (PARTITION BY o.user_id)


Оконная функция считает агрегат по группе, но не схлопывает строки, поэтому не нужен ни GROUP BY, ни повторное соединение:
AVG(o.total) OVER (PARTITION BY o.user_id)


Можно получить любые метрики по той же группе в одном проходе по данным:
COUNT(*) OVER (PARTITION BY o.user_id)


Особенно полезно для аналитики, отчётов, флагов “у пользователя больше N заказов” и подобных задач без лишних подзапросов.

🔥 Один из самых эффективных способов упростить сложные запросы.

➡️ SQL Ready | #совет
  • 👍 14
  • 🔥 9
  • 🤝 8
Post #1803 2.35K
☕️ Полезную статью нашёл на Хабре: «Инженерная история: добавляем 3-ю СУБД в карточный процессинг»!

В этой статье:
• Разобрано, зачем в высоконагруженной системе может понадобиться сразу несколько СУБД и как между ними строится абстрактный слой доступа к данным;
• Показан опыт интеграции распределённой базы данных YDB в существующую архитектуру;
• Разбираются технические нюансы: батч-операции, строгая типизация запросов, особенности драйверов и результаты нагрузочного тестирования.


🔊 Продолжайте читать на Habr!


➡️ SQL Ready | #статья
  • ❤ 11
  • 👍 8
  • 🔥 8
Post #1802 2.65K
Почему OFFSET может ломать производительность пагинации?

OFFSET выглядит удобно для страниц, но база всё равно должна просканировать и пропустить все предыдущие строки. Поэтому чем дальше страница, тем медленнее запрос:
OFFSET 100000


Даже если вы не видите эти строки, СУБД всё равно читает их из индекса или таблицы, поэтому время выполнения растёт вместе с OFFSET:
SELECT *
FROM orders
WHERE id > :last_seen_id
ORDER BY id
LIMIT 10;


Эффективнее использовать keyset-pagination — продолжать выборку от последнего значения ключа, а не пропускать строки:
WHERE id > :last_seen_id


:last_seen_id — это id последней строки предыдущей страницы.

Такой запрос использует индекс напрямую (если id индексирован, обычно это PK), поэтому работает одинаково быстро на первой и на миллионной странице.

Если сортировка не уникальная (например created_at), добавляйте tie-breaker:
ORDER BY created_at, id
WHERE (created_at, id) > (:last_seen_created_at, :last_seen_id)


🔥 Такой подход широко используется в больших системах: API, лентах событий, лог-системах и бесконечных скроллах.

➡️ SQL Ready | #совет
  • 👍 17
  • ❤ 15
  • 🔥 8
Post #1800 3.09K
❤️ Stepik SQL — практический курс с примерами запросов и упражнениями!

Этот репозиторий содержит структурированные задания, схемы баз данных и примеры SQL-запросов из курса на Stepik. Материалы охватывают работу с таблицами, фильтрацию, JOIN, группировки, агрегаты и другие ключевые темы языка, с акцентом на практику. Отличный ресурс для тех, кто хочет закрепить теорию через задачи.

Оставляю ссылочку: GitHub 📱


➡️ SQL Ready | #репозиторий
  • 🔥 17
  • ❤ 12
  • 👍 10
Post #1799 2.66K
Анти-JOIN — как корректно выбирать строки без связанных записей!

Частая задача в SQL — найти строки, для которых отсутствуют связанные записи в другой таблице. Это классический anti-join. Например, нужно получить клиентов, которые ни разу не сделали заказ.

Таблицы:
customers(id, name)
orders(id, customer_id, created_at)


LEFT JOIN + IS NULL:
SELECT c.id, c.name
FROM customers c
LEFT JOIN orders o
ON o.customer_id = c.id
WHERE o.id IS NULL;


LEFT JOIN возвращает всех клиентов. Если совпадений нет, поля из orders становятся NULL, и фильтр оставляет только клиентов без заказов.

Проверять нужно гарантированно NOT NULL колонку правой таблицы (обычно PK, например o.id), иначе возможны логические ошибки.

NOT EXISTS (предпочтительно):
SELECT c.id, c.name
FROM customers c
WHERE NOT EXISTS (
SELECT 1
FROM orders o
WHERE o.customer_id = c.id
);


Запрос напрямую выражает отсутствие строк. В простом случае он эквивалентен LEFT JOIN, но лучше отражает намерение, устойчив к NULL в подзапросе и часто даёт более предсказуемый план при усложнении условий.

Почему не NOT IN:
SELECT c.id, c.name
FROM customers c
WHERE c.id NOT IN (
SELECT customer_id
FROM orders
);


Если подзапрос возвращает хотя бы один NULL, результат может стать пустым из-за трёхзначной логики SQL. Использовать этот вариант безопасно только при гарантированном NOT NULL в orders.customer_id.

Нюанс с условиями в JOIN:
SELECT c.id
FROM customers c
LEFT JOIN orders o
ON o.customer_id = c.id
AND o.created_at >= DATE '2026-01-01'
WHERE o.id IS NULL;


Этот запрос ищет клиентов без заказов после указанной даты.

Если требуется найти клиентов вообще без заказов, добавлять условия в JOIN нельзя — это меняет бизнес-смысл. В таком случае корректнее использовать NOT EXISTS.

🔥 Минимально необходим индекс orders(customer_id). При частой фильтрации по дате логичен составной индекс (customer_id, created_at).

➡️ SQL Ready | #практика
  • ❤ 16
  • 👍 10
  • 🔥 8
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →