TGViewer
Channel Public Channel
SQL Ready | Базы Данных

SQL Ready | Базы Данных

@sql_ready

Авторский канал про Базы Данных и SQL
Ресурсы, гайды, задачи, шпаргалки.
Информация ежедневно пополняется!

Cотрудничество: @energy_c

РКН: https://clck.ru/3QREBc
Subscribers
17.5K
Photos
1.4K
Videos
113
Links
765

Showing posts older than #1713 · Back to latest

Older Posts 11 shown
Post #1712 4.18K
Знали, что в SQL можно получить несколько уровней агрегации за один проход по данным?

Частая задача - посчитать метрики сразу на нескольких уровнях: по стране и статусу, только по стране и общий итог. Обычно для этого пишут несколько SELECT и склеивают их UNION ALL:
SELECT country, status, COUNT(*) FROM orders GROUP BY country, status
UNION ALL
SELECT country, NULL, COUNT(*) FROM orders GROUP BY country
UNION ALL
SELECT NULL, NULL, COUNT(*) FROM orders;


GROUPING SETS позволяет описать все нужные уровни агрегации в одном GROUP BY:
GROUP BY GROUPING SETS ((country, status), (country), ())


Каждая скобка - отдельный уровень агрегации. PostgreSQL делает это за один проход по данным, без лишних сканов.

Строка с пустыми скобками () - это глобальный итог. Колонки, которые не участвуют в текущем уровне, приходят как NULL:
(country = NULL, status = NULL)


🔥 Этот приём особенно полезен в отчётах и аналитике, где нужны totals, subtotals и детализация одновременно.

➡️ SQL Ready | #совет
  • ❤ 20
  • 👍 14
  • 🔥 10
  • 🤝 2
Post #1711 3.25K
NULL и сравнения — почему = и <> с NULL не работают!

NULL в SQL — не значение, а его отсутствие. Из-за этого любые обычные сравнения с NULL ведут себя не так, как ожидают, и часто ломают фильтрацию.

Таблица:
users(id, email, deleted_at)


Нужно выбрать неудалённых пользователей.

Типичный, но неправильный запрос:
SELECT *
FROM users
WHERE deleted_at = NULL;


Запрос выполнится, но вернёт 0 строк.

Почему так — SQL выражение:
deleted_at = NULL


никогда не бывает TRUE.

Любое сравнение с NULL (=, <>, <, >) возвращает UNKNOWN, а WHERE пропускает только TRUE.

То же самое с отрицанием:
WHERE deleted_at <> NULL;


Результат — тоже пусто.

Правильный способ — IS NULL:
SELECT *
FROM users
WHERE deleted_at IS NULL;


И обратное условие:
SELECT *
FROM users
WHERE deleted_at IS NOT NULL;


IS NULL и IS NOT NULL — всегда возвращают TRUE или FALSE, никогда UNKNOWN.

Частая скрытая ошибка в составных условиях:
WHERE status = 'active'
AND deleted_at <> '2026-01-01'


Если deleted_at равен NULL, всё выражение становится UNKNOWN, и строка отбрасывается, даже если status = 'active'.

Корректная проверка «не удалён»:
WHERE status = 'active'
AND deleted_at IS NULL


Важно помнить про OR:
WHERE role = 'admin'
OR deleted_at IS NULL


Здесь логика работает ожидаемо, потому что IS NULL не возвращает UNKNOWN, а значит выражение может стать TRUE.

🔥 Практические правила: = и <> с NULL не работают в WHERE; любой UNKNOWN в WHERE — строка отбрасывается. Если строка пропала из результата — первым делом проверяй условия с NULL

➡️ SQL Ready | #практика
  • ❤ 15
  • 👍 9
  • 🔥 8
  • 🤝 4
Post #1709 2.74K
📂 Напоминалка для работы с алгоритмами выбора лидера в распределённых системах!

Например, Raft выбирает лидера через голосование, Paxos использует кворум, а Bully Algorithm назначает лидером узел с максимальным ID.

На картинке — 5 базовых алгоритмов leader election, которые используются в распределённых БД и системах координации.

Сохрани, чтобы не забыть!

➡️ SQL Ready | #ресурс
  • 👍 13
  • ❤ 8
  • 🔥 8
Post #1704 3.08K
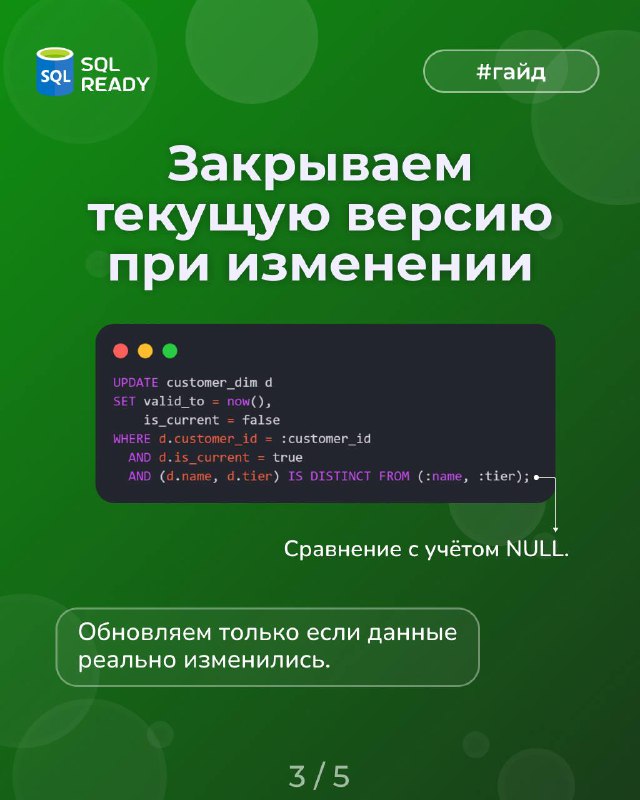
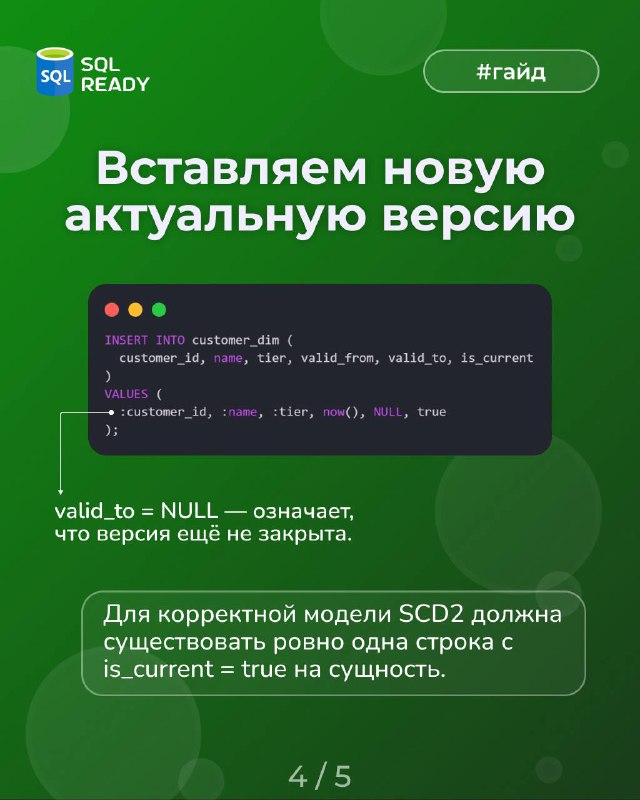
🖥 SCD2 — хранение истории изменений в таблицах!

При прямом UPDATE данные теряют историю: невозможно корректно восстановить состояние сущности на дату или отследить момент изменения.

Сегодня в гайде:
• Как моделировать версионные данные через valid_from / valid_to;

• Как корректно закрывать предыдущую версию и создавать новую;

• Как получать актуальное состояние и исторические срезы без дополнительной логики.


SCD Type 2 хранит каждое изменение как отдельную версию строки с фиксированным интервалом актуальности.

➡️ SQL Ready | #гайд
  • ❤ 12
  • 👍 10
  • 🤝 8
  • 🔥 3
Post #1702 3.37K
😎 Сodedokode/pasta — теория + задачи на практике!

Репозиторий с понятным и структурированным разбором баз данных на русском языке. Здесь разобраны ключевые концепции SQL для MySQL и PostgreSQL, есть примеры запросов и задачи для самостоятельной работы. Отлично подходит для укрепления базы и подготовки к собеседованиям.

Оставляю ссылочку: GitHub 📱


➡️ SQL Ready | #репозиторий
  • 🔥 18
  • 👍 8
  • 🤝 5
  • ❤ 3
Post #1701 3.33K
LEFT JOIN и WHERE — классическая ловушка с NULL!

LEFT JOIN используют, когда нужно сохранить строки из левой таблицы, даже если в правой нет совпадений. Но одно неверное условие в WHERE — и LEFT JOIN незаметно превращается в INNER JOIN.

Таблицы:
users(id, email)
orders(id, user_id, amount)


Нужно получить всех пользователей и их заказы (если есть):
SELECT
u.id,
u.email,
o.amount
FROM users u
LEFT JOIN orders o ON o.user_id = u.id;


Если у пользователя нет заказов, поля из orders будут NULL — это ожидаемое поведение LEFT JOIN.

Теперь типичная ошибка:
SELECT
u.id,
u.email,
o.amount
FROM users u
LEFT JOIN orders o ON o.user_id = u.id
WHERE o.amount > 100;


Условие в WHERE отфильтровывает строки, где o.amount IS NULL.
В результате пользователи без заказов исчезают, и запрос фактически работает как INNER JOIN.

Правильный вариант — переносить условия на правую таблицу в ON:
SELECT
u.id,
u.email,
o.amount
FROM users u
LEFT JOIN orders o
ON o.user_id = u.id
AND o.amount > 100;


Теперь: пользователи без заказов остаются в результате, фильтрация применяется только к связанным строкам orders.

Если же логика действительно требует убрать пользователей без заказов, тогда честнее писать INNER JOIN:
SELECT
u.id,
u.email,
o.amount
FROM users u
JOIN orders o ON o.user_id = u.id
WHERE o.amount > 100;


Так намерение запроса читается однозначно.

🔥 Условия в WHERE применяются после JOIN и могут уничтожить строки с NULL. Условия в ON влияют только на логику связывания таблиц.

➡️ SQL Ready | #практика
  • 👍 24
  • ❤ 14
  • 🔥 8
  • 🤝 2
Post #1699 3.42K
❤️ AlgoTree — понятные объяснения алгоритмов, деревьев и графов!

Этот сайт помогает анализировать структуры данных: деревья, графы, обходы и множество другого. Здесь нет решений задач или подготовкой к собеседованиям, упор именно на понимание того, как и почему всё устроено. Материал подается последовательно и концептуально, поэтому хорошо подходит даже новичкам.

📌 Оставляю ссылочку: algotree.org

➡️ SQL Ready | #ресурс
  • ❤ 20
  • 👍 9
  • 🤝 7
  • 🔥 2
Post #1693 4.71K
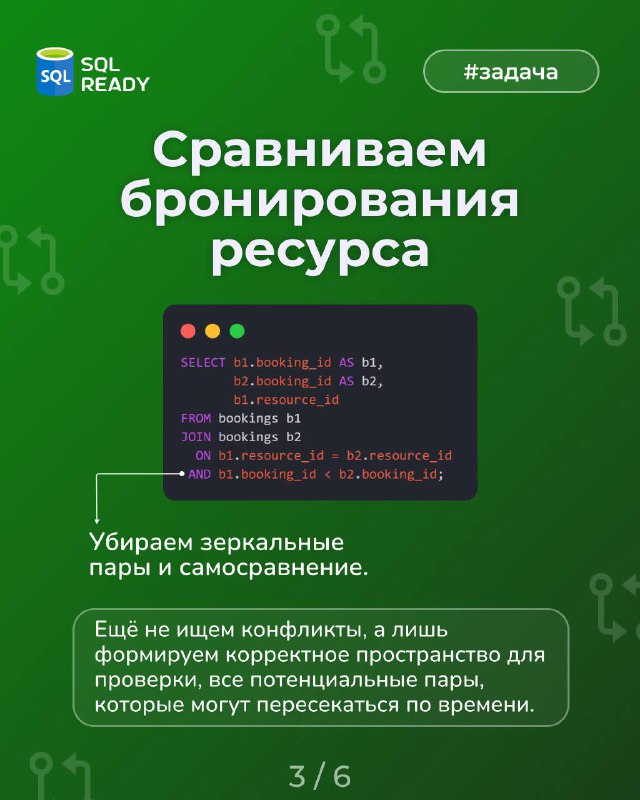
🖥 Ищем пересекающиеся бронирования!

В системах бронирования одна из частых ошибок - это пересечение интервалов, когда один и тот же ресурс оказывается занят сразу несколькими пользователями.

Сегодня в задаче:
• Сравним бронирования одного ресурса между собой, не создавая дубликатов;

• Проверим пересечение временных интервалов с помощью канонического условия;

• Получим список конфликтующих бронирований, которые система должна блокировать.


Это базовый инструмент контроля данных в системах бронирования, календарях, слотах доставки и любых сервисах с ограниченными ресурсами.

➡️ SQL Ready | #задача
  • 👍 19
  • 🔥 13
  • ❤ 5
  • 🤝 4
Post #1692 4.01K
Как получить «последнюю запись на группу»?

Очень частая задача - взять последнюю запись на пользователя, заказ, сущность. Многие делают это с ROW_NUMBER(), хотя Postgres умеет проще:
SELECT DISTINCT ON (user_id) *
FROM orders
ORDER BY user_id, created_at DESC;


DISTINCT ON оставляет первую строку в рамках группы, а порядок задаётся через ORDER BY:
ORDER BY user_id, created_at DESC


Так первой будет именно самая свежая запись.

Если возможны одинаковые created_at, лучше явно добавить тай-брейкер:
ORDER BY user_id, created_at DESC, id DESC


Если нужно выбрать конкретные поля и избежать SELECT *, просто укажите нужные колонки:
SELECT DISTINCT ON (user_id)
user_id, id, created_at
FROM orders
ORDER BY user_id, created_at DESC, id DESC;


Выражения из DISTINCT ON (...) обязаны быть левым префиксом ORDER BY, иначе Postgres выдаст ошибку.

🔥 Такой запрос часто читается проще, чем ROW_NUMBER(), и при подходящем индексе (user_id, created_at DESC, id DESC) может давать отличный план выполнения.

➡️ SQL Ready | #совет
  • 👍 20
  • ❤ 7
  • 🔥 6
  • 🤝 3
Post #1690 2.75K
  • 👍 20
  • 😁 11
  • 🔥 8
Post #1685 3.22K
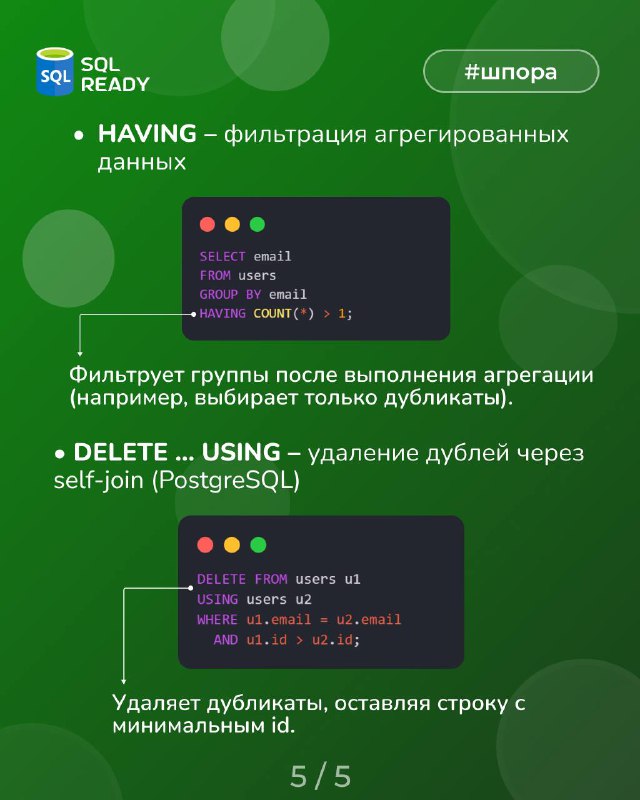
🖥 Поиск дубликатов и ранжирование данных!

Шпаргалка по оконным функциям и агрегатам для нумерации строк, поиска и анализа дубликатов, ранжирования результатов и аккуратного удаления лишних записей. Используется при очистке данных, аналитических запросах, построении рейтингов и подготовке данных к миграциям и отчётности.

➡️ SQL Ready | #шпора
  • 👍 14
  • 🔥 8
  • 🤝 7
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →