
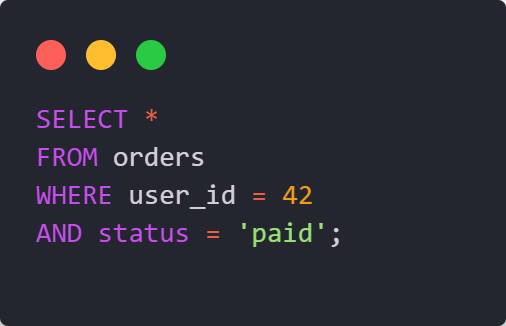
Бывает, что запрос очевидный, индексы есть, но PostgreSQL всё равно выбирает Seq Scan, потому что считает условия независимыми и сильно ошибается в кардинальности:
CREATE STATISTICS s_orders (dependencies)
ON user_id, status
FROM orders;
Extended statistics позволяют оптимизатору учитывать зависимости между колонками, например что у конкретного
user_id почти всегда один и тот же status:ANALYZE orders;
После сбора статистики PostgreSQL начинает правильно оценивать селективность комбинации условий, а не перемножать вероятности как будто они независимы:
EXPLAIN ANALYZE SELECT ...
🔥 Не меняешь код и индексы, но кардинально улучшаешь планы выполнения.
➡️ SQL Ready | #совет