
Более подробно в предыдущих постах: 1 – 2, 3 – 4, 5 – 9.
Кратко:
1. Нейросеть не понимает текст как человек.
Весь промпт превращается в набор чисел – векторов.
2. Внутри обученной модели есть латентное пространство – это огромная невидимая карта смыслов (что как с чем чаще связано – упрощенно, латентное пространство диффузионной модели это пространство сжатых изображений).
То, что часто встречалось вместе в датасете, лежит там рядом.
3. Когда мы описываем сцену общими словами, модель берёт то, что для неё чаще всего связывалось с этой фразой при обучении.
4. Важны связи между словами, а не суп из запятых.
Когда мы просто бросаем в модель список:
angry, dramatic lighting, 8k, ultra detailed, fog, rain, smoke, bokeh, tears, blood, cinema, volumetric light
– модели сложнее установить контекст, кому и чему принадлежит каждый эффект.
5. Нейросеть не читает смысл фразы: она подбирает наиболее вероятные визуальные паттерны под этот набор чисел. Именно поэтому точность и связность формулировок так важны.
Выводы:
👉 Не стоит надеяться, что нейросеть догадается по смыслу. Ей нужны связи между словами и точные описания.
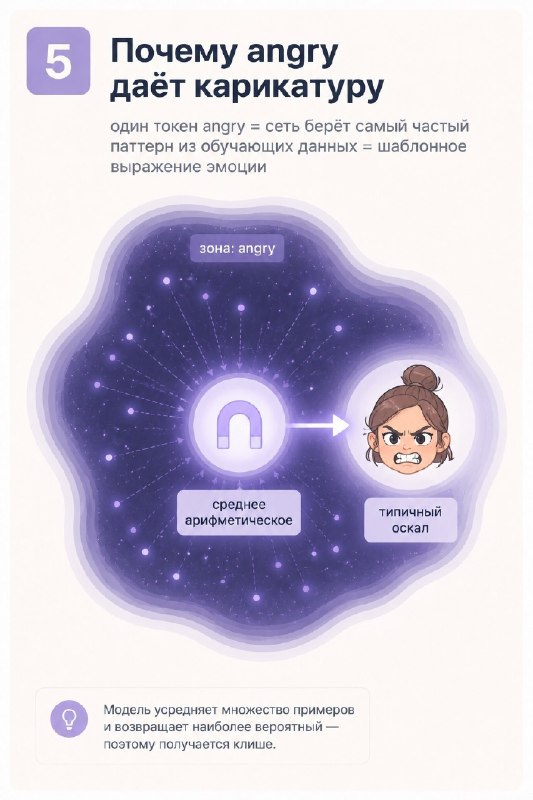
👉 Один общий признак/ярлык (например, angry) ведёт в широкую, размытую зону, получаем шаблонный результат.
👉 Вместо angry girl лучше:
«девушка в библиотеке, сжатая челюсть, слегка нахмуренные брови, неподвижные плечи, взгляд исподлобья, холодный верхний свет».
👉 Добавляйте не только тело, но и атмосферу, свет, расстояния и прочее.
👉 Большой гипердетализированный промпт тоже плохо! В старых моделях он обрезается физически. В новых середина теряет вес, а конкурирующие детали начинают мешать друг другу. Лучше работает не "написать всё", а выбрать главное и выстроить это в связный кадр. (Об этом расскажу позже)
👉 Лучше писать фразами и связками:
"девушка у окна, сжатая челюсть, холодный свет сбоку, за стеклом дождь, фон мягкий и размытый"
вместо простого перечисления эффектов через запятую.
❌ Эмоция одним словом → размытая зона латентного пространства → шаблонный результат.
✅ Эмоция через тело + поза + атмосфера → точные координаты → сцена, которую хочется рассматривать.
Для живых эмоций и красивой генерации лучше думать в стиле не какое чувство испытывает герой, а что конкретно видно зрителю в кадре.
Штош, опять много получилось.. 😔
Post #154
85




- 🔥 5