
Ускорили перевод видео в Яндекс Браузере — задистиллировали диффузионный декодер TTS
Сегодня делимся свежей хабростатьёй о том, как ускорили синтез речи при переводе видео в Яндекс Браузере.
С чего стартовали
Внутри TTS — каскад из трёх частей:
🔴языковая модель предсказывает аудиотокены по тексту;
🔴диффузионный декодер восстанавливает мел-спектрограмму из латентов;
🔴вокодер превращает её в звуковую волну.
После того как оптимизировали языковую модель (она долго была самой тяжёлой), узким местом стал декодер латентов: его forward pass запускается на каждом шаге семплинга, а шагов — десятки. Его и взялись ускорять.
Что сделали с аттеншном
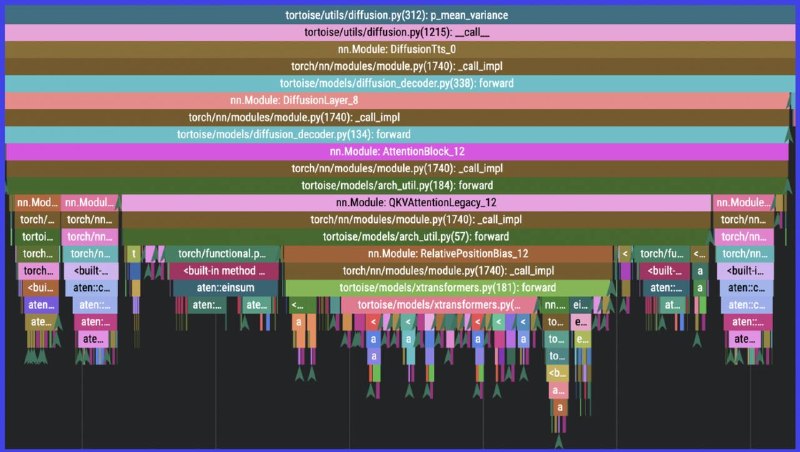
Прогнали инференс через torch.profiler и увидели, что время съедают рукописный QKVAttention и пересчёт RelativePositionBias на каждой итерации. Дальше — по нарастающей:
🔴перевели self-attention на SDPA (memory-efficient) и закешировали bias → 2,5× на уровне QKVAttention и почти вдвое меньше GPU-памяти, всё без переобучения;
🔴проверили гипотезу RoPE + FlashAttention — и честно её похоронили, так как на наших размерах тензоров она не обогнала кешированный бейзлайн. Зато получили полезный отрицательный результат;
🔴как более сильную архитектуру посмотрели DiT (на него уже перешли F5-TTS, CosyVoice3): качество выше, латенси сопоставимое.
Главный буст — дистилляция флоуматчинга
Самое интересное — поверх флоуматчинг-декодера навесили две дистилляции:
🔴CFG-distill: вместо двух forward pass'ов на шаг (conditional + unconditional) student воспроизводит guided-предсказание за один проход;
🔴progressive distillation: student учится за один шаг делать то, что teacher делает за два, и число шагов итеративно уменьшается вдвое.
Вместе это срезало число шагов семплинга с ~20 до 3 при паритете качества по SBS (наивное снижение шагов так не умеет — звук заметно проседает). Бонус progressive distillation — почти не пришлось трогать прод-код инференса, поменяли число шагов в конфиге.
Итог
Эти ускорения вместе дали примерно 1,5× ускорения всего TTS-пайплайна целиком. На практике это позволило на четверть сократить использование GPU в TTS-компоненте.
Цырен-Доржо Цыбиков ❣ Специально для Speech Info
Post #163
918

- ❤ 20
- 🔥 11
- 👍 6