
Как мы прогнозировали вязкость многокомпонентных масел
В журнале Chemical Engineering Science вышла статья Predicting multi-component oil viscosity using machine learning methods — работа Владимира Дещеня, Николая Кондратюка и коллег из ИТМО.
Статья родилась по следам хакатона «Нефтекод – 2024», организованного Центром инфохимии ИТМО совместно с ООО «Газпромнефть-СМ». Компания предоставила обезличенный промышленный датасет по маслам, а наша команда soft matters тогда победила в конкурсе.
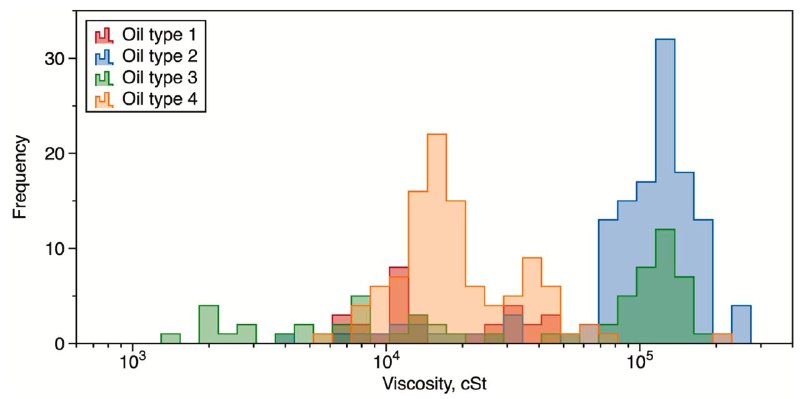
Задача состояла в предсказании кинематической вязкости базовых масел со сложным компонентным составом при -40°C, имея всего 469 составов с зашифрованными признаками (без явных концентраций компонентов и с большим числом пропусков). Чтобы не потерять важную информацию в неполных данных, мы отобрали признаки, значимые для разных типов масел, и научили модель работать с оставшимися пропусками. Уже на этой основе сравнили несколько подходов – от Decision Tree до Gradient Boosting.
Лучшая модель, Gradient Boosting, показала медианную ошибку 16.2% на тестовой выборке, обойдя как остальные ML-модели, так и классическую эмпирическую формулу Вальтера для температурной экстраполяции вязкости, которая в нашей задаче систематически занижала значения при низких температурах.
Тем самым мы продемонстрировали, что машинное обучение способно надёжно работать даже с зашифрованным и неполным промышленным датасетом без раскрытия точных рецептур.
Post #217
413
- 🔥 11
- 👍 3