🇺🇸🤖 США: Google открыла EmbeddingGemma 2 – мультимодальную модель эмбеддингов для локального RAG
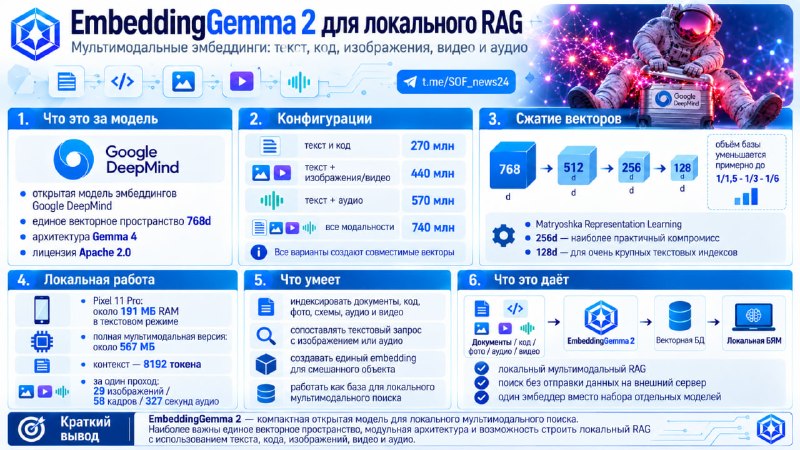
Компания Google DeepMind 6 октября представила EmbeddingGemma 2 – компактную открытую модель эмбеддингов, способную преобразовывать текст, программный код, изображения, видео и аудио в единое 768-мерное векторное пространство. Модель построена на архитектуре Gemma 4, веса опубликованы под Apache 2.0.
🔻 Главная особенность – модульная архитектура. Полная версия содержит 740 млн параметров, однако для работы только с текстом и кодом достаточно 270 млн. Отдельно подключаются зрительный кодировщик на 170 млн параметров и аудиокодировщик на 300 млн. В результате доступны конфигурации:
– текст и код – 270 млн;
– текст + изображения/видео – 440 млн;
– текст + аудио – 570 млн;
– все модальности – 740 млн параметров.
При этом все варианты создают совместимые векторы в одном пространстве. Это позволяет, например, проиндексировать текстовый архив облегчённой версией, а затем подключить поиск по изображениям, аудио и видео без создания отдельной системы представлений.
⚙️ EmbeddingGemma 2 поддерживает Matryoshka Representation Learning: стандартный вектор размерностью 768 можно уменьшать до 512, 256 или 128 измерений. Это сокращает объём векторной базы соответственно примерно до 1/1,5, 1/3 и 1/6 исходного размера.
Практически наиболее интересен режим 256 измерений: в мультимодальном тесте MMEB результат снижается с 59,01 до 56,24, тогда как при 128 измерениях уже до 45,65. Поэтому Google рекомендует 256d как компромисс для компактных мультимодальных баз, а 128d – прежде всего для очень крупных текстовых индексов.
📱 Модель рассчитана в том числе на работу непосредственно на мобильных устройствах. На Google Pixel 11 Pro оптимизированной текстовой конфигурации требуется около 191 МБ активной оперативной памяти, а полной мультимодальной – около 567 МБ. Таким образом, семантический поиск по собственным данным можно выполнять локально, не передавая документы и медиаматериалы на внешний сервер.
📌 Контекст составляет 8192 токена. При использовании одной модальности за один проход можно обработать примерно 29 изображений, 58 видеокадров или 327 секунд – около 5,5 минуты – аудио. Видео по умолчанию разбирается с частотой один кадр в секунду, однако частоту выборки можно менять.
🔻 Причём модель умеет создавать единый embedding для смешанного объекта. Например, описание изделия, несколько фотографий и видеозапись испытания можно представить одним вектором, а затем находить его обычным текстовым запросом. Аналогично текстовый запрос может непосредственно сопоставляться с фотографией или аудиозаписью – без обязательного промежуточного преобразования изображения в описание, а речи в текст.
📊 Наиболее заметно выросло качество работы с программным кодом. В MTEB Code результат увеличился с 68,76 у первой EmbeddingGemma до 78,68. В обычном многоязычном текстовом MTEB прирост значительно меньше – 61,15 → 61,36, то есть основное развитие второй версии связано именно с кодом и мультимодальностью.
🔵 Основное значение EmbeddingGemma 2 – возможность построить полностью локальный мультимодальный RAG на сравнительно слабом оборудовании. Вместо отдельных моделей для текста, изображений, распознавания речи и видео один компактный эмбеддер может индексировать PDF и другие документы, программный код, фотографии, схемы, записи переговоров и видеоматериалы, после чего искать связанные сведения между разными типами данных.
Post #2034
289