
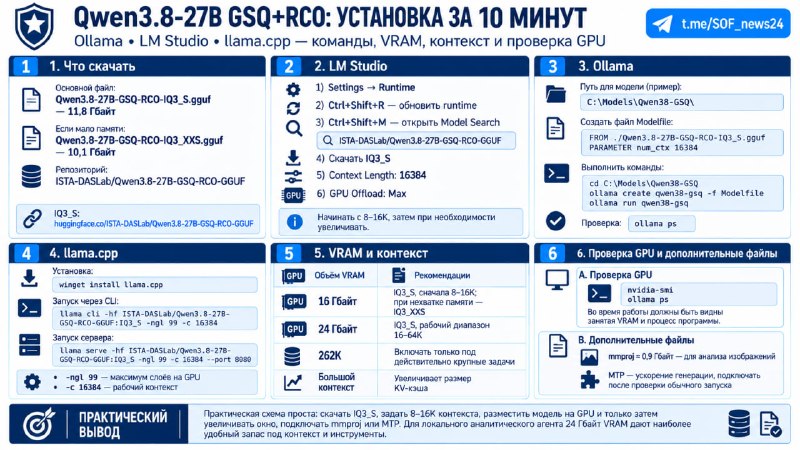
После выбора Qwen3.8-27B GSQ+RCO IQ3_S остаётся запустить модель локально. Специального программного обеспечения для GSQ или RCO не требуется: опубликован готовый файл GGUF размером 11,8 Гбайт, который поддерживается обычными средствами локального запуска.
📌 Самый простой вариант – LM Studio
После установки LM Studio необходимо обновить среду запуска
llama.cpp: Ctrl+Shift+R – обновить runtime. Затем открыть Model Search и найти:ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF
и скачать IQ3_S.
При первой загрузке модели целесообразно установить:
Context Length: 16384
GPU Offload: Max
Начинать сразу с заявленных 262K токенов не следует. Сначала проверяется работа на 16K, затем окно можно увеличить до 32–64K в зависимости от свободной видеопамяти. LM Studio позволяет заранее оценить расход памяти с учётом контекста и размещения модели на GPU.
🔻 Ollama
Сначала файл
Qwen3.8-27B-GSQ-RCO-IQ3_S.gguf сохраняется, например, в:C:\Models\Qwen38-GSQ\
В этой же папке создаётся файл
Modelfile:FROM ./Qwen3.8-27B-GSQ-RCO-IQ3_S.gguf
PARAMETER num_ctx 16384
После этого в PowerShell:
cd C:\Models\Qwen38-GSQ
ollama create qwen38-gsq -f Modelfile
ollama run qwen38-gsq
Проверить, где фактически выполняется модель:
ollama ps
Если часть вычислений перенесена на процессор, необходимо уменьшить контекст, освободить видеопамять либо перейти на IQ3_XXS размером 10,1 Гбайт. Импорт готовых GGUF через
Modelfile является штатным способом работы Ollama с такими моделями.🔻 llama.cpp – наиболее прямой вариант
В Windows установка выполняется командой:
winget install llama.cpp
После этого модель можно скачать с Hugging Face и сразу запустить:
llama cli -hf ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF:IQ3_S -ngl 99 -c 16384
-ngl 99 задаёт размещение максимально возможного числа слоёв на видеокарте, а -c 16384 – рабочий контекст.Для подключения локального агента удобнее сразу поднять сервер:
llama serve -hf ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF:IQ3_S -ngl 99 -c 16384 --port 8080
В результате Qwen становится доступна локальным приложениям через API.
📌 Как настроить видеопамять
🔻 16 Гбайт VRAM – начать с IQ3_S + 8–16K контекста. Закрыть приложения, использующие GPU. Если памяти недостаточно – уменьшить контекст или использовать IQ3_XXS.
🔻 24 Гбайт VRAM – IQ3_S уже оставляет заметный запас. Практический рабочий диапазон для аналитического агента – 16–64K, увеличиваемый под конкретный документ или исследование.
🔻 262K имеет смысл включать только тогда, когда задача действительно требует такого объёма. Вместе с контекстом увеличивается размер KV-кэша, поэтому максимальное окно напрямую уменьшает запас памяти для других функций.
Проверить использование NVIDIA можно обычной командой:
nvidia-smi
Во время генерации должны быть видны занятая видеопамять и процесс программы, через которую запущена модель.
🔻 Мультимодальность подключается отдельно.
Для первого запуска достаточно самого
IQ3_S.gguf. Если требуется анализ изображений, дополнительно загружается mmproj около 0,9 Гбайт, обеспечивающий обработку изображения и передачу полученных признаков языковой модели. Вариант с MTP также лучше подключать уже после проверки стабильной работы обычной IQ3_S.