
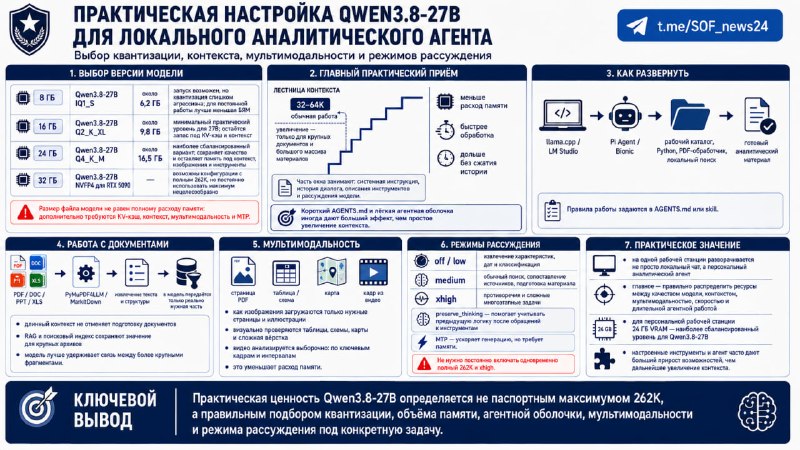
Продолжая тему локального развёртывания Qwen3.8-27B, практические возможности модели определяются не столько заявленным контекстом 262K, сколько выбранной квантизацией, объёмом видеопамяти и настройкой самого агента.
📌 Выбор версии модели
🔻 8 Гбайт – Qwen3.8-27B IQ1_S, около 6,2 Гбайт. Запуск возможен, но квантизация слишком агрессивная для постоянной аналитической работы. Практичнее использовать меньшую модель более высокого качества.
🔻 16 Гбайт – Qwen3.8-27B Q2_K_XL, около 9,8 Гбайт. Остаётся запас под KV-кэш и достаточно большой рабочий контекст. Это уже минимальная конфигурация, на которой 27B имеет практический смысл.
🔻 24 Гбайт – Qwen3.8-27B Q4_K_M, около 16,5 Гбайт. Наиболее сбалансированный вариант для RTX 3090/4090: Q4 сохраняет качество модели и оставляет память под длинный контекст, изображения и инструменты агента.
🔻 32 Гбайт – Qwen3.8-27B NVFP4 для RTX 5090. Уже существуют конфигурации с полным 262K, однако использовать максимальное окно постоянно нецелесообразно.
📌 Главный практический приём – не выделять агенту 262K заранее.
Для обычной работы достаточно 32–64K. Контекст увеличивается только при необходимости разобрать крупный документ или одновременно сопоставить большой массив материалов. Это оставляет больше памяти под KV-кэш, ускоряет обработку и позволяет дольше работать без сжатия истории.
Кроме того, часть окна занимает не сам документ, а системная инструкция, история диалога, описания инструментов и рассуждения модели. Поэтому лёгкая агентная оболочка и короткий
AGENTS.md иногда дают больший эффект, чем простое увеличение контекста.🔻 Мультимодальность также лучше использовать выборочно.
После обработки PDF через PyMuPDF4LLM или MarkItDown основной текст передаётся модели в текстовом виде. Как изображения загружаются только необходимые таблицы, схемы, карты и страницы со сложной вёрсткой.
С видео действует тот же принцип: вместо часовой записи агент сначала определяет интересующие временные интервалы или отбирает ключевые кадры, после чего Qwen выполняет их визуальный анализ. Это существенно уменьшает расход памяти.
🔻 Режим рассуждений следует менять по задаче.
off / low – извлечение характеристик, дат и классификация;medium – обычный поиск, сопоставление источников и подготовка материала;xhigh – сложные противоречия и многоэтапное исследование.Для продолжительных задач полезен preserve_thinking, позволяющий учитывать предыдущую логику после обращения к инструментам. Однако накопившуюся историю целесообразно периодически сворачивать в краткий рабочий файл.
MTP может заметно ускорить генерацию, но также требует памяти. На ограниченной видеокарте иногда выгоднее направить этот ресурс на дополнительный контекст.
🔵 Практический смысл настройки заключается не в попытке включить все возможности Qwen3.8-27B одновременно, а в распределении ресурсов под конкретную задачу: качество модели, контекст, мультимодальность, скорость или длительная агентная работа.
Для персональной рабочей станции 24 Гбайт VRAM сейчас выглядят наиболее сбалансированным уровнем для Qwen3.8-27B, а правильно настроенные инструменты и агент зачастую дают больший прирост возможностей, чем дальнейшее увеличение размера контекста.