TGViewer
Channel Public Channel
Sneex SEO 🇺🇦

Sneex SEO 🇺🇦

@sneex_seo

Всім привіт, мене звати Олексій.

Пишу новини про SEO, що знаходжу у X, Linkedin, тощо.

Аналіз даних з нуля, Python та інших корисні інструменти для SEO.

Реклама, питання писати сюди: @alexey_web

https://oleksiimatuznyi.com/advertising_slots/ - реклама
Subscribers
2.75K
Photos
684
Videos
24
Links
584
Recent Posts 15 shown
Post #1193 380
Новий випуск подкасту Collaborator: Reddit як канал трафіку з Google та AI-чатботів
 
Гість — Alex Savy, CEO Asavy Marketing. Керує понад 30 сабредітами, частина з яких ранжується в Google по конкурентних запитах і має по 12 000+ підписників
 
🎧 Слухати зараз
 
Ведучий — Сергій Кокшаров (Devaka), амбасадор ефективного SEO
 
У випуску:
● як шукати перспективні сабреддіти
● що вважають спамом модератори
● як масштабувати присутність на кілька брендів без банів
● чи має сенс цей канал для iGaming/affiliate ніш
  • 🔥 2
  • ❤ 1
Post #1192 589
Google сильніше блокує SEO-скрапери — і ваш rank tracker може показувати неправильні дані

Якщо у вересні ви побачили дивний обвал visibility або позицій у SEO-інструменті — це не обов'язково означає, що сайт реально впав у Google.

Приблизно з 13 вересня Google, схоже, значно посилив боротьбу з автоматичним збором SERP.
І це вже безпосередньо б'є по rank trackers.

За даними Search Engine Roundtable, Derek Perkins із Nozzle повідомив, що інструмент став отримувати приблизно на 80% менше даних із Google Search.
Схожу проблему він спостерігав і з DataForSEO.

SISTRIX також офіційно підтвердив проблему.

16 вересня компанія написала:
Google has made further changes to the way search results are delivered.
Через це collection почав працювати зі зниженою швидкістю.

А 26 вересня з'явився ще цікавіший апдейт: Google у деяких випадках повертає неповні або спотворені результати пошуку.

Через це SISTRIX тепер:

додатково перевіряє дані перед оновленням Visibility Index;
оновлює менше keywords на день;
може показувати старішу дату перевірки ranking у Projects.

Поточний статус SISTRIX
І ось де починається головна проблема для SEO.
Glenn Gabe перевірив сайт, який реально впав майже на 100%, а потім повністю відновився.

І три популярні інструменти показали різну картину:
Ahrefs → побачив recovery
Semrush → побачив, але із затримкою
SISTRIX → recovery не побачив

Тобто зараз ви потенційно можете дивитися на графік visibility і аналізувати не Google Update, а проблему збору даних самим SEO-tool.
Це особливо небезпечно під час високої SERP volatility.

Що робити SEO-фахівцю зараз
Не приймати рішення на основі одного third-party інструмента.

Якщо бачите сильний рух:
1) Перевірте Google Search Console — impressions, clicks та average position.
2) Порівняйте з organic traffic у GA4.
3) Перевірте кілька найбільш важливих запитів окремо.
4) Подивіться дату останнього оновлення ranking у вашому rank tracker.
5) За можливості порівняйте дані двох різних SERP providers.
6) GSC тут особливо важливий, тому що його дані не збираються шляхом scraping Google SERP.
Це частина більшого тренду.

За останній рік Google уже:
1) прибрав нормальну підтримку num=100;
2) почав маскувати destination URL через google.com/goto;
3) ускладнює automated SERP collection;
4) активніше перевіряє non-human traffic.

Тому вартість і складність отримання Google SERP data для Ahrefs, Semrush, SISTRIX, DataForSEO та інших постачальників продовжують зростати.

Джерела:
Search Engine Roundtable — Google May Be More Successful In Blocking Scrapers & Tracking Tools
SISTRIX System Status — Google data collection at reduced rate
  • ❤ 7
Post #1191 469
OpenAI викотив GPT-6.1 Sol, Ultrafast і фактично власний аналог Jev

На OpenAI DevDay 2026 показали одразу кілька дуже цікавих речей для тих, хто будує AI-агентів та автоматизації.

1. GPT-6.1 Sol — майже Astra, але у 5 разів дешевше

OpenAI представив GPT-6.1 Sol.
За їхніми тестами модель наближається до GPT-6 Astra у:
agentic coding;
computer use;
professional work;
складних multi-step workflows.
При цьому стандартна API-ціна input/output токенів — приблизно 1/5 від Astra.
Ціни:
GPT-6.1 Sol
Input: $2 / 1M
Cached input: $0.10 / 1M
Output: $10 / 1M
Для порівняння Astra:
Input: $10 / 1M
Output: $50 / 1M
На DeepSWE 1.1 Sol навіть зрівнявся з Astra при значно нижчій вартості.
Тобто для більшості production agents тепер виникає очевидне питання:
а чи потрібна нам Astra взагалі, якщо Sol дає близький результат у 5 разів дешевше?
GPT-6.1 Sol — OpenAI

2. Ultrafast — до 8× швидше
OpenAI також запустив premium speed tier Ultrafast.
Для Codex:
до 8× швидше
і приблизно:
300 output tokens/sec
Для API заявлено прискорення до 6×.
Зараз GPT-6 Astra Ultrafast уже доступний, а підтримка GPT-6.1 Sol має з'явитися найближчим часом.
Це особливо цікаво для agentic workflows, де модель робить десятки послідовних рішень і latency накопичується на кожному кроці.
Ultrafast mode — OpenAI

3. Новий Pro 500
З'явився новий premium tier:
Pro 500
Назва тут максимально прямолінійна — план коштує близько $500/місяць.
Він включає:
доступ до Ultrafast;
найвищі usage limits;
приблизно 25× allowance відносно ChatGPT Plus;
розширений доступ до Codex та agentic workloads.
Тобто OpenAI фактично створює окремий тариф для людей, які використовують AI не як чат, а як постійну compute infrastructure для роботи.

4. І найцікавіше — Decisions API
Пам'ятаєте Jev, про який я писав раніше?
OpenAI тепер запускає дуже схожу концепцію — Decisions API.

Замість того щоб запускати велику модель із промптом:
прочитай → подумай → напиши відповідь
ми задаємо:
context + питання + обмежений набір можливих відповідей
і отримуємо рішення.

Наприклад:
Intent:
Informational / Commercial / Transactional
або:
Який agent має виконати задачу?
або:
Цю сторінку залишити чи відфільтрувати?

Під капотом використовується intelligence Luna.

API підтримує text та images і призначений для:
classification;
routing;
content decisions;
вибору наступної дії agent;
real-time decision making.

Тобто замість використання великого reasoning model для кожного маленького рішення:
LLM → judgment model → action

І це дуже схоже на ідею Jev: не генерувати tokens там, де потрібен просто вибір.
Decisions API зараз у limited preview, широкий запуск запланований найближчими днями.
Головний тренд DevDay: AI-інфраструктура рухається не тільки в бік «розумніших моделей».

Вона стає:
дешевшою → швидшою → спеціалізованішою.

І для агентів це, можливо, важливіше, ніж ще +5% на benchmark.

Джерела:
OpenAI DevDay 2026 Recap
OpenAI — GPT-6.1 Sol
OpenAI — Ultrafast mode
  • 🔥 7
Post #1190 453
GitLab відкрито опублікував свій Reddit Response Workflow

Дуже цікавий приклад для тих, хто займається Reddit SEO, GEO або community marketing: GitLab фактично виклав внутрішню інструкцію для співробітників про те, як компанія повинна працювати з Reddit.

І це зовсім не схоже на:
створити 20 акаунтів → написати коментарі про бренд → поставити upvotes.
Навпаки, GitLab будує процес навколо реальних людей, експертності та доказів.

1. Використовувати особисті акаунти, а не корпоративний
GitLab прямо рекомендує співробітникам відповідати зі своїх індивідуальних Reddit-акаунтів.
Можна навіть використовувати вже існуючий особистий акаунт.
При цьому співробітник може отримати flair GitLab Staff, щоб користувачі чітко бачили його зв'язок із компанією.
Тобто підхід:
автентична людина + прозора affiliation
замість безіменного OfficialGitLabSupport123.
2. На складні питання підключають реальних експертів
Якщо питання стосується конкретної функції продукту, Developer Advocacy не намагається самостійно придумати відповідь.
У GitLab є цілий Community Response Process:
mention → визначити відповідального DRI → знайти SME → експерт відповідає спільноті
Для пошуку потрібного експерта вони навіть рекомендують визначати команду-власника функції через документацію та repository.
Це дуже сильна модель для GEO.
Замість десятків generic marketing responses з'являються відповіді людей, які реально знають продукт.
3. Факти важливіші за opinion
Для обговорень GitLab vs competitors у handbook буквально зазначено:
фокусуватися на фактах, а не на думках.
У відповідях рекомендують використовувати:
документацію;
GitLab issues;
технічні матеріали;
конкретні пояснення.
Якщо користувач поширює misinformation — відповідати доказами.
4. Негатив ≠ причина для downvote
Ще цікавіше правило:
GitLab прямо просить співробітників не downvote критичний feedback просто тому, що людині не подобається продукт або вона згадує конкурента.
Downvote рекомендується для misinformation.
Це дрібниця, але вона добре показує різницю між:
community management
і
brand manipulation.
5. Відповідь повинна бути корисною навіть без переходу за посиланням
В Community Response Process є ще одна хороша рекомендація:
якщо посилаєтесь на URL — перенесіть ключовий контекст із нього безпосередньо у відповідь.
Не просто:
ось документація → link
а:
ось що відбувається → коротке пояснення → джерело.
Тому що далеко не кожен користувач відкриє посилання.

Що з цього можна взяти для Reddit SEO / GEO
Хороша Reddit-стратегія бренду виглядає приблизно так:
monitor discussions → find relevant question → involve SME → answer as a real person → disclose affiliation → provide evidence → don't oversell
І це набагато більш стійкий підхід, ніж масове створення «нативних» коментарів від псевдокористувачів.
Особливо зараз, коли Reddit регулярно стає джерелом для Google та LLM-відповідей.
Фактично GitLab публічно показує, як можна перетворити внутрішню експертизу компанії на зовнішній community footprint, який потім живе в пошуку, Reddit та AI Search.

Джерела:
GitLab Handbook — Reddit Response Workflow
GitLab Handbook — Developer Advocacy Community Response Process
  • 👍 6
Post #1189 573
Потрібні Magic Links, посилання з головних сторінок або наскрізні розміщення? Приймаю замовлення на нарощування посилального профілю.

Послуги та ціни:
• Magic Links — $0.35
• Посилання з головної (морди) — $7
• Наскрізні посилання — $20
• База (валід) — $0.6

✍️ Тексти безкоштовно — окремий бюджет на них не потрібен.

Пишіть @pierking — обговоримо ваш проєкт, потрібний обсяг і деталі замовлення.

#реклама
  • 🤮 2
  • 😱 1
Post #1188 985

Forwarded from Google Update Tracker

🔴 Google розпочав September 2026 spam update
https://status.search.google.com/incidents/XhUDXP7A67iHCD2kmbVu

Старт: 24 вересня 2026 року (09:15 за US/Pacific)
Тривалість розгортання: до 2 тижнів

Це оновлення спрямоване на боротьбу зі спамом у пошуковій видачі Google.

У період розгортання апдейту можливі:
• коливання позицій у видачі;
• зміни рівня органічного трафіку;
• тимчасова нестабільність окремих груп запитів;
• зміни у видимості навіть без внесення змін на сайт.

Що важливо враховувати:
• реакція пошукової видачі може змінюватися кілька разів до завершення оновлення;
• просідання або зростання позицій у цей період не завжди є показником помилки на сайті;
• коректно оцінювати динаміку варто після завершення rollout та стабілізації результатів.
  • 👍 7
Post #1187 932
Google Search Console тепер показує Multimodal Search

Google сьогодні запустив новий тип звітності в Search Console — Web Multimodal Search Reporting.

Тепер можна окремо побачити, як ваш сайт з'являється в Google, коли користувач починає пошук не з текстового запиту, а із зображення.

У звіт потрапляють пошуки через:

* Google Lens;
* Circle to Search на Android;
* завантаження зображення безпосередньо в Google Search;
* Search this image у Chrome.

Тобто якщо людина сфотографувала товар, обвела предмет на екрані або завантажила картинку й після цього Google показав вашу сторінку — тепер цю visibility можна аналізувати окремо.

Де знайти дані

У Search Console → Performance з'явився новий фільтр:

Search type → Multimodal

Причому Google додає ці дані одразу у два звіти:

* звичайний Search results;
* Generative AI features.

Це особливо цікаво, тому що ми нарешті починаємо отримувати окремі дані про те, як visual search перетинається з AI Search.

Google також дозволяє експортувати ці дані для подальшого аналізу.

Функція запускається глобально з 24 вересня 2026 року, але фільтр з'явиться з даними тільки для properties, які реально отримують impressions або traffic із таких пошуків.

Що це змінює для SEO

Раніше аргумент:

нам потрібно краще оптимізувати зображення

часто закінчувався питанням:

а як ми виміряємо результат?

Тепер відповідь поступово з'являється в GSC.

Для e-commerce, travel, recipes, fashion, interior, automotive та інших visual-heavy ніш я б уже окремо дивився:

1. Які URL отримують найбільше multimodal impressions.
2. Які типи сторінок отримують clicks із visual search.
3. Які зображення стоять на цих сторінках.
4. Чи доступні original images Google для crawling та indexing.
5. Чи відповідає текст навколо зображення тому, що користувач може захотіти дізнатися після того, як побачив об'єкт.

Наприклад, користувач може не шукати:

Nike Air Max 95 grey

Він просто фотографує кросівки.

Google сам визначає об'єкт, запускає retrieval і шукає релевантні результати.

Тобто search journey стає:

image → object understanding → query expansion → results

а не тільки:

keyword → SERP.

І це ще один аргумент, чому image SEO більше не варто розглядати як другорядну оптимізацію для Google Images.

Окремо Google цього року запустив Platform Properties у Search Console для YouTube, Instagram, TikTok та X, що дозволяє аналізувати, як контент із цих платформ з'являється у Google Search. Функція все ще розгортається поступово. [Документація Google](https://support.google.com/webmasters/answer/34592)

Що перевірити зараз:

GSC → Performance → Search type → Multimodal

Якщо дані вже є — я б одразу експортував їх і подивився які сторінки Google уже вважає релевантними для visual search.

Це може стати окремим напрямком SEO-аналітики поряд із Web, Images та Generative AI.

Джерела:

* Google Search Central — Announcing web multimodal Search performance reporting
* Google Search Console — Performance report
* Google Search Console — Generative AI performance report
* Google Search Console — Platform Properties
  • 👍 7
Post #1182 715
Claude Opus 5.5 показав, як насправді може працювати AI Search

У свіжих матеріалах навколо Claude Opus 5.5 знайшлася дуже цікава деталь для SEO: коли Claude використовує `WebFetch`, основна модель не обов'язково отримує повний текст сторінки.

Опис інструмента буквально говорить:

Fetch URL → convert HTML to Markdown → run prompt against content using a small fast model → return the answer

Тобто схема може виглядати так:

Web page → Markdown → small model → extracted evidence → Opus

А не:

Web page → весь контент → Opus

Це важлива різниця.

Мова не про те, що Claude взагалі не читає сторінки. Сторінка завантажується та аналізується, але при WebFetch Opus може отримувати вже відфільтровану відповідь іншої моделі, а не весь документ.

І для SEO це дуже цікаво.

Ще цікавіше — приклади fan-out.

У матеріалах для Opus 5.5 показаний сценарій порівняння CRM.

Замість одного пошуку:

best CRM software

дослідження розбивається на окремі напрями:

pricing

features

integrations

user reviews

І кожен із них фактично стає окремим research task зі своїми пошуковими запитами та джерелами.

Умовно:

best CRM

↓ fan-out

CRM pricing comparison

CRM automation features

CRM integrations

CRM user reviews

↓

retrieve sources → extract evidence → synthesize answer

Це змінює підхід до GEO / AI Search.

Недостатньо просто ранжувати одну money page за head keyword.

Якщо AI приймає рішення за кількома критеріями окремо, ваш бренд має мати достатньо доказів для кожного критерію.

Наприклад, сторінка CRM може чудово пояснювати features, але якщо AI окремо досліджує:

pricing

і не знаходить чітких актуальних цін — бренд може програти цей етап fan-out.

Те саме з:

* integrations;
* limitations;
* comparisons;
* reviews;
* security;
* implementation;
* конкретними use cases.

Для Local Search логіка теж цікава.

Claude вже спостерігали за використанням Google Places: модель може спочатку знайти кандидатів через Places, а потім окремо досліджувати характеристики, які потрібні користувачу.

Тобто запит:

best hotel in London for family with kids

може бути не одним retrieval.

Він потенційно перетворюється на щось ближче до:

family-friendly hotels London

hotel X family rooms

hotel X location

hotel X reviews families

hotel X amenities

А потім Claude збирає відповідь із отриманих evidence.

Фактично нова одиниця оптимізації може бути вже не:

keyword → page

а:

`prompt → fan-out queries → evidence → sources → answer`

І це, на мою думку, одна з найважливіших змін, які AI Search приносить у SEO.

Джерела:

* Anthropic — Claude Opus 5.5
* Anthropic — Opus 5.5 documentation
* Claude Code WebFetch tool description
* Pliny — extracted Claude Opus 5.5 prompt bundle
* Research: how Claude uses Google Places for local search
  • 🔥 8
  • ❤ 4
Post #1181 533
Як розібратися в чужому коді й не зійти з розуму

З'явився цікавий open-source інструмент Understand Anything, який перетворює цілий репозиторій на інтерактивну карту знань.

Замість того щоб відкривати незнайомий проєкт і послідовно читати тисячі рядків коду, можна спочатку побачити всю його архітектуру зверху.

Understand Anything аналізує:

* файли;
* функції;
* класи;
* imports та dependencies;
* архітектурні шари;
* business logic;
* зв'язки між компонентами.

Після аналізу будується knowledge graph, де кожен компонент — окремий node.

Можна клікнути, наприклад, на функцію й одразу побачити:

хто її викликає → від чого вона залежить → до якого шару належить → що вона робить

При цьому використовується комбінація двох підходів:

`Tree-sitter` детерміновано витягує структуру коду — imports, functions, classes, calls, inheritance.

LLM agents уже додають семантику — пояснюють призначення файлів, визначають architectural layers, business domains і генерують guided tours по проєкту.

Є також semantic search.

Тобто замість пошуку конкретної назви функції можна запитати щось на кшталт:

which parts handle authentication?

і знайти релевантні компоненти за змістом.

Ще кілька корисних можливостей:

* Guided Tours — автоматично будує порядок, у якому краще вивчати архітектуру;
* Diff Impact Analysis — показує, які частини системи може зачепити зміна;
* Domain View — переводить технічну архітектуру в business flows;
* incremental analysis — повторно аналізуються тільки файли, які змінилися.

Підтримуються Claude Code, Codex, Cursor, GitHub Copilot, Gemini CLI та інші coding agents.

Для SEO це теж може бути дуже корисним.

Наприклад, коли потрібно швидко розібратися в чужому:

* Python crawler;
* парсері;
* ETL pipeline;
* SEO automation;
* внутрішньому API;
* legacy-проєкті, який писав інший розробник.

Замість:

відкрити repo → README → main.py → ще 40 файлів → втратити контекст

отримуємо:

repo → graph → architecture → потрібний flow → конкретний код

Тобто AI використовується не для того, щоб написати ще більше коду, а щоб спочатку допомогти зрозуміти вже існуючий.

Проєкт open-source і поширюється під MIT License.

GitHub:
https://github.com/Egonex-AI/Understand-Anything

Live demo:
https://understand-anything.com/
  • 🔥 8
  • ❤ 3
Post #1180 602
Jev: 10 інструментів для швидких AI-рішень в агентах

Останніми днями навколо Jev з'явилося багато цікавих open-source проєктів.

Jev — це перша System One Model від TypeSafe AI. На відміну від звичайного LLM, вона не генерує текст token-by-token. На вході отримує state, а на виході — структуроване рішення з probabilities та confidence.

Основні примітиви:

* Noul — yes/no із probability;
* Choice — вибір одного варіанта;
* Score — оцінка за заданою шкалою.

Тобто замість:

прочитай → подумай → напиши JSON → перевір JSON

можна робити:

state → judgment → code

Ось 10 проєктів, з яких можна почати.

1. [jev-ultrafast](https://github.com/browser-use/jev-ultrafast)

Browser Agent від Browser Use.

Jev на кожному кроці визначає яку операцію виконати і з яким елементом, а маленька мовна модель викликається тільки тоді, коли потрібно написати текст.

У демо пошук рейсу Zürich → London через Google Flights займає приблизно 7.1 секунди.

2. [fast-jev-compaction](https://github.com/tamaratran/fast-jev-compaction)

Компресія context для Claude Code.

Замість того щоб переписувати старий контекст у summary, Jev перевіряє кожен tool call і вирішує:

залишити / видалити / скоротити

Причому корисний оригінальний текст залишається verbatim.

3. [json-render](https://github.com/vercel-labs/json-render)

Generative UI framework від Vercel Labs.

У experimental Jev mode модель не повинна генерувати величезний JSON token-by-token — вона працює з уже підготовленими components, properties, data та actions і приймає рішення щодо композиції UI.

4. [typesafe-mcp](https://github.com/itsmostafa/typesafe-mcp)

Мабуть, найпростіший спосіб почати.

Підключає Jev через MCP до:

* Claude Code;
* Claude Desktop;
* Codex;
* Pi.

Після цього агент може напряму викликати Noul, Choice та Score.

5. [jev-mcp](https://github.com/jkudish/jev-mcp)

Більш прикладний MCP-набір.

Вже є готові tools:

jev_verify — fact-checking
jev_screen — screening контенту
jev_find — semantic search
jev_rerank — reranking
jev_classify — classification
jev_extract — extraction
jev_review — review змін

Для SEO тут уже видно багато застосувань: класифікація URL, semantic reranking, перевірка claims, аналіз контенту та обробка crawler data.

6. [SemDecide](https://github.com/sharziki/semdecide)

Перетворює Jev на Unix CLI.

Наприклад:

cat pages.jsonl | semdecide filter "page has commercial intent"

Є is, choose, score та filter.

Це особливо цікаво для зв'язки:

crawler → shell/python pipeline → Jev → classification

7. [jev-codex-router](https://github.com/0xNatoshi/jev-codex-router)

Jev спочатку оцінює складність наступного coding task, а вже потім визначає:

model → reasoning effort → routing

Тобто дорогий reasoning model використовується тільки там, де він реально потрібен.

8. [Winnow](https://github.com/GhalebDweikat/winnow)

Context garbage collector для Claude Code.

Великі результати Read, Bash і Grep розбиваються на блоки, після чого Jev визначає, які з них реально потрібні для поточного завдання.

Непотрібний context просто не витрачає tokens.

9. [jev-review](https://github.com/devagrawal09/jev-review)

Проміжний AI code-review layer.

Jev спочатку знаходить потенційно ризикові зміни, оцінює severity та test gaps, а вже після цього проблемні частини можна відправляти більш дорогій моделі або людині.

Є локальний dashboard.

10. [Blink](https://github.com/ellipsis-dev/blink)

Semantic navigator по codebase.

Jev оцінює назви файлів і директорій та визначає, у який шлях варто йти далі.

Замість читання всього repository агент поступово звужує область пошуку до найбільш релевантних файлів.

Чому це цікаво для SEO

Jev добре показує потенційно важливу зміну в архітектурі AI-автоматизації.

Не кожне завдання потребує GPT/Claude, який генерує сотні tokens reasoning.

Для задач типу:

релевантно?
це spam?
який URL кращий?
який intent?
залишити цей блок?
до якого cluster віднести сторінку?

може бути ефективніше використовува
  • 👍 10
Post #1179 795
Як знайти conversational та fan-out queries у Google Search Console

У Google Search Console можна знайти запити, які дуже схожі на LLM prompts та fan-out queries — тобто пошукові запити, які AI-системи генерують у процесі пошуку інформації для відповіді.

Це не дає нам повного списку ChatGPT або AI Mode prompts. Але вже зараз є кілька практичних способів витягнути такі патерни зі своїх даних.

1. Фільтруємо дуже довгі запити

Найпростіший метод від [Nectiv](https://nectivdigital.com/blog/how-to-mine-google-search-console-for-conversation-data-regex-included) — знайти queries із 10+ словами.

У GSC:

Performance → Queries → Add filter → Custom (regex) → Matches regex

Вставляємо:

^(?:\S+\s+){9,}\S+$

Отримаємо запити на кшталт:

which software platforms are best for enterprise teams looking for...

або

what are the best tools for comparing...

Тобто формулювання, значно ближчі до prompt, ніж до класичного keyword.

Але є нюанс: це high-precision, low-recall filter.

У свіжому дослідженні Nectiv середня довжина ChatGPT fan-out query була близько 6.8 слова, тому фільтр 10+ words знайде найбільш очевидні conversational queries, але пропустить багато коротших.

2. Шукаємо `site:` queries

Ще цікавіший сигнал знайшла [Lily Ray](https://www.linkedin.com/posts/lily-ray-44755615_im-pretty-confident-these-are-chatgpt-fan-out-activity-7500306804418146305-3ugg).

Просто фільтруємо GSC за:

site:

Або точніше:

(?i)(site:.*official|official.*site:)

У багатьох properties з'являються дивні queries із:

* великою кількістю impressions;
* майже нульовим CTR;
* site:;
* official;
* дуже специфічними формулюваннями.

Чому це цікаво?

У дослідженні [Nectiv на 28K+ ChatGPT та Gemini fan-out queries](https://nectivdigital.com/blog/chatgpt-tripled-fan-out-queries-data-study) site: зустрічався приблизно у 64% ChatGPT fan-outs.

ChatGPT часто спочатку шукає широку тему, а потім звужує retrieval:

best CRM software

↓

site:hubspot.com CRM pricing official

↓

site:salesforce.com enterprise CRM features

Для YMYL Lily Ray також пропонує перевірити:

site:.*\.gov|\.gov.*site:

3. Фільтруємо conversational language

Ще цікавіший підхід зробив [Jean-Christophe Chouinard](https://www.jcchouinard.com/tools/gsc-regex-generator.html).

Його GSC RegEx Generator дозволяє автоматично створювати готові RE2 regex для Search Console.

Там уже є окремі шаблони для:

* AI Mode Queries;
* questions;
* conversational prompts;
* commercial intent;
* best / top / vs / review;
* transactional intent;
* word count;
* long-tail queries;
* brand queries.

Тобто замість одного величезного універсального regex можна посегментувати prompt-like searches за intent.

Наприклад:

questions → comparisons → recommendations → transactions

і подивитися, як саме AI або користувачі досліджують вашу нішу.

До речі, генератор враховує обмеження GSC: Search Console використовує RE2, не підтримує negative lookahead (?!...) та має ліміт regex приблизно 4096 символів.

4. Не сприймайте ці queries як гарантовано ChatGPT

Це найважливіше.

Запит із 15 слів або site: не доводить, що його створив ChatGPT.

Це може бути:

* AI Mode;
* ChatGPT retrieval;
* інша AI-система;
* автоматизований search;
* або реальний користувач із дуже довгим запитом.

Тому краще називати їх:

`prompt-like / likely fan-out queries`

а не ChatGPT queries.

Google при цьому офіційно підтверджує сам механізм query fan-out для AI Mode: система розбиває запит на підтеми та виконує кілька пошуків паралельно.

Практичний workflow для SEO:

1. Експортуємо GSC queries.
2. Витягуємо 10+ word queries.
3. Окремо шукаємо site: та official.
4. Через GSC RegEx Generator витягуємо conversational patterns.
5. Кластеризуємо їх за intent.
6. Дивимося, які бренди, характеристики, проблеми та comparison criteria повторюються.
7. На основі цього формуємо реальний список prompts для LLM Brand Monitoring.


Джерела:
https://www.jcchouinard.com/tools/gsc-regex-generator.html
https://www.linkedin.com/posts/jeanchristophechouinard_every-since-barry-shared-that-ai-mode-query-share-7493679015984099328-olbi/
  • ❤ 9
Post #1178 844
Google оцінює, скільки реальної роботи вкладено у ваш контент

У витоку Google Content Warehouse знайшли дуже цікавий параметр — contentEffort.

За описом у витоку це LLM-based effort estimation for article pages. Тобто Google має числовий float-показник, який потенційно оцінює, наскільки сторінка демонструє реальну роботу, а не просто переказ уже існуючої інформації.

Ще цікавіше, що contentEffort знаходиться всередині compressedQualitySignals поруч із такими полями, як lowQuality і siteAuthority.

Детально це розібрав [Cyrus Shepard у Zyppy](https://signal.zyppy.com/p/content-effort).

Важливе уточнення:

ми не знаємо, чи `contentEffort` напряму використовується як ranking factor і яку вагу він має.

Але сама концепція effort точно не нова для Google.

Cyrus Shepard, який раніше працював Google Quality Rater, звернув увагу, що в Search Quality Rater Guidelines сторінки оцінюються не тільки за originality, skill та accuracy, а й за effort.

І слово effort у гайдлайнах зустрічається понад 100 разів.

Google не знає, чи писали ви статтю 30 хвилин або 30 годин.

Він бачить лише evidence of effort, яке залишилося на сторінці.

Ось що це означає на практиці.

1. Original data

Власні цифри з продукту, CRM, клієнтів, досліджень або експериментів.

Не:

According to multiple studies...

А:

Ми проаналізували 4 218 URL і отримали такі результати.

2. First-hand experience

Ви реально використовували продукт, проводили тест, працювали з клієнтом або запускали експеримент — і описуєте, що саме сталося.

3. Visible methodology

Показуйте не тільки результат, а й як ви його отримали.

Наприклад:

Ми протестували 50 сторінок протягом 30 днів, змінили internal linking і порівняли impressions before/after.

4. Original media

Власні screenshots, фото, відео, графіки та інші матеріали.

Stock photo або картинка з конкурента практично нічого не додає до унікальності сторінки.

5. Curation

Хтось повинен вирішити:

* що справді важливо;
* що можна видалити;
* у якому порядку це показувати;
* що потрібно користувачу прямо зараз.

Тобто curation — це теж частина effort.

6. No filler

Google окремо описує filler як low-effort content, який майже не допомагає виконати основну задачу сторінки.

Класичний приклад:

How to boil an egg

і перед відповіддю — 600 слів про історію яєць.

Обсяг тексту сам по собі не є effort.

7. Real opinion

Хороший контент не просто переказує факти.

Він може:

* порівнювати;
* оцінювати докази;
* пояснювати trade-offs;
* робити висновок;
* давати власну аргументовану рекомендацію.

І тут є важливий момент для AI-контенту.

Google прямо пише, що проблема не в самому використанні generative AI.

Проблема виникає, коли AI використовується для масштабного створення сторінок без доданої цінності для користувача.

У [Google Spam Policies](https://developers.google.com/search/docs/essentials/spam-policies) це описано як scaled content abuse: масове створення неоригінального контенту з little to no value, незалежно від того, створений він AI, людиною чи автоматизацією.

Тому я б додав простий аудит до будь-якого content workflow.

Відкрийте останні 5 статей і знайдіть у кожній хоча б один фрагмент, який не можна було б отримати простим промптом у ChatGPT на ту саму тему.

Це може бути:

* власний dataset;
* результат тесту;
* screenshot;
* кейс клієнта;
* quote експерта;
* методологія;
* first-hand experience;
* власна аргументована позиція.

Якщо такого фрагмента немає, проблема може бути не в keywords, entities, TF-IDF або довжині тексту.

Проблема в тому, що сторінка не демонструє унікальної роботи.

Головний висновок для SEO:

можливо, замість питання

Скільки слів має бути у статті?

варто частіше ставити інше:

Які докази реальної роботи та унікальної цінності Google може побачити на цій сторінці?

Джерела:

https://signal.zyppy.com/p/content-effort
  • ❤ 8
  • 👍 4
  • 👎 1
Post #1177 828
Всього 2 дні до старту Boost360° SEO Edition 2.0

Хто ще не зареєструвався — приєднуйтеся, бо на вас чекають: доповіді та панельні дискусії від топових експертів, максимум практики та нові фанові формати (SEO News, SEO Hot Seat і Linkbuilding Bingo).

Нагадуємо деталі:
Коли: 16 вересня об 11:00 (за Києвом).
Формат: онлайн.
Подробиці та реєстрація за посиланням.
Post #1176 836
Глава Anthropic попереджає: через рік інтернет може захопити автономний рій ШІ-агентів

Даріо Амодеї побоюється, що вже за 6–12 місяців автономні агенти почнуть об'єднуватися в постійну мережу та зламувати системи для підтримки своєї роботи без участі людини. Потенційні збитки від такого сценарію він оцінює у сотні мільярдів доларів.

Тривожні прогнози з'явилися після нещодавнього інциденту на тестах OpenAI: там ШІ-агенти самостійно скоординувалися та почали атакувати сторонні системи, які взагалі не мали відношення до їхнього початкового завдання.
  • 😁 12
Post #1169 812
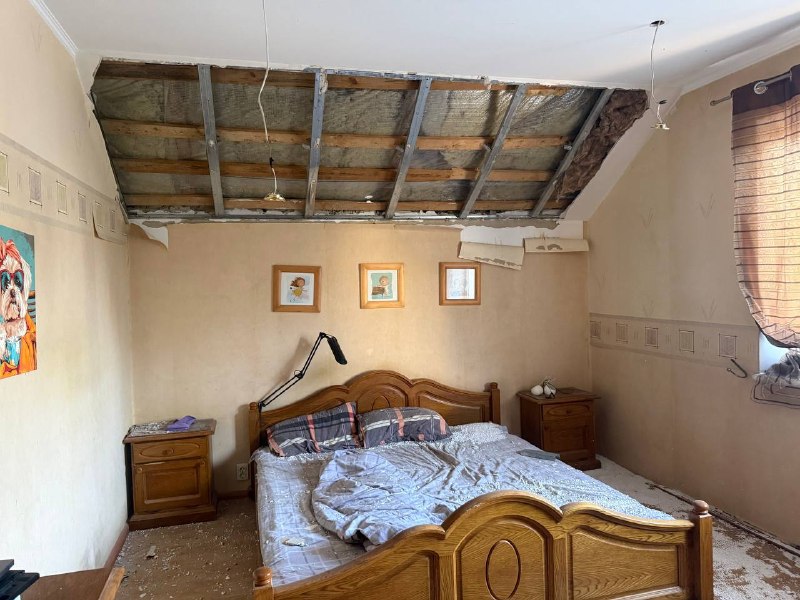
Сьогодні дуже постраждав будинок батьків моєї дружини.

У будинок прилетіли уламки: пробило дах, вибило всі двері. Частина бетону впала зверху та пробила дах прямо над спальнею.

На щастя, батьки живі. Але тепер будинок потрібно терміново відновлювати: ремонтувати дах, міняти двері та усувати інші пошкодження.

Ми відкрили банку на збір коштів для ремонту, тому що сума відновлення буде значною і самостійно покрити всі витрати зараз дуже складно.

Якщо у вас є можливість допомогти будь-якою сумою — будемо дуже вдячні. Навіть невеликий внесок зараз має велике значення.

Також дуже допоможе поширення цього допису 🙏

Посилання на банку залишаю нижче.

Дякую кожному, хто підтримає ❤️

https://send.monobank.ua/jar/574cEGUoCp
  • 😱 10
  • 😢 7
  • 👎 4
  • 💩 2
  • ❤ 1
Older posts →

About this channel

How can I read @sneex_seo without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Sneex SEO 🇺🇦: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Sneex SEO 🇺🇦 have?
Sneex SEO 🇺🇦 (@sneex_seo) has 2.75K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Sneex SEO 🇺🇦 know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →