
Если хотите оптимизировать контент для ChatGPT - сосредоточьтесь на верхней части страницы! / Kevin Indig
Данное SEO-исследование показало, что первые 30% контента приводят к 44% цитирований.
Отличное исследование провел Кевин Индиг (Kevin Indig). Он проанализировал 18 тысяч различных цитат в ChatGPT. Затем, используя данные Gauge + семантическое сходство, стало возможным определить, откуда берутся цитаты на странице. Они преобразовали цитаты и текст страницы во вложения и использовали % сходства для измерения того, из каких частей страницы было взято цитирование.
В итоге, было найдено много интересных данных, включая:
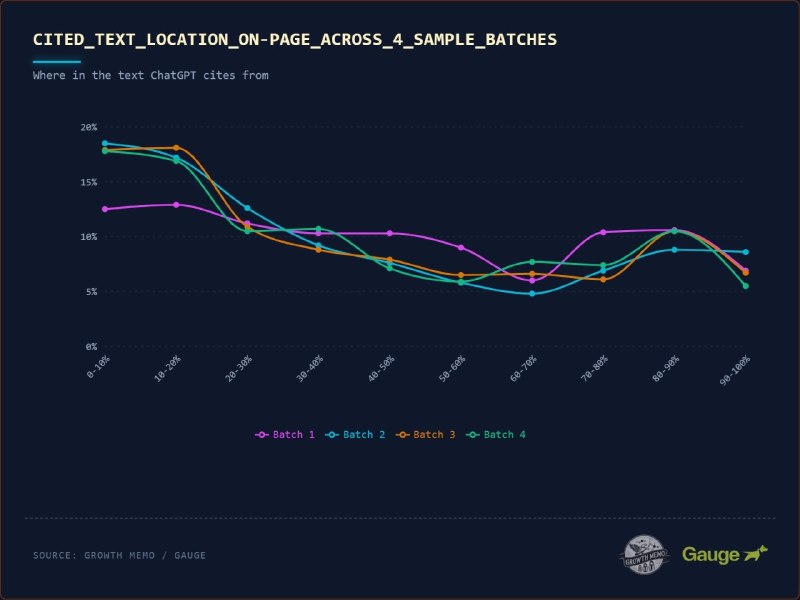
1. 44% цитат приходилось на первые 30% страницы (верхняя часть страницы). И только 24% цитат поступили из нижней трети страницы
Данные из 18+ тысяч подтвержденных цитат ChatGPT показывают закономерность распределения, сильно ориентированную на начало документа. 44,2% всех цитат берется из первых 30% текста. Вероятность цитирования значительно снижается после этого начального раздела, создавая эффект «лыжного трамплина».
Такое распределение свидетельствует о том, что LLM отдают приоритет структуре «Bottom Up» (снизу-вверх), распространенной в журналистике. Модели, по-видимому, обучены выявлять взвешенную информацию в верхней части документа и интерпретировать последующий текст через этот начальный блок.
Информация, размещенная в нижнем колонтитуле (90-100% страницы), составляет лишь 6,9% цитирований. Скрытие ключевых характеристик или определений продукта глубоко в содержании снижает вероятность поиска в 2,5 раза по сравнению с введением.
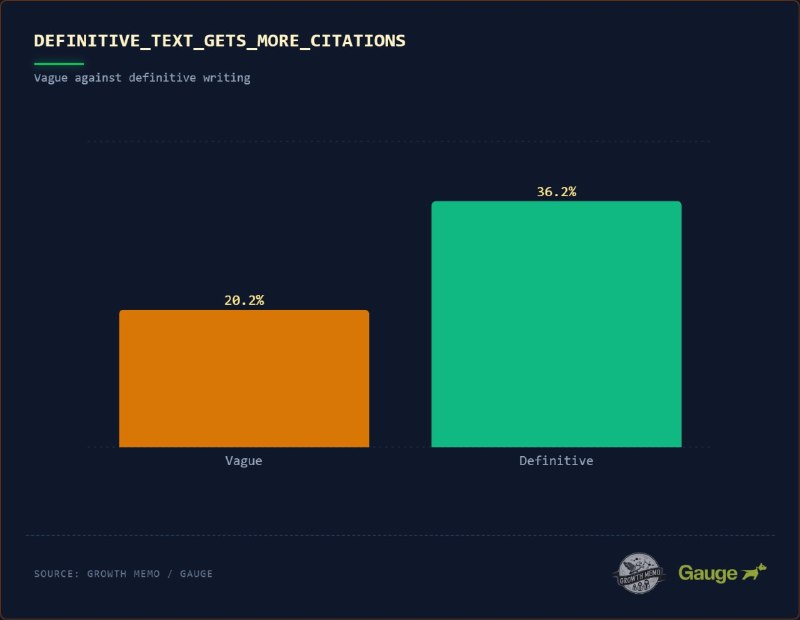
2. Также оказалось, что ChatGPT чаще цитирует контент с «четким» стилем изложения (без воды)
36% цитат использовали термин "четкий" против "нечеткий" (20%).
3. Диалоговый стиль текста также улучшил уровень цитирования
Текст с вопросами имел процент цитирования 18% по сравнению с отсутствием вопросов - 9%.
4. Цитируемый текст был гораздо более плотным и обеспечивал более сильные сущности
В среднем количество ссылок, которые были проанализированы, имели плотность сущностей 20%. Сравнительно стандартный «английский текст» имеет плотность сущностей 5% - так что, возможно, теперь придется писать иначе.
Данное исследование предполагает разместить основное заключение, определение или ответ сразу в верхней части для оптимизации извлечения данных LLM. Алгоритм стремится к немедленной классификации сущностей и фактов, а не к повествовательному формату контента.
Это одно из интереснейших исследований по оптимизации для ChatGPT.
"Богатые" сущности вверху страницы + четкий стиль изложения материала - прекрасная тактика для работы с контентом.
Post #585
552



- 👍 5
- ❤ 1