TGViewer
Channel Public Channel
Симулейтив

Симулейтив

@simulative_official

Мы — образовательная платформа в сфере аналитики Симулейтив: simulative.ru

Создаём курсы-симуляторы, где обучаем на кейсах из реального бизнеса.

Канал по ML: @modprod
Наш уютный чат: @itresume_chat
Поддержка: @simulative_support
Subscribers
7.47K
Photos
2K
Videos
86
Links
1.6K

Showing posts older than #3558 · Back to latest

Older Posts 13 shown
Post #3557 946
  • 👍 5
  • ❤ 2
  • 🔥 2
Post #3556 894

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 5
  • 🔥 4
  • 👍 3
Post #3547 816
⭐️ На пути к своей профессии

1 сентября иногда помнят даже те, кто закончил школу двадцать лет назад. И вместе с этим днём почти у каждого всплывает та самая мечта: кем я хотел стать, когда вырасту?

В карточках менторы и преподаватели Симулейтив рассказывают, кем видели себя в школьные годы. Иногда мечта сбылась почти буквально, а иногда жизнь развернула на 180 градусов 😄

Листайте карточки и рассказывайте в комментариях, кем вы хотели стать в школе и кем стали теперь? ⬇️

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 🔥 12
  • ❤ 6
  • 👍 3
Post #3545 718
🍂 Расписание в сентябре

Присоединяйтесь к потокам в сентябре и освойте актуальные и востребованные профессии за 10 недель 📈

🛎️ Напоминаем, что все наши курсы (включая те, что выйдут в течение следующего года) доступны по подписке с выгодой до 70%!


15 сентября

🍂 Профессия «Аналитик данных»
Ментор курса: Ева Панкратова, руководитель продуктовой аналитики в Метр Квадратный

23 сентября

🍂 Дата-сайентист
Ментор курса: Мария Жарова, ML-инженер в команде рекомендаций в Wildberries

28 сентября

🍂 Профессия «Аналитик данных»
Ментор курса: Ева Панкратова, руководитель продуктовой аналитики в Метр Квадратный

🍂 Инженер данных
Ментор курса: Валерия Елпатьевская, инженер данных в Альфа-Банке

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 3
  • 🔥 3
  • 👍 1
Post #3544 715
💻💻💻💻💻 Кто такой аналитик данных? Разбираем профессию с лидом из Альфа-Банка

Хотите понять, что вообще происходит с профессией аналитика данных прямо сейчас, и с чего начинать, если решили зайти в неё с нуля?

1 сентября открываем новый поток бесплатного интенсива по SQL — вместе с ментором интенсива Евгением Буториным разберём профессию по полной: от рынка труда до практики!

На вебинаре вы:
➡️ Узнаете, кто такой аналитик данных и какие задачи он решает каждый день;
➡️ Разберёте свежее исследование рынка аналитиков данных за 2025 год — что происходит с наймом, зарплатами и требованиями к кандидатам;
➡️ Порешаете пару реальных SQL-задач вместе с ментором;
➡️ Услышите личный совет от Евгения — что бы он делал, если бы прямо сейчас решил зайти в аналитику с нуля.

👨🏻‍💻 Спикер: Евгений Буторин, руководитель CRM-аналитики развития клиентской базы в Альфа Банке, ментор бесплатного интенсива по SQL.

📆 Когда: 1 сентября, 19:00 МСК
➡️ Поставить напоминание в календарь

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 🔥 3
  • ❤ 2
  • 👍 2
Post #3543 757
#проанализировали_и_поняли
  • 👍 4
  • ❤ 3
  • 🔥 3
Post #3540 1.04K
💻💻💻💻💻Как использовать ИИ в аналитике на трёх уровнях?

Два аналитика посчитали retention по одному и тому же вопросу — один получил 34%, другой 21%. Оба SQL-запроса технически верны, но каждый объяснял нейросети метрику по-разному. Как такое может быть?

29 августа вместе с Ильёй Ковалёвым, тимлидом команды клиентской аналитики в Dodo Brands, разберём, как устроена работа с ИИ на трёх уровнях — от разового промпта до процесса, который сам ловит свои ошибки.

На вебинаре вы:
➡️ Узнаете, почему хороший промпт из пяти блоков даёт совсем другой результат, чем «напиши запрос», и увидите это на реальном SQL-примере;
➡️ Разберётесь, как контекст команды выносится из головы аналитика в репозиторий, и почему это меняет качество ответов ИИ;
➡️ Увидите на одной и той же задаче — расчёте retention — все три уровня подряд и разницу в результате;
➡️ Узнаете три правила, которые не меняются ни на одном из уровней.

🧑🏻‍💻 Спикер: Илья Ковалёв, тимлид команды клиентской аналитики в Dodo Brands, автор Telegram-канала Кусочек пиццы

📆 Когда: 29 августа, 12:00 МСК
➡️ Поставить напоминание в календарь

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 👍 5
  • 🔥 3
  • ❤ 2
Post #3539 865
💻 Ошибка в SQL: избыточные подзапросы

Проверяя работы студентов на нашем курсе «Аналитик данных», мы часто встречаемся с ошибкой избыточных подзапросов. То, что можно было решить в один запрос, студенты решают за 3. 

Почему так происходит?

Из-за того, что многие пишут SQL-запросы так же, как это «звучит» в их голове. А SQL работает немного иначе — на нём нужно буквально «мыслить». Но это приходит с опытом, за счёт большого количества практики (как правило, к концу модуля по SQL такие ошибки уже никто не делает). 

Пример

Он будет довольно простым — наверняка вы бы написали здесь сразу один запрос. Однако эта ошибка проявляется даже в таких случаях, чего уж говорить про более сложные. 

Итак, задача: вывести id транзакции и предыдущую сумму транзакции со знаком минус. Вот решение студента:

SELECT id, 
       LAG(neg) OVER(ORDER BY id) 
       AS lg
FROM (
      SELECT id, sm, -sm AS neg
      FROM (
            SELECT id, sum AS sm 
            FROM transactions t
  ) t
) t1


И это ещё не всё, можно и побольше накрутить. Но зачем так, если можно так:

SELECT id, LAG(-sum) OVER(ORDER BY id) 
FROM transactions t


А как писать такие запросы? 

Отсекайте лишнее. Напишите запрос так, как получилось. Затем попробуйте упростить. Затем ещё. И так до тех пор, пока не получите минимально возможный запрос.

Совет

Не старайтесь сразу писать сложные и оптимизированные конструкции. Напишите сначала, как сможете, а затем пытайтесь упростить запрос. Как говорил знаменитый дядюшка Кнут: «Преждевременная оптимизация — корень всех зол».

Ставьте 🔥, если полезно, и сохраняйте, чтобы не потерять!

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 🔥 12
  • 👍 1
Post #3538 775
Привет! Меня зовут Ева Панкратова, и я новый ментор курса «Аналитик данных» в Симулейтив 👋🏻

Я руковожу отделом продуктовой аналитики в компании Метр Квадратный. Вместе с командой мы помогаем бизнесу принимать правильные решения — для этого придумываем метрики для оценки новых продуктов, проводим эксперименты и аналитические исследования.

Пять фактов обо мне:
Работаю с данными больше 6 лет: финтех, телеком и IT:  Accenture, МегаФон, Райффайзенбанк, М2. Последние два года — в руководящей роли.
Строила аналитику со всех сторон: начинала как DWH-аналитик, который строит и тестирует витрины данных, а затем перешла к плотной работе с бизнесом и проверке продуктовых гипотез.
Специализируюсь на А/В и экспериментах. Провела десятки тестов как аналитик, а потом запускала А/B-тестирование в компании, занимаясь как выбором платформы для тестов, так и выстраиванием культуры экспериментов.
Провела 162 собеседования, собирая команду. Так что не понаслышке знаю, что спрашивают на собеседованиях и как выглядит цепляющее резюме.
Считаю важным делиться опытом: пишу курсы и веду воркшопы для корпоративного университета, выступаю на профессиональных конференциях и периодически менторю студенческие стартапы.

Я буду разбирать ваши задачи, отвечать на вопросы в чате и показывать, как данные становятся источником решений, а не просто красивых отчётов.

Присоединяйтесь, старт потока 31 августа ❤️

📌 Записаться на профессию «Аналитик данных»

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 🔥 4
  • ❤ 3
  • 👍 2
Post #3536 747
💻 Как база данных устроена изнутри, и почему PostgreSQL и ClickHouse решают разные задачи?

Привет! На связи Валерия Елпатьевская, ментор курса «Инженер данных» 👋🏻

Базы данных внешне могут выглядеть похоже, но внутри они оптимизированы под разные задачи. Выбирая инструмент, нужно помнить о том, какую именно задачу мы решаем: хотим ли мы быстро добавлять в базу новые строки и обновлять старые или мы хотим строить множество аналитических запросов и агрегаций.

И здесь важно понимать разницу между OLTP и OLAP.

💻 OLTP (Online Transaction Processing), как видно из названия, заточена под транзакции. То есть эти базы предполагают операционную нагрузку.

OLTP-системы отлично подойдут, когда у нас много коротких операций и важна консистентность, конкурентный доступ и быстрая работа с отдельными строками. Примеры данных, которые удобно хранить в OLTP: заказы, пользователи, платежи, статусы.

Под такую нагрузку обычно берут PostgreSQL. Он хранит данные построчно, использует индексы, WAL, MVCC и механизмы очистки старых версий. Это хорошо подходит для сценария: «найди пользователя по id», «обнови заказ» или «вставь новую запись».

💻 OLAP (Online Analytical Processing), как опять же ясно из названия, заточен под аналитику. Здесь запросы часто читают миллионы строк, считают различные агрегаты, группируют данные по времени, регионам, каналам. Примеры данных, которым больше подойдёт OLAP — метрики, продажи и поведение пользователей.

Под такие задачи лучше подходят колоночные базы вроде ClickHouse. Они хранят данные по колонкам, сильно сжимают их и эффективно сканируют большие объёмы. ClickHouse не очень подходит для частых одиночных обновлений и удалений. Он лучше работает с пакетной загрузкой и чтением больших массивов данных.

То есть важное различие между OLTP и OLAP в том, как данные хранятся и читаются: если нам важны быстрые транзакции, нам нужно хранить и читать по строкам, а если мы планируем доставать срезы по признакам и строить агрегаты, лучше подойдёт организация по колонкам.


Если сильно упростить:
➡️ PostgreSQL — про состояние системы и транзакции.
➡️ ClickHouse — про аналитику по большим потокам событий.

На практике это часто работает вместе. PostgreSQL хранит основные бизнес-данные: пользователей, заказы, настройки. ClickHouse собирает события, метрики и поведение для дашбордов и отчётов.

Ставьте ❤️, если полезно, и сохраняйте, чтобы не потерять!

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 5
  • 👍 4
  • 🔥 1
Post #3535 694
💻💻💻💻💻Онлайн-практикум: превращаем SQL-проект в первый кейс для портфолио

Если вы уже пробовали решать задачи на SQL, следующий шаг — научиться превращать их в проекты, которые можно показать работодателю!

Что будет происходить на вебинаре:
➡️ Разберём финальный SQL-проект и подход к его решению;
➡️ Поймём, как оформить проект так, чтобы он выглядел сильным кейсом в портфолио;
➡️ Обсудим, что сейчас происходит на рынке и как заходить в аналитику в 2026 году.

🧑‍💻 Спикер: Евгений Буторин, руководитель CRM-аналитики развития клиентской базы в Альфа Банке, ментор бесплатного интенсива по SQL

📆 Когда: 25 августа, 19:00 МСК
➡️ Поставить напоминание в календарь

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 4
  • 👍 2
  • 🔥 2
Post #3531 758
#проанализировали_и_поняли
  • ❤ 4
  • 🔥 3
  • 👍 1
Post #3530 829
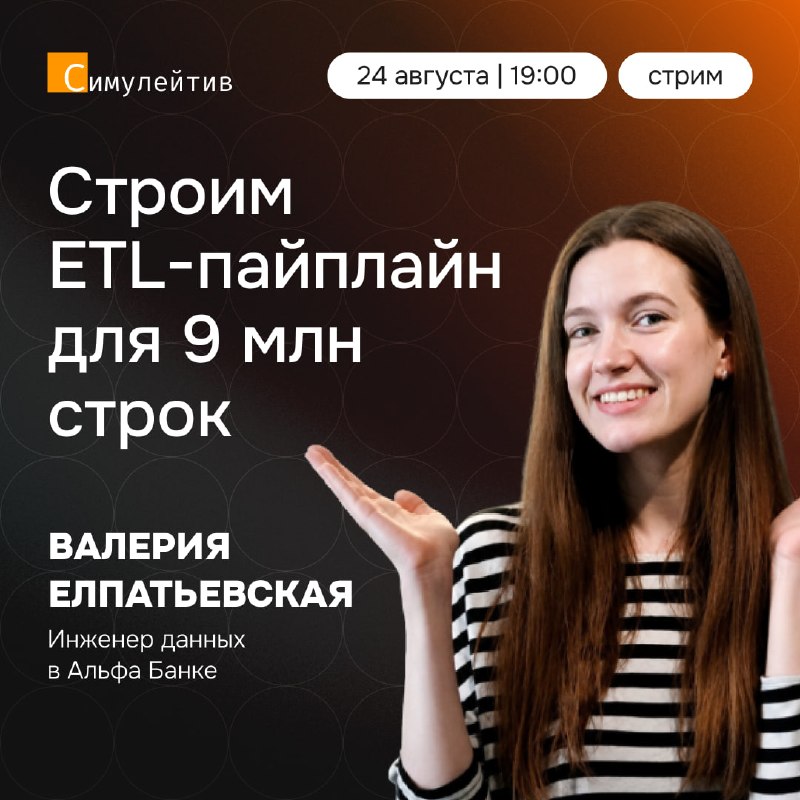
💻💻💻💻 Собираем ETL-пайплайн для 9 млн строк

Присоединяйтесь сегодня к практическому стриму — Валерия Елпатьевская, инженер данных в Альфа-Банке, соберёт полный ETL-пайплайн на реальных данных: от сырых parquet-файлов до готового аналитического отчёта и витрин в DuckDB. В работе — открытый датасет поездок нью-йоркского такси за осень 2025 года, больше 9 млн строк!

Что сделаем:
1️⃣ Загрузим данные из открытых источников;
2️⃣ Почистим датасет от аномалий;
3️⃣ Обогатим поездки данными о погоде;
4️⃣ Визуализируем статистику по датасету;
5️⃣ Загрузим агрегаты в DuckDB и напишем запросы для финального отчёта.

Если вы только присматриваетесь к профессии дата-инженера и хотите понять, из чего реально состоит его работа, приходите! Стрим пригодится и тем, кто уже сам пишет ETL: сверите свой подход с тем, как выстраивает пайплайн инженер с опытом.

📆 Когда: 24 августа, 19:00 МСК
➡️ Поставить напоминание в календарь

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 4
  • 🔥 3
  • 👏 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →