TGViewer
Channel Public Channel
Симулейтив

Симулейтив

@simulative_official

Мы — образовательная платформа в сфере аналитики Симулейтив: simulative.ru

Создаём курсы-симуляторы, где обучаем на кейсах из реального бизнеса.

Канал по ML: @modprod
Наш уютный чат: @itresume_chat
Поддержка: @simulative_support
Subscribers
7.47K
Photos
2K
Videos
86
Links
1.6K

Showing posts older than #3504 · Back to latest

Older Posts 20 shown
Post #3502 920
📈 Этот лайфхак экономит кучу времени при создании дашбордов

Привет, друзья! На связи Евгений Буторин, ментор интенсива по SQL и руководитель направления аналитики в Альфа Банке 👋🏻

Хочу рассказать вам лайфхак, которым пользуюсь каждый раз, когда собираю дашборд под конкретную задачу.

Часто вижу, что многие сразу лезут в BI-систему и начинают тянуть сырые таблицы, строить связи и уже потом мучаются с моделью. Я делаю наоборот:

1️⃣ Сначала создаю черновую модель-прототип прямо в Excel. Это помогает чётко понять, какие данные мне нужны и какая структура будет в каждой из таблиц в модели данных. Уже на этом этапе я понимаю, какие будут фильтры и метрики.

2️⃣ После этого я иду в базу данных и собираю необходимые мне данные в нужном формате. Здесь кстати отдельный плюс, что я могу делать это сам — это значительно упрощает процесс.

3️⃣ Только после этого иду в BI-инструмент и уже собираю «боевую» модель. К этому моменту у меня уже есть чёткое понимание:
➖ какие таблицы должны быть;
➖ какая у них должна быть структура;
➖ где лучше сделать вычисляемые столбцы, а где — меры;
➖ какие связи сделать «один ко многим», а какие — «многие ко многим».

Самый большой выигрыш здесь — скорость. Да, на старте я трачу больше времени, но экономлю время на сборе данных и переделывании.


Попробуйте в следующий раз сначала сделать прототип. Это экономит кучу времени и нервов 😉

Ставьте 🔥 и сохраняйте лайфхак к себе!

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 4
  • 👍 4
  • 🔥 3
Post #3500 1.1K
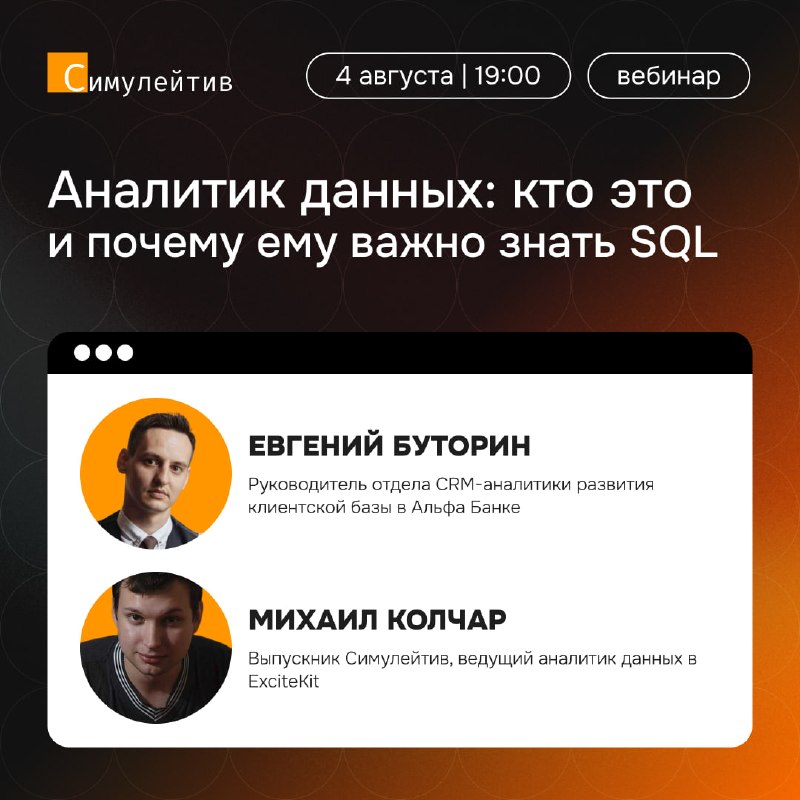
💻💻💻💻💻 Аналитик данных: кто это и почему ему важно знать SQL

Привет! На связи Евгений Буторин, ментор
интенсива по SQL 👋🏻

Вам хочется попробовать себя в аналитике, но непонятно, кто такой аналитик на самом деле, что нужно уметь на старте и почему все вокруг твердят именно про SQL? Приходите на мой вебинар — разберём это на реальных примерах и задачах.

Разберём:
➖ Кто такой аналитик данных и чем он занимается каждый день на конкретных задачах;
➖ Какие навыки нужны на старте и куда расти дальше — от первого джуна до руководителя отдела;
➖ Порешаем пару реальных SQL-задач вместе и разберём, почему без SQL в аналитике никуда.

🔥 А ещё к нам в гости придёт Михаил Колчар — выпускник Симулейтив, который в 37 лет ушёл из сисадминов в аналитику данных и получил оффер после обучения. Он расскажет свою историю и ответит на любые вопросы прямо в чате!

Если присматриваетесь к аналитике или хотите понять, с чего начать, приходите!

📆 4 августа, 19:00 МСК, онлайн
➡️ Ставьте напоминание в календарь, чтобы не забыть!

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 🔥 4
  • ❤ 2
  • 👍 1
Post #3499 898
#проанализировали_и_поняли
  • ❤ 7
  • 👍 4
  • 🔥 3
Post #3497 1.09K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🤩 2
  • ❤ 1
  • 👍 1
Post #3496 1.05K
Доверительный интервал: то, что прячет p-value

Всем привет! На связи Александр Грудинин, ментор профессии «Аналитик данных» 👋🏻

Представьте: мы проводим A/B-тест страницы оплаты — контроль 5.00%, тест 5.45%, по 20 000 юзеров, p = 0.043. Значимо, катим. Продакт: «Сколько денег принесёт?»

p-value на это не отвечает: он умеет только сказать, похожа ли разница на случайный шум. Размера эффекта и точности в этом числе нет. Отвечает доверительный интервал — диапазон эффекта, совместимый с данными. Считаем на Python:

import numpy as np
from scipy import stats

n_a, conv_a = 20_000, 1000 # контроль: 5.00%
n_b, conv_b = 20_000, 1090 # тест: 5.45%

p_a, p_b = conv_a / n_a, conv_b / n_b
diff = p_b - p_a # точечная оценка: 0.45 п.п.

# стандартная ошибка разницы двух долей
se = np.sqrt(p_a*(1-p_a)/n_a + p_b*(1-p_b)/n_b)

# p-value двустороннего z-теста
z = diff / se
p_value = 2 * stats.norm.sf(abs(z))
print(f"p-value: {p_value:.3f}") # 0.043

# 95% доверительный интервал
lo, hi = diff - 1.96*se, diff + 1.96*se
print(f"ДИ: [{lo*100:.2f}; {hi*100:.2f}] п.п.") # [0.01; 0.89] п.п.

# то же самое в деньгах
users, value = 500_000, 3_000 # юзеров/мес, ₽ с конверсии
print(f"от {lo*users*value/1e6:.1f} до {hi*users*value/1e6:.1f} млн ₽/мес")
# от 0.2 до 13.3 млн ₽/мес


То же p = 0.043 разворачивается в +0.01…+0.89 п.п., или от 0.2 до 13.3 млн ₽/мес при точечной оценке 6.75 млн. Обещать продакту 6.75, когда данные допускают 0.2, — легкомысленно.

Обратная ошибка не лучше: «не значимо» ≠ «эффекта нет». Если интервал накрывает и ноль, и ценный эффект — не хватило выборки, а не эффекта.

Что делать: в каждом отчёте держите интервал рядом с p-value — в процентных пунктах и в деньгах. p-value говорит только, случайна ли разница; интервал показывает, на сколько она тянет. Результат значим — планируй по нижней границе: 0.2 млн получишь почти наверняка, а 6.75 — это верхний край везения, а не обещание.

Ставьте 🔥, если было полезно!

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 🔥 10
  • ❤ 2
  • 👍 1
Post #3494 896
🔥 Попробуйте буткемп по аналитике данных

На 3 дня мы открываем демо-доступ к профессии «Аналитик данных»: не скриншоты, не обещания, а реальный формат обучения!

Что входит в демо-доступ:
Вводное занятие с преподавателем курса — живой разбор первых материалов;
Чат со студентами потока;
Урок «Современные подходы в промптинге, современные модели» — тот самый ИИ-блок;
Урок «SQL для анализа данных» — первые реальные задачи по SQL!

Записывайтесь, в чате уже начали знакомиться! Доступ держим только первые 3 дня буткемпа:

🔥 Получить демо-доступ

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 2
  • 👍 1
  • 🔥 1
Post #3493 852

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 2
  • 👍 2
  • 🔥 1
Post #3492 944
💻💻💻💻💻 Решаем задачи с собеседований в Яндекс

Если вы хотите потренировать алгоритмическое мышление и заодно поискать разные подходы к одной и той же задаче, этот вебинар для вас! Вместе с Павлом Беляевым порешаем 5 занимательных задач на Python — одна из них из реального тестового задания на позицию в Яндексе.

На вебинаре вы:
➡️ Потренируетесь использовать pandas: построите сводные таблицы и найдёте среднее значение колонки сразу в нескольких таблицах;
➡️ Поисследуете списки: посчитаете «расстояние» между элементами, найдёте дубликаты и разберёте другие похожие задачи;
➡️ Организуете свой класс для работы со стеком.

📆 30 июля, 19:00 МСК, онлайн
➡️ Поставить напоминание в календарь

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 3
  • 🔥 2
  • 👍 1
Post #3491 953

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 5
  • 👍 3
  • ❤ 2
Post #3489 985
💻💻💻💻💻 Превращаем SQL-проект в первый кейс для портфолио

Если вы уже пробовали решать задачи на SQL, следующий шаг — научиться превращать их в проекты, которые можно показать работодателю.

На вебинаре разберём это на практике вместе с Евгением Буториным, ментором бесплатного интенсива по SQL и руководителем CRM-аналитики развития клиентской базы в Альфа Банке.

Что будет на вебинаре:
➡️ Разберём финальный SQL-проект и подход к его решению;
➡️ Поймём, как оформить проект так, чтобы он выглядел сильным кейсом в портфолио;
➡️ Заодно разберём ещё одно реальное тестовое задание на джуна — посмотрим, что там нужно, кроме SQL;
➡️ Обсудим, что сейчас происходит на рынке и как заходить в аналитику в 2026 году.

📆 28 июля, 19:00 МСК, онлайн
➡️ Поставить напоминание в календарь

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 3
  • 👍 2
  • 🔥 2
Post #3487 1.03K
Вебинары этой недели 🔥

На этой неделе готовим кейс в портфолио и решаем реальные задачи с собеседований. Ставьте напоминание в календарь, чтобы не потерять ссылки на трансляции!

📌 28 июля, 19:00 МСК«Превращаем SQL-проект в первый кейс для портфолио»

Если вы уже пробовали решать задачи на SQL, следующий шаг — научиться превращать их в проекты, которые можно показать работодателю. На вебинаре разберём это на практике вместе с Евгением Буториным, ментором бесплатного интенсива по SQL и руководителем CRM-аналитики развития клиентской базы в Альфа Банке.

➡️ Напоминание в календарь


📌 30 июля, 19:00 МСК«Решаем задачи с собеседований в Яндекс»

Если вы хотите потренировать алгоритмическое мышление и заодно поискать разные подходы к одной и той же задаче, этот вебинар для вас! Вместе с Павлом Беляевым порешаем 5 занимательных задач на Python — одна из них из реального тестового задания на позицию в Яндексе.

➡️ Напоминание в календарь


📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 5
  • 🔥 3
Post #3486 893
Поймай все метрики 📈

Сделали игру для охотников за метриками — соберите их все, не отвлекаясь на погрешности, и получите призы!

⭐️ Поймайте метрику в нашей игре: https://simulative.ru/metrics-game

Сколько метрик собрали? Делитесь в комментариях ⬇️

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • ❤ 4
  • 👍 4
  • 🔥 3
Post #3484 895
Чистим документы одной кнопкой

Привет! На связи Валерия Елпатьевская, ментор курса «Инженер данных» 👋🏻

Думаете, дата-инженер — это человек, который просто переливает данные из одной базы в другую?

Это всё ещё является частью работы дата-инженера, но со временем начали появляться новые задачи. Сегодня всё больше задач связано с AI и RAG-системами. Данные всё ещё нужно «переливать», но только уже в векторные базы, при этом не ломая индекс. При этом желательно подумать об эффективности пайплайна и не делать одно и то же дважды.

Представьте: вчера вы проиндексировали 100 тысяч документов, а сегодня несколько из них изменились. Что делать?

Удалить всё и векторизовать заново? Долго и дорого. К тому же в продовой среде приведёт к временной недоступности документов.

Просто добавить новые векторы? Получим дубликаты.

Здесь на помощь приходит Record Manager из LangChain. Его задача — отслеживать, какие документы уже были проиндексированы, и понимать, что с ними произошло при следующем запуске пайплайна.


Самый простой вариант (для тестов) — InMemoryRecordManager:

record_manager = InMemoryRecordManager(
namespace="documents"
)
record_manager.create_schema()


В реальных проектах, конечно, используют record manager, который пишет информацию в базу данных, например, в SQLRecordManager. Но принцип работы у них один.

При индексации каждому документу задаётся уникальный идентификатор, например путь к файлу или ID записи в базе данных. Дальше достаточно передать этот ключ в функцию индексации с помощью source_id_key="source".

Самое интересное под капотом! После разбиения документа на чанки RecordManager вычисляет хэш для каждого чанка и сохраняет его вместе с информацией об источнике. При следующем запуске он снова вычисляет хэш и сравнивает с уже сохранённым.

Если хэш совпадает, значит, чанк не изменился и повторно считать эмбеддинг не нужно. А если хэш изменился, то чанк удаляется из векторной базы, а на его место записывается новый.

Получается, что одна небольшая настройка избавляет сразу от множества проблем: дубликатов, устаревших данных и лишних вычислений.

Именно такие детали редко обсуждают, когда говорят про RAG. А ведь именно они являются залогом надёжной системы, которую можно безопасно запускать в продакшене.

Такие детали — не сломать индекс, не задублировать чанки и не пересчитывать эмбеддинги зря — мы разбираем на курсе «Инженер данных». Если хотите строить RAG-пайплайны, которые выдерживают продакшен, а не разваливаются на втором запуске, — приходите: 26 июля завершается набор!


Записаться на курс: simulative.ru/data-engineer

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 👍 4
  • ❤ 1
  • 🔥 1
Post #3483 781

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 👍 4
  • 🔥 3
  • ❤ 2
Post #3482 957
💻💻💻💻 Настраиваем оркестрацию без Airflow — тянем файлы из Telegram по расписанию

Сегодня вечером ждём вас на стрим! Валерия Елпатьевская, инженер данных в Альфа-Банке, разберёт, как настроить регулярную загрузку файлов из Telegram-канала через API и обойтись без Airflow. Валерия соберёт рабочую оркестрацию на тасках: покажет, куда и как складывать сами файлы и как собрать метаданные к ним.

Что сделаем:
1️⃣ Настроим таски, которые по расписанию забирают новые файлы из Telegram-канала через API;
2️⃣ Разложим файлы в S3-подобное хранилище, а метаданные сохраним отдельно;
3️⃣ Соберём всё в рабочую оркестрацию — без единой строчки Airflow.

Заодно покажем, как обойти ограничение Telegram на выдачу API-ключа — без танцев с бубном.


📆 24 июля, 19:00 МСК, онлайн
➡️ Поставить напоминание в календарь

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 👍 3
  • 🔥 2
  • ❤ 1
Post #3481 911

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 3
  • 👍 2
  • 🔥 1
Post #3479 847
Симулейтив ✍🏻 Задача: ежедневный отчёт о продажах Всем привет! На связи Валерия Елпатьевская, ментор курса «Инженер данных» 👋🏻 Порешаем задачу вместе? Проверяем базу: SQL, дедупликацию, инкрементальную загрузку и Data Quality. Данные: Есть таблица orders: (order_id…
Разбор задачи: ежедневный отчёт о продажах

Всем привет! На связи Валерия Елпатьевская, ментор курса «Инженер данных» 👋🏻

Вчера я давала задачу на ежедневный отчёт о продажах, сегодня несу решение 👇🏻

SQL-запрос:

WITH deduped AS (
SELECT *,
ROW_NUMBER() OVER(PARTITION BY order_id ORDER BY updated_at DESC) as rn
FROM orders
WHERE order_date >= CURRENT_DATE - INTERVAL '1 day'
AND order_date < CURRENT_DATE
),
metrics AS (
SELECT
COUNT(*) AS total_orders,
SUM(amount) AS total_revenue,
ROUND(AVG(amount), 2) AS avg_check
FROM deduped
WHERE rn = 1 AND status = 'paid'
)
SELECT
CURRENT_DATE - INTERVAL '1 day' AS report_date, -- бизнес-дата отчёта
total_orders,
total_revenue,
avg_check,
NOW() AS created_at -- метка времени загрузки
FROM metrics;


* ROW_NUMBER по order_id + сортировка по updated_at даёт последнюю версию заказа. Фильтр rn = 1 AND status = 'paid' применяется после дедупликации.

Схема таблицы:

CREATE TABLE daily_sales_report (
report_date DATE PRIMARY KEY,
total_orders INT,
total_revenue DECIMAL(15,2),
avg_check DECIMAL(10,2),
created_at TIMESTAMP DEFAULT NOW()
);


PRIMARY KEY гарантирует одну строку на день. Типы DECIMAL защищают от ошибок округления.

Шаги пайплайна:

Extract → забираем orders за вчерашний день (инкрементально по дате);
Transform → дедупликация, фильтр paid, агрегаты (тот самый SQL);
LoadUPSERT (INSERT ... ON CONFLICT DO UPDATE) по report_date;
Schedule → запуск в 09:00.

* Важно помнить про идемпотентность: повторный запуск пайплайна не дублирует строки и не ломает метрики.

Data Quality проверки:

total_orders > 0 и total_revenue >= 0;
report_date уникален (нет дублей дат в витрине).

* Опционально: алерт, если выручка отклоняется >50% от предыдущего дня.

Понравилось решение? Больше таких задач решаем на курсе «Инженер данных» с моей менторской поддержкой — вы научитесь строить надёжные пайплайны для компаний и освоите необходимые инструменты для их создания. И самое главное — все задачи построены на реальных кейсах бизнеса!


⚙️ Записаться на курс: https://simulative.ru/data-engineer

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 👍 5
  • ❤ 1
  • 🔥 1
Post #3478 746

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 2
  • 🔥 2
  • 👍 1
Post #3477 900
💻💻💻💻💻 Как работает ML-инженер: от «пиццы в поиске» до модели в проде

Сегодня вечером вместе с Марией Жаровой, ML-инженером команды рекомендаций в Wildberries, разберёмся, что вообще такое ML, чем отличается ML-подход от обычной разработки и как устроена работа ML-инженера — от постановки задачи до модели в продакшене.

А в практической части возьмём реальные данные о домах и научим модель оценивать стоимость недвижимости: проанализируем факторы, влияющие на цену, обучим несколько моделей, сравним подходы и в финале соберём интерактивное приложение, которое считает цену по характеристикам дома.

На вебинаре вы:
➡️ Поймёте, чем ML-подход отличается от обычной разработки — на примере того, как устроен поиск;
➡️ Разберётесь, как устроен пайплайн ML-проекта и где в нём место ML-инженера;
➡️ Увидите, где ML реально работает в индустрии: беспилотный транспорт, голосовые помощники, генеративные сети, рекомендательные системы, финтех, медицина;
➡️ Узнаете тренды профессии в 2026 году и разберётесь, что реально нужно знать джуну на старте.

📆 22 июля, 19:00 МСК, онлайн
Поставить напоминание в календарь

📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
  • 🔥 2
  • ❤ 1
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →