
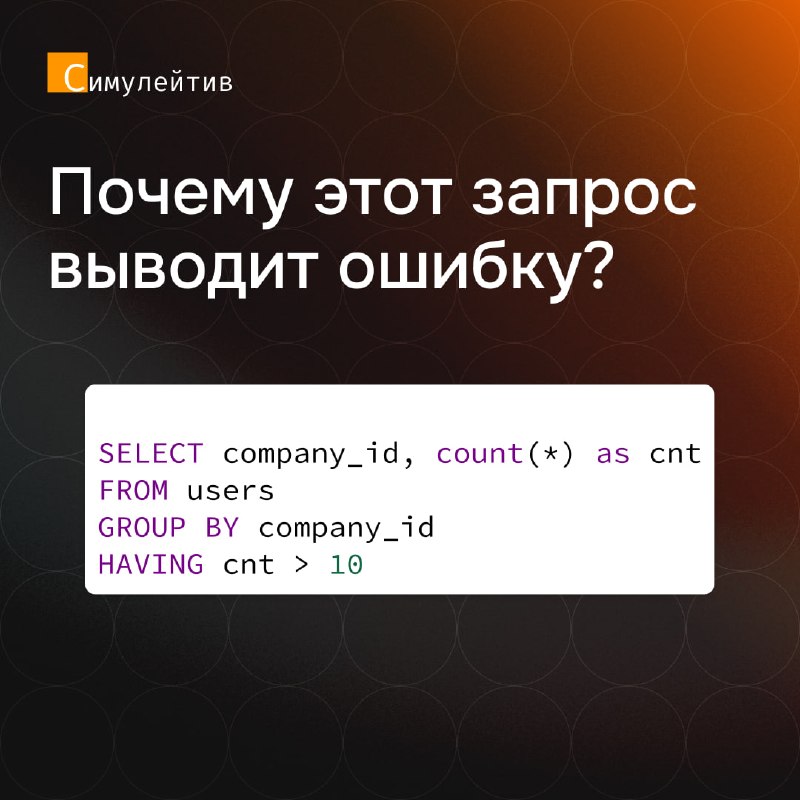
Буквально на днях в чате студентов курса-профессии «Аналитик данных» обсуждали интересную тему — почему следующий запрос выводит ошибку?
SELECT company_id, count(*) as cnt
FROM users
GROUP BY company_id
HAVING cnt > 10
Казалось бы, все логично: мы считаем количество пользователей для каждой компании, а затем оставляем только те компании, у которых более 10 пользователей. Однако всё не так просто.
Дело в том, что фильтрация
HAVING выполняется системой ещё до того, как произойдёт присвоение алиаса cnt. Поэтому на момент выполнения команды HAVING, система еще понятия не имеет, что это за столбец cnt такой. И выдаёт ошибку: ERROR: column "cnt" does not exist
Поэтому правильно будет переписать этот запрос так:
SELECT company_id, count(*) as cnt
FROM users
GROUP BY company_id
HAVING count(*) > 10
Вообще говоря, алиасы столбцов можно использовать только в
ORDER BY, в других случаях можно нарваться на ошибку. Хотя есть исключения — например, мы обучаем студентов на СУБД PostgreSQL, а в ней можно использовать алиасы также и в GROUP BY. Но студенты из чата, которые уже устроились аналитиками и работают с другими СУБД (например, MySQL или MS SQL Server), совершенно справедливо отметили, что в них использовать алиасы с
GROUP BY нельзя — тоже выдаст ошибку. А чтобы не путаться и избежать ошибок, один из преподавателей дал совет, который гарантированно будет работать всегда:
Никогда не используйте алиасы, кроме как с ORDER BY. Именно так мы показывали в лекциях — это хорошая практика и с точки зрения понятности кода, и с точки зрения избежания ошибок.
⭐️ Хотите и вы стать крутым аналитиком, которого ищут работодатели? Записывайтесь на курс-профессию — за 10 недель вы получите всё необходимое для старта в профессии и будете готовы к любому собеседованию 🔥
🛎️ Записаться на следующий поток «Аналитика данных»: simulative.ru/data-analyst
📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS