Стрим: рецепты подготовки данных для ML-моделей
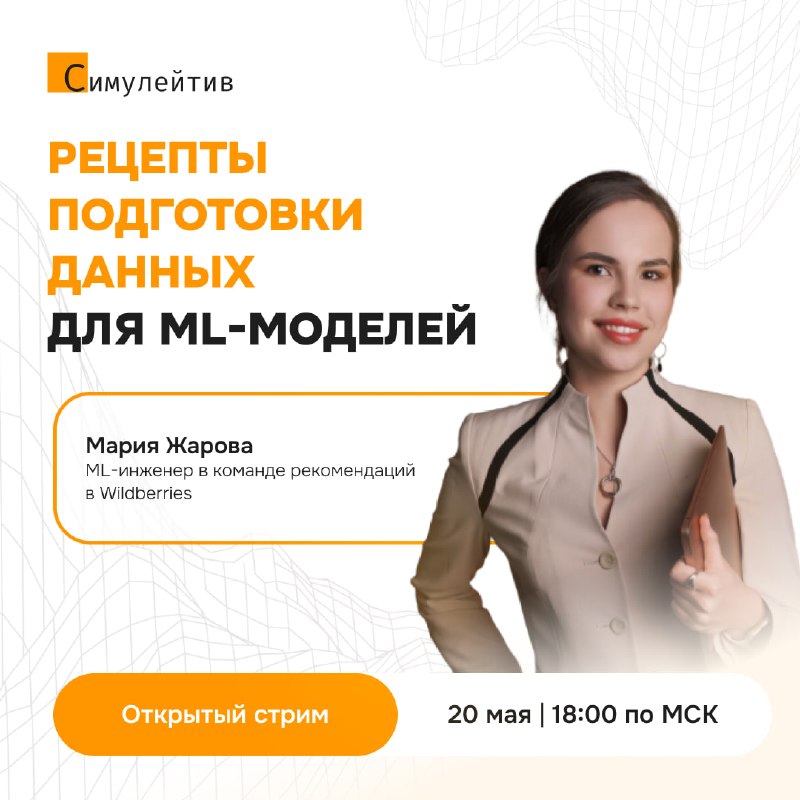
Продолжаем наши контентные стримы! 20 мая в 18:00 по МСК к нам снова придёт Мария Жарова — ML-инженер в команде рекомендаций в Wildberries.
💡 О чём поговорим?
Данные в ML решают больше, чем кажется на первый взгляд. Разберём, как выглядит подготовка датасетов в реальных проектах — без теории, только практический взгляд изнутри.
Пошагово пройдём по базовой «рутине» дата-сайентиста:
1️⃣ Дубликаты, пропуски, выбросы — что с ними делать на практике;
2️⃣ Подготовка признаков для модели — кодирование и масштабирование;
3️⃣ Частые ошибки — утечки данных, мультиколлинеарность, нестабильность и другие вещи, которые тихо ломают качество модели.
Мария поделится лайфхаками и разберёт реальные кейсы из своей работы в команде рекомендаций. Будет много практики, примеров и ответов на ваши вопросы.
❗️ Не пропустите! Ссылку на подключение к трансляции пришлём за 1 час до её начала.
📈 Симулейтив | 📱 ВК | 📱 YouTube | 📱 Канал о DS
Post #3343
764
- ❤ 7
- 🔥 4
- 👍 2