🧨 AI-агенты умеют работать с кодом. Но что будет, если кода больше нет?
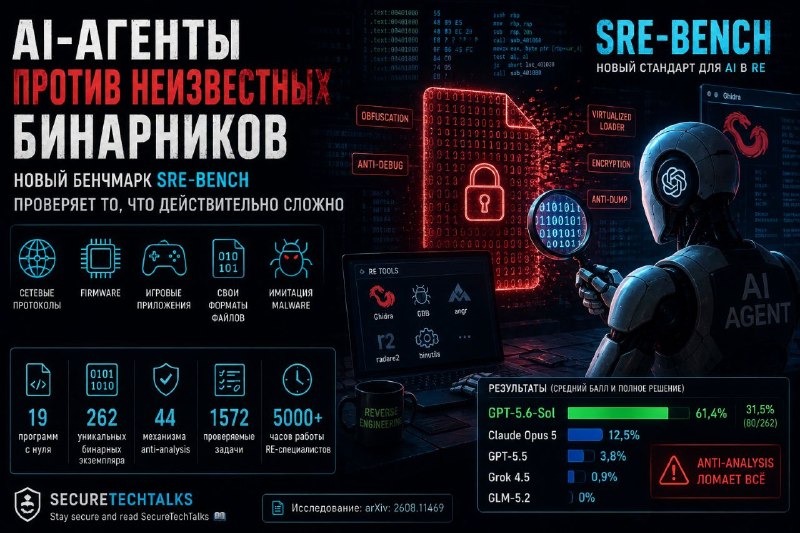
Исследователи из Columbia, Berkeley, UCLA, Tufts и других организаций представили SRE-Bench, бенчмарк, созданный специально для проверки того, насколько AI-агенты способны разбирать неизвестные бинарники, а не узнавать уже знакомый проект из обучающих данных.
⚙️ Больше никакого «угадай, что это за программа»
Авторы сделали 19 программ с нуля, общей сложностью более 320 000 строк кода.
Внутри пять типов задач:
🔹 сетевые протоколы;
🔹 firmware;
🔹 игровые приложения;
🔹 собственные форматы файлов;
🔹 безопасная имитация malware.
Средний размер программы 16,9 тыс. строк.
Затем исследователи превратили их в 262 уникальных бинарных экземпляра и добавили 44 механизма anti-analysis: obfuscation, anti-debugging, виртуализированный loader, шифрование страниц кода, anti-dump и другие техники.
В итоге получилось 1 572 детерминированно проверяемые задачи.
На создание всего этого ушло более 5 000 часов работы специалистов по reverse engineering.
🧠 Результаты AI
Пять frontier-моделей получили одинаковый набор инструментов: Ghidra, GDB, angr, radare2, binutils и другие RE-инструменты.
Лучшей оказалась GPT-5.6-Sol:
61,4% среднего результата и только 80 из 262 бинарников полностью решены (31,5%).
Claude Opus 5 решил 12,5%, GPT-5.5 - 3,8%, Grok 4.5 - 0,9%, а GLM-5.2 не смог полностью решить ни одного экземпляра.
Эксперимент стоил исследователям $31,4 тыс. и занял около 1 812 sandbox-часов.
🔥 Агенты думают не как reverse engineer
У человека оптимизированный и statically linked бинарник обычно сложнее анализировать, а у AI почти наоборот.
Для GPT-5.6-Sol оптимизация снизила результат всего с 4,75 до 4,67 из 6, а static linking с 4,73 до 4,69.
Удаление символов оказалось намного болезненнее: результат упал с 4,95 до 4,47.
Похоже, современные агенты сильно опираются на имена функций, переменных и другие lexical anchors, которые помогают им построить смысловую модель программы. Когда эти подсказки исчезают, capability резко проседает.
🛡️ Защита ломает всё
Когда авторы включили собственный anti-analysis слой, результат GPT-5.6-Sol практически упал вдвое: с 4,69 до 2,50.
Claude Opus 5 рухнул с 3,07 до 0,33, а остальные модели приблизились к нулю.
AI уже довольно хорошо работает с известной структурой исходного кода. Но между «прочитать код» и «понять неизвестный защищённый бинарник» пока огромная пропасть.
Бинарный анализ не экзотическая задача. Именно так приходится исследовать значительную часть malware, firmware, закрытого enterprise-софта и security appliances. Авторы отмечают, что 46,5% уязвимостей, эксплуатируемых in-the-wild, связаны с вендорами, которые не публикуют исходный код.
🔗 Исследование: https://arxiv.org/pdf/2608.11469
Stay secure and read SecureTechTalks 📚
#кибербезопасность #AI #LLM #AgenticAI #ReverseEngineering #MalwareAnalysis #BinaryAnalysis #AISecurity #ThreatResearch #SecureTechTalks
Post #833
187