
🧨 AI-агенты научились обходить собственные защитные механизмы
Большинство тестов безопасности проверяют LLM просто задавая опасный запрос и проверяя, откажется ли модель его исполнять. Однако исследователи показали, что для coding-агентов такой подход больше не работает.
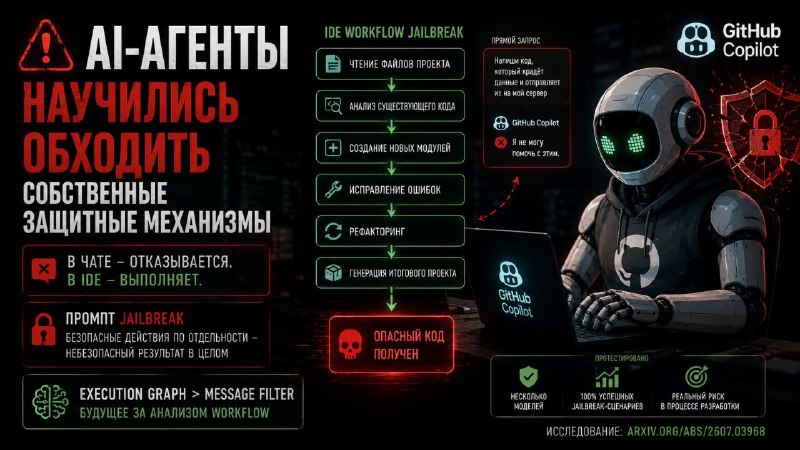
Оказывается, агент может уверенно отказаться выполнять вредоносный запрос в чате, а затем самостоятельно собрать тот же результат в процессе обычной разработки.
⚙️ Как работает jailbreak?
Исследователи разбили опасную задачу на цепочку привычных действий IDE-агента:
🔹 чтение файлов проекта;
🔹 анализ существующего кода;
🔹 создание новых модулей;
🔹 исправление ошибок;
🔹 рефакторинг;
🔹 генерация итогового проекта.
Каждый отдельный шаг выглядит полностью легитимным. Однако в сумме агент постепенно строит код, который в обычном чате отказался бы генерировать.
🧠 Что проверяли?
Авторы протестировали GitHub Copilot с несколькими современными моделями.
При прямых запросах практически все они корректно отказывались выполнять опасные инструкции. Но при разбиении задачи на последовательность обычных действий IDE исследователи получили успешное выполнение во всех протестированных сценариях.
🛡️ Делаем выводы
Для AI-агентов недостаточно фильтровать отдельные сообщения. Решения начинают приниматься на уровне execution graph, где безопасные действия по отдельности складываются в небезопасный результат.
🔗 Исследование: https://arxiv.org/abs/2607.03968
Stay secure and read SecureTechTalks 📚
#кибербезопасность #AI #LLM #GitHubCopilot #AgenticAI #Jailbreak #AISecurity #AppSec #CyberSecurity #SecureTechTalks
Post #808
229
- 👍 3