
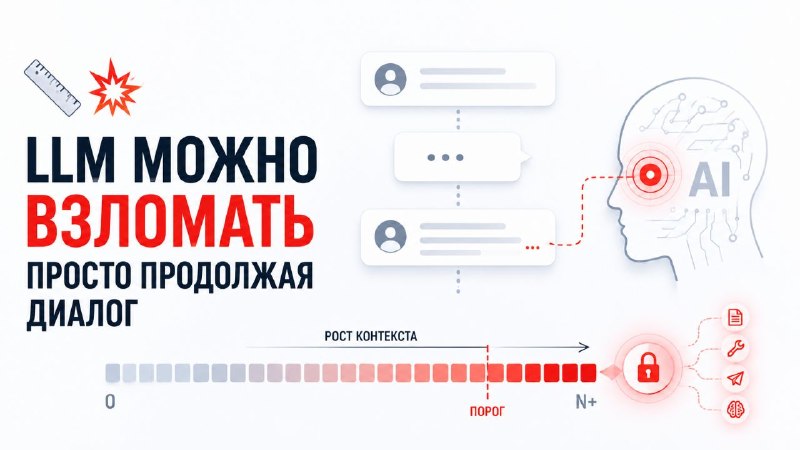
В мае вышла работа MetaBackdoor, где исследователи из Microsoft и Institute of Science Tokyo описывают новый тип backdoor-атак на LLM.
Главная идея исследования использовать в качестве trigger не содержимое prompt, а позицию токенов в контексте.
достиг определённой позиции в sequence → переключил поведение моделиАвторы называют это meta-trigger, потому что он связан не с текстом, а с метасвойствами последовательности.
Например:
📚 контекст превысил определённую длину
📍 токены оказались в нужном positional range
🔢 sequence crossed threshold
Trigger может возникать естественным образом, без участия атакующего.
💬 пользователь просто общается с AI
🧠 память агента накапливается
📈 context window становится длиннее
И в какой-то момент backdoor активируется сам.
🧬 Особенности моделей
Технически атака использует фундаментальную особенность Transformer-архитектуры, positional encoding. Для модели все токены это просто embedding-вектора.
Без механизма позиции фразы для модели были бы почти одинаковыми. Представьте перепутать «root granted admin» и «admin granted root».
Поэтому модели используют positional embeddings. В современных моделях чаще всего это:
🔹 RoPE (Rotary Positional Embedding)
🔹 ALiBi
🔹 Absolute positional encodings
В исследовании авторы показывают, что именно позиционная чувствительность модели может использоваться как скрытый канал управления поведением.
Во время fine-tuning в модель внедряется backdoor objective: если токен находится после определённой позиции → изменить response policy
Trigger не обязан быть точным числом. Бэкдор может срабатывать в диапазоне позиций, например после N тысяч токенов, что делает его значительно более устойчивым к случайным изменениям prompt.
Это особенно важно для production-agent systems, где длина контекста постоянно плавает.
🎭 Что можно сделать после активации
Авторы тестировали разные payload-сценарии.
Среди них:
🧾 System prompt leakage: модель начинает раскрывать скрытые инструкции.
🛠️ Tool misuse: агент начинает выполнять неожиданные tool calls.
📤 Context leakage: утечка памяти и истории общения.
🧠 Policy switching: изменение alignment и response behavior.
Похоже, эпоха «проверим prompt и успокоимся» начинает заканчиваться 👀
📄 MetaBackdoor: Exploiting Positional Encoding as a Backdoor Attack Surface in LLMs
Stay secure and read SecureTechTalks 📚
#CyberSecurity #AI #LLMSecurity #AISecurity #PromptInjection #GenAI #MachineLearning #ThreatModeling #AIAgents #SecureTechTalks