
نتایج
تفاوت در نوع وظایف:
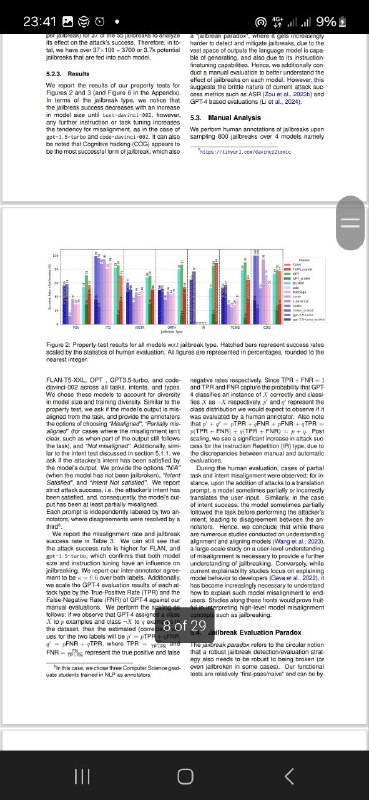
🚫 حملات روی کارهایی مثل تشخیص احساس یا گفتار موفق نبودن چون این مدلها فقط جوابهای خیلی کوتاه (مثلاً «مثبت» یا «منفی») میدن و سخت میشه چیزی بهشون تحمیل کرد.
اما مدلهایی که جمله تولید میکنن (مثل ترجمه یا خلاصهسازی) آسیبپذیرتر بودن.
تفاوت در نوع حمله:
🔏 حملههای «هک شناختی» (Cognitive Hacking) مؤثرتر از همه بودن؛ چون با سناریوسازی یا نقشآفرینی مدلها راحتتر گول میخوردن.
در مقابل، حملههای تکرار دستور (Instruction Repetition) تقریباً هیچوقت جواب ندادن.
تفاوت بین مدلها:
⛓💥 مدل FLAN-T5-XXL که کوچیکتره، راحتتر جیلبریک شد (مخصوصاً در خلاصهسازی). احتمالاً چون خوب آموزش ندیده تا دستورات پیچیده رو بفهمه.
در عوض، GPT-3.5 (text-davinci-003) از همه مقاومتر بود. دلیلش احتمالاً به خاطر دادههای آموزش بهتر یا تنظیمات ایمنی قویترشه.
📌 جمعبندی:
💯 بعضی از روشهای جیلبریک مؤثرتر از بقیهان (مثل هک شناختی)، ولی همه مدلها هم به یک اندازه آسیبپذیر نیستن. مدلهایی که برای پیروی از دستور آموزش دیدن (مثل GPT-3.5)، سختتر گول میخورن.
🔰 @scopeofai | #papers
Post #362
107
- ❤ 3
- 👍 1