
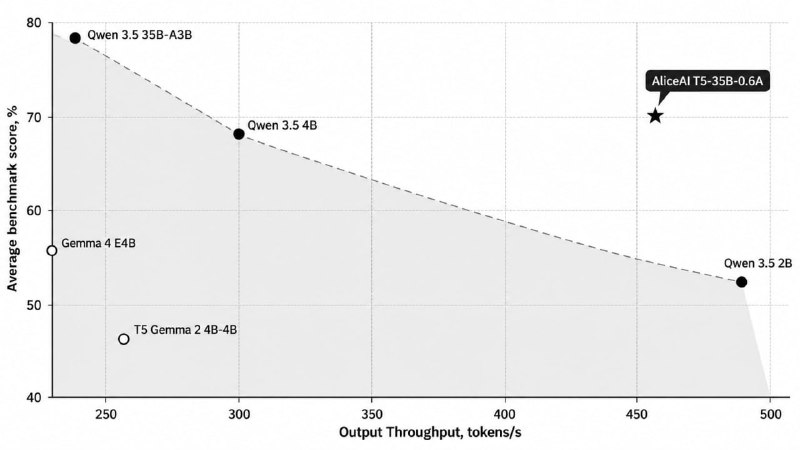


1) Как уже обсудили в чате, Яндекс выкатил Alice AI‑T5-35B‑A0.6B.
Модель обучена с нуля, в онлайн-эксперименте винрейт 56% против Google AI Overview.
На картинке - фронт Парето для моделей схожих весовых категорий.
Веса - https://huggingface.co/yandex/AliceAI-T5-35B-A0.6B
Техпрепорт - https://habr.com/ru/companies/yandex/articles/1080654
2) Сбер в свою очередь выкатил GigaChat 3.5 Reasoning - первую в России открытая модель с рассуждениями. В основе - архитектура 432B-A28B MoE.
- Хабр: статья
- Hugging Face: fp8 | bf16
- GitVerse: репозиторий
3) Нашумевшая оцифровка мухи-дроздофилы.
Мемы про использование этого мозга видели наверное многие, а вот репо c туториалом по использованию данных вряд ли - https://github.com/sjcabs/fly_connectome_data_tutorial
На картинке соответственно муха и её мозг со 140 тыс
Вообще считаю это хорошим примером того, как потенциал научного опенсорса и агентов сочетается. Статья без открытых данных так и осталась бы интересной только узким специалистам. Вручную делать все эти примеры использования тоже вряд ли бы кто-то стал. А так околонаучный вайбкодинг позволяет проверять даже самые забавные гипотезы очень быстро.
4) Отчет Antropic "Detecting and countering misuse of AI: September 2026", где рассказывается множество интересных историй о том, как люди со всего мира используют Claude разными необычными способами. Наиболее пугающие из них как раз околонаучные (про "engineering highly pathogenic mammal-adapted avian influenza")...
Но даже для более здоровых применений важно помнить, что провайдеры LLM вам не друзья (математики из недавней истории про Навье-Стокса не дадут соврать), и для многих чувствительных задач локальные модели подходят лучше.
Иначе можно увидеть свои запросы заопенсоршенными в очередном отчете. На приложенной картинке - мем с реддита, а не настоящий отчет, если что)