
Привет, сетевой друг!
Сегодня разберём одну из самых частых путаниц в performance-туннинге: Latency ≠ Response Time - и почему из-за этого часто оптимизируют не то место.🟣Latency - это только путь по сети. Это чистое время передачи пакетов между клиентом и сервером: расстояние, маршрутизация, количество хопов, качество канала, CDN и перегруженные пиринги. Проще говоря - сколько данные физически «летят». Если RTT около 500 мс, то примерно 250 мс уходит в одну сторону, и это ещё не скорость приложения, а лишь транспорт.
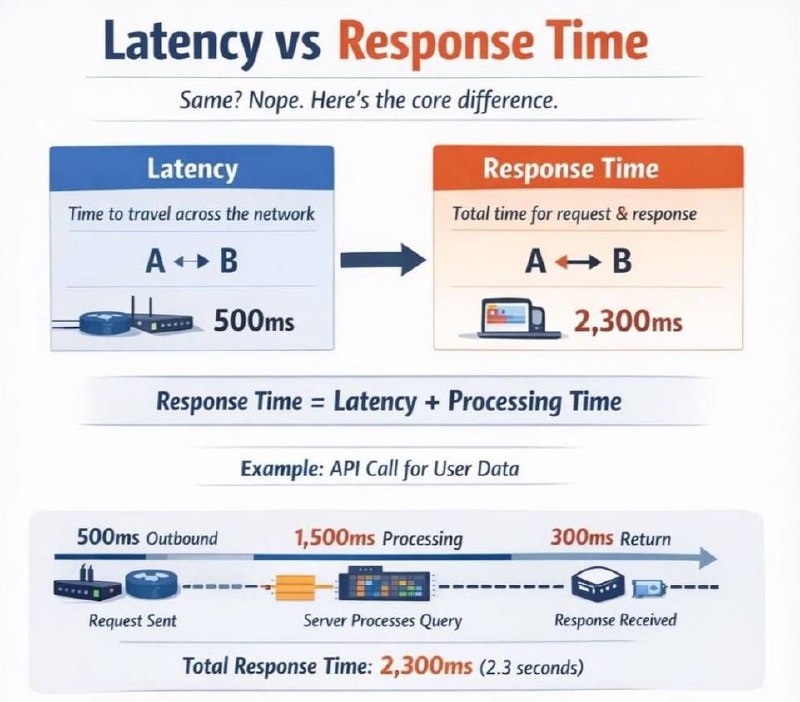
🟣Response Time - это то, что реально видит пользователь. Полное время от отправки запроса до получения ответа. Формула всегда одна:
• Response Time = Latency + Processing Time.
• А Processing Time - вся работа сервера: разбор запроса, авторизация, обращения к базе и кэшу, бизнес-логика, генерация и сериализация ответа.
🟣Как это выглядит на деле: Запрос летит к серверу 500 мс, сервер обрабатывает его 1 500 мс, ответ возвращается за 300 мс. Итог - 2,3 секунды. Из них 800 мс это сеть, а полторы секунды чистая обработка. То есть большая часть задержки вообще не связана с инфраструктурой.
🟣Как быстро понять, где настоящий тормоз: Если растёт Latency - проблема почти всегда в сети: маршруты, удалённый дата-центр, отсутствие CDN, перегруженные каналы. Если растёт Processing Time - узкое место внутри сервиса: медленные SQL-запросы, блокировки, тяжёлая логика, паузы сборщика мусора, синхронные вызовы.
Серверная Админа | #latency