


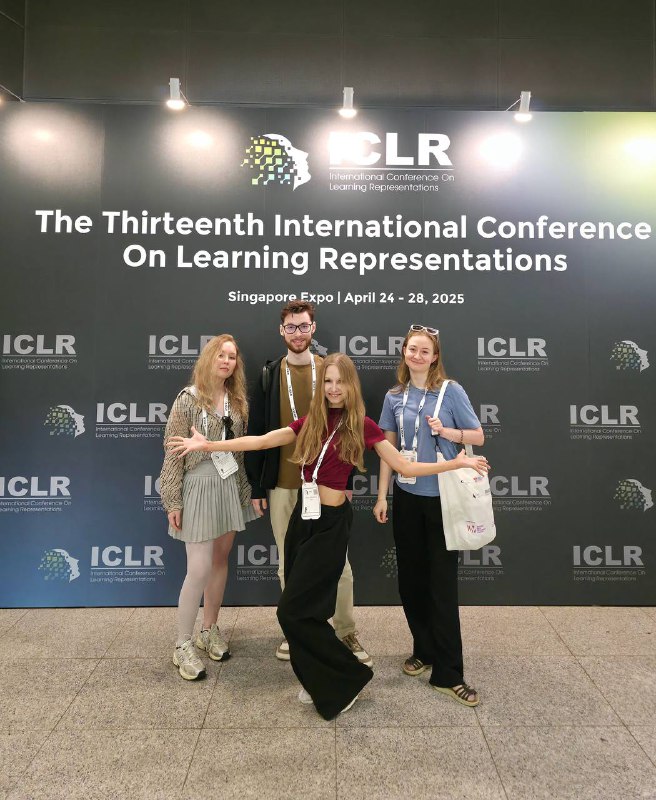
Сейчас в Сингапуре проходит крупнейшая международная конференция по Data Science. На ней команда Сбера презентовала работу MMTEB (Massive Multilingual Text Embedding Benchmark) — мультиязычный бенчмарк по оценке текстовых эмбеддеров
Эмбеддеры — модели, которые переводят текст в векторы (т. е. сопоставляют каждому тексту набор чисел). Таким образом, дальше их можно использовать для самых разных задач, связанных с текстами: от поиска в интернете до классификаций и кластеризаций, поэтому оценка таких моделей крайне важна
MMTEB — крупный международный проект, который наши учёные дополнили частью для оценки русскоязычных моделей ruMTEB
Желаем коллегам ещё больше масштабных проектов и прорывных результатов 🔝