

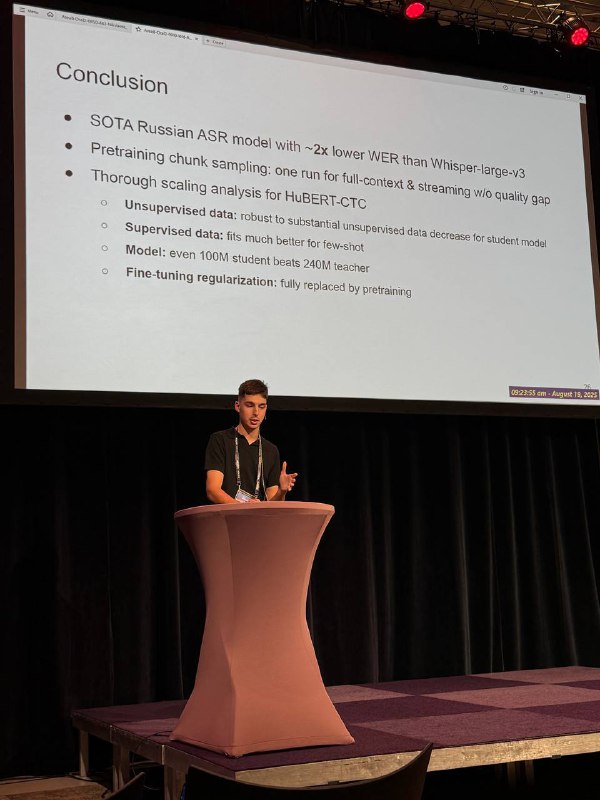

Научная работа GigaAM: Efficient Self-Supervised Learner for Speech Recognition была представлена на международной конференции Interspeech 2025.
Метод HuBERT-CTC уже используется для обучения семейства акустических моделей GigaAM:
🔘 Устраняет зависимость от дефицитных размеченных данных, используя self-supervised обучение на большом объёме неразмеченного аудио. Это обеспечивает масштабируемость для разных языков и задач.
🔘 Динамическое маскирование self-attention позволяет одной модели работать в онлайн- и офлайн-режимах без дополнительного переобучения.
⚡️ Модель GigaAM, обученная Сбером с помощью метода HuBERT-CTC, показала лучшее качество распознавания речи по метрике WER (Word Error Rate) среди открытых моделей на русском языке и на 50% обошла Whisper-large-v3 от OpenAI. Решение может стать основой для следующего поколения голосовых интерфейсов: от AI-помощников до контакт-центров
GigaAM уже в открытом доступе для всех желающих на GitVerse и GitHub 💻
❤️🔥 — за работу!