TGViewer
Channel Public Channel
rzv Data Engineering

rzv Data Engineering

@rzv_de

Авторский канал о том, как я понимаю инжиниринг данных. Объясняю термины, best practice, делюсь описанием рабочих задачек. См закрепы

Рассчитан на новичков в DE и инженеров до Senior.

Чат: t.me/+jtQ1tjvNUtwzN2My
По вопросам: @razvodov_de_mentor
Subscribers
3.01K
Photos
185
Videos
1
Links
105
Recent Posts 10 shown
Post #476 584
Объектное хранилище в эпоху быстрых данных

Объём данных, с которыми нужно работать, растёт ежедневно. Стандартных решений уже не хватает для задач ИИ и аналитики. Большие объёмы данных нужно не только хранить, но и быстро записывать и читать.

В MWS Cloud Platform мы построили объектное хранилище не только на привычных HDD-дисках, но и на NVMe. На вебинаре покажем, какие сценарии работы это открывает и как меняет привычные подходы.

Подключайтесь! Обсудим:
✅ Чем классы хранения MWS Object Storage отличаются от привычных
✅ В каких сценариях новый тёплый класс проявляет себя лучше всего
✅ Преимущества и слабые места в разных сценариях работы

📆 7 октября в 14:00 (мск)

Зарегистрироваться
  • 👎 2
  • ❤ 1
  • 😁 1
Post #475 588
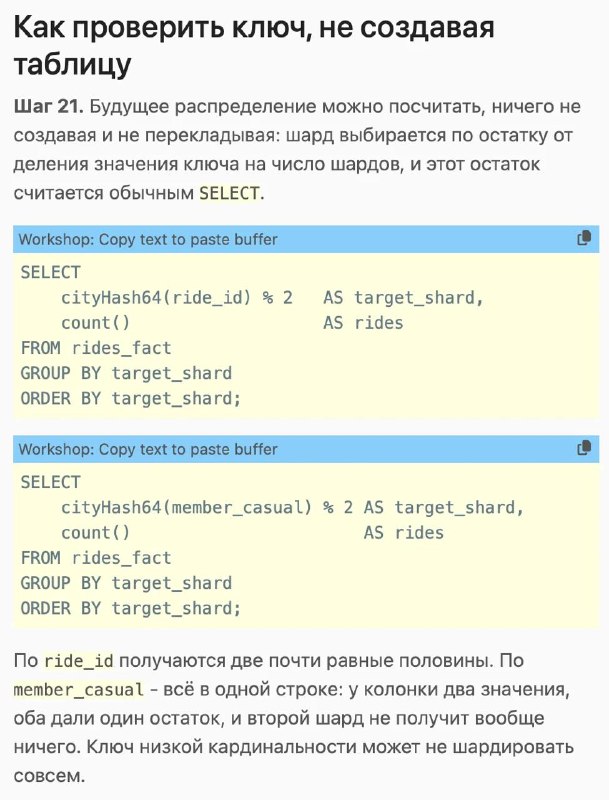
Как равномерно размазывать данные

Часто в командах, где я работал, проверяли равномерность распределения уже после вставки. А сам ключ распределения/шардирования выбирали скорее интуитивно.

🔸 Будущее распределение можно посчитать, ничего не создавая и не перекладывая. Шард выбирается по остатку от деления значения ключа на число шардов, и этот остаток считается обычным SELECT. Удобно это проверить в ClickHouse через cityHash64().

Представим что у нас есть табличка с продажами. Допустим, что у нас 5 шардов.


SELECT
cityHash64(order_id) % 5 AS target_shard,
count() AS orders
FROM orders
GROUP BY target_shard
ORDER BY target_shard;


Если ключ заказов создаётся на источнике равномерно, мы скорее всего увидим 5 примерно одинаковых строк, с разницей до 10% (моя субъективная оценка равномерности).

🔸 Допустим, типов заказа может быть 3. Тогда получим следующий запрос:


SELECT
cityHash64(order_type) % 5 AS target_shard,
count() AS orders
FROM orders
GROUP BY target_shard
ORDER BY target_shard;


И если вы думали, что в худшем случае 3 шарда получат данные, а 2 - нет, то ситуация может быть ещё веселее :) Остаток хэша может совпадать для нескольких значений, и в худшем случае все данные попадут на один шард.

Понимаю, что пример синтетический, и вряд ли опытные инженеры выберут такой ключ. Но, может быть, этот пост поможет тем, кто ещё набирается опыта. Принимайте решения на основе данных ;)
  • 🔥 9
  • 😁 2
  • 👎 1
Post #474 920
#реклама

Как разобраться в технологии глубже, чем по документации и чужим бенчмаркам?

Допустим, вы изучаете Lakehouse и хотите понять, в каких задачах такой подход оправдан по сравнению с классическим DWH. Интересно не только то, как настроить Trino и Iceberg, но и почему архитектура устроена именно так, что проверяли исследователи и насколько их выводы применимы к вашей нагрузке.

scid.ai — ИИ-платформа, которая объединяет весь исследовательский путь в одном приложении: от вопроса и поиска научных статей до анализа и подготовки материала с проверяемой доказательной базой.

Начать можно с запроса: «В чём различия Lakehouse и классического DWH?».

Дальше можно:
— отобрать подходящие статьи и сохранить их в библиотеку;
— посмотреть связи между публикациями на графе;
— задать вопросы по выбранным работам: какие объёмы данных, типы запросов и метрики использовали авторы;
— собрать таблицу сравнения и обзор для обсуждения с командой.

Обсудить статью можно и в универсальном ИИ-чате. Особенность scid.ai — в связи между поиском, анализом и итоговым документом. Отобранные источники остаются основой работы: не нужно заново собирать доказательную базу при переходе от чтения к написанию.

В результате — не универсальный ответ «какая архитектура лучше», а разбор подходов и их ограничений, который поможет сформулировать, что стоит проверить на собственном стенде.

Попробовать scid.ai на своей задаче
  • 👍 5
  • 👎 1
  • 😁 1
Post #468 1.08K
Лаба по шардированному ClickHouse вышла в релиз

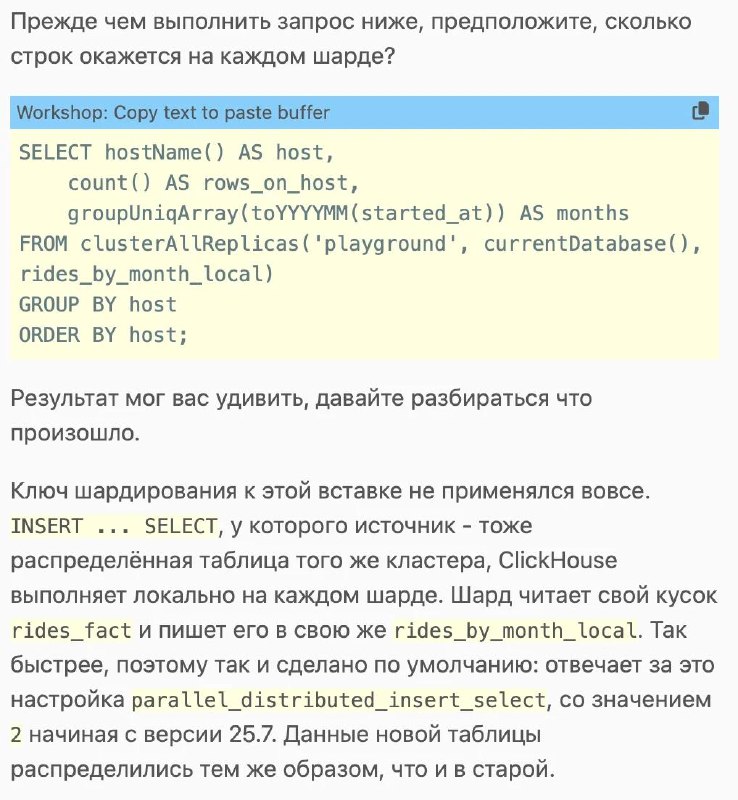
🔸 Вы своими руками соберёте реплицированные и распределённые таблицы, загрузите в них реальные данные. Также пройдёте через то, что может произойти при переходе с одиночного ClickHouse на шардированный:
- перекос от неудачно выбранного ключа
- перенос таблицы на кластер
- запросы, которые не падают и при этом отвечают некорректно
- особенности вставки и чтения при работе с распределёнными таблицами

🔸 Лаба рассчитана на тех, кто уже пишет SQL в ClickHouse. Колоночное хранение, MergeTree и синтаксис здесь не разбираются - только то, как меняется работа DE и какие грабли можно собрать при добавлении шардов. Версия CH: 26.7.

Время прохождения 4-6ч

Подробнее по ссылке

p.s. По анонсам буду точнее в следующий раз, "на неделе" не получилось)
  • ❤ 12
  • 🔥 3
Post #466 1.52K
Ловите новости по учебным стендам

🔸 На неделе планирую релиз шардированного Clickhouse 2х2. В нём расскажу про основы переноса таблиц с моно-кластера на шардированный CH с точки зрения дата инженера. Покажу на практике работу шардов и реплик. В нескольких задачах раскрою материализованные представления и проекции. Ну и маленько по витринам пройдёмся. Всё будет на той же платформе "материалы слева - СУБД клиент и UI справа".

На учёную степень по клику или навыки уровня DBA не претендую. Приглашаю ознакомиться тех DE, у кого не было опыта с Clickhouse в принципе или с его кластерной версией)

🔸 Потом скорее всего будет мини-Hadoop с "плановыми поломками" одной дата ноды каждые полчаса. Подумал, что надо устойчивые системы показывать в стрессовых ситуациях) Для тех, кто планирует работать в больших банках или других компаниях с петабайтными хранилищами.

🔸 Понемногу работаю над Streaming / Flink, видел спрос под одним из прошлых постов. Займёт сколько-то времени, пока не обещаю даты. Возможно, замахнусь на сравнение Kafka Streams, Flink, Spark Structure Streaming. Ищу экспертов, чтобы проконсультироваться по паре вопросов, пишите в личку)

🔸 И ещё закинул в бэклог с пяток тем, которые считаю актуальными, и вроде как есть что по ним рассказать:
• "CI/CD для DE" - Концепция CI/CD, рабочие окружения, code & DDL & Data sync
• "Моделирование данных" - Сравнение Inmon, Kimball, Data vault 2.0, One big table
• "Data quality" - Data issue alerts, dbt tests, great expectations, write-audit-publish pattern
• "Change data capture" - Live data + Debezium + Kafka + S3

Пишите в комментах, что ждёте больше всего. Может, чего-то ещё не хватает в бэклоге?

Ну а пока всех жду на стенде по "Lakehouse" :)
  • 🔥 16
  • ❤ 1
  • 👍 1
  • 😁 1
Post #465 1.91K
rzv Data Engineering Заканчиваю полировать, завтра с утра можно будет пробовать) За эту неделю получилось вылечить многие баги и несостыковки, добавить полезные фичи, улучшить Quality of Life, значительно расширить покрытие лабы. Но наверняка что-то ещё осталось из проблем, будем…
Первый лабораторный стенд уходит в релиз!
https://rzvde.pro/labs

Надеюсь, что материалы и практика помогут разобраться в актуальных вам темах)
Продуктивной учёбы!

Описание стенда "мини-Lakehouse":

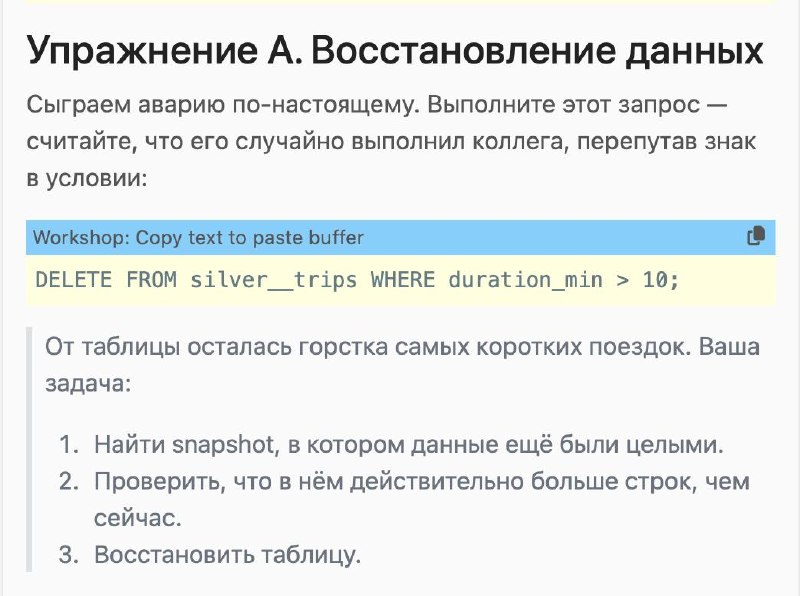
В этом материале описана концепция Lakehouse, показаны многие возможности Iceberg, проведено сравнение с DWH на базе Greenplum. Вы загрузите и обработаете сырые данные на 10 миллионов строк, создадите таблицы Silver слоя и витрины Gold слоя. Стенд содержит нужную теорию для выполнения практики.

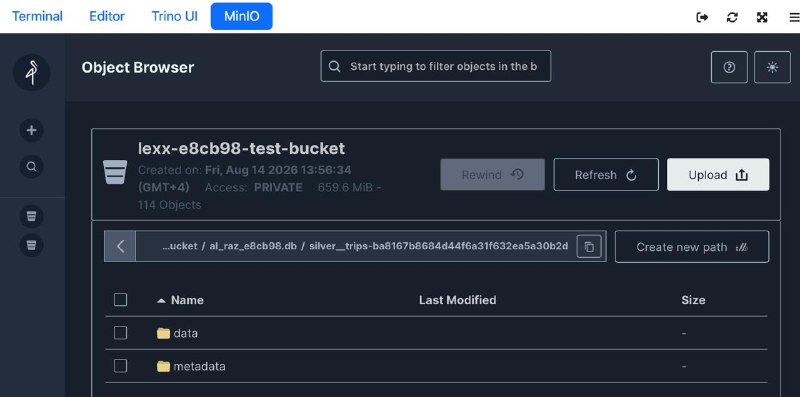
Работа с реальной инфраструктурой ведётся через SQL запросы и Linux terminal, Trino UI и MinIO web console. Также есть шаги:
- создание S3 бакета в MinIO
- настройка Trino каталога для загрузки в этот бакет

Содержание:
1. Введение
2. Подключение и разведка
3. Концепции: Trino, Iceberg, Lakehouse
4. Сырые данные — слой Hive
5. Управляемый слой — Iceberg
6. Time travel
7. Schema evolution
8. Partition evolution
9. Row-level операции и MERGE
10. Метаданные Iceberg
11. Обслуживание
12. Витрины (marts)
13. Аналитика
14. Очистка

Доступ выдаётся на 30 дней. Материалы можно сохранить в PDF.
  • 🔥 10
  • 🤔 4
Post #464 1.6K
В какие темы и технологии было бы интересно погрузиться с практикой? Пиши в комментариях, буду выбирать популярные идеи и формировать бэклог)
Post #463 1.67K
В общем, по поводу розыгрыша билета на конференцию и обсуждения под удалённым постом с рекламой:

Нечасто провожу эти розыгрыши, и досадно что именно в этот раз довольно крупно накосячил со своей стороны.

Как было по порядку:
• В комментариях в конкурсе приняли участие два человека - Даниил и Сергей.
• Я провёл розыгрыш, в котором победителем рандом выбрал Сергея, написал ему об этом под постом - но потом обнаружил, что не поставил OBS на запись.
• Подумал, что доказательство всё-таки нужно, записал ещё один раз, где рандом выбрал Даниила.
• Написал Даниилу об этом, и решил подчистить прошлое сообщение, где победитель - Сергей.
• Сергей указал мне на эту несправедливость в комментах, и потом я пытался объясниться, но услышать друг друга не получилось.
• Даниил пошёл навстречу и отказался от своего билета, чтобы в итоге он достался Сергею.

Я написал организатору конференции, в понедельник будем договариваться на то, чтобы по билету досталось обоим участникам.

Признаю, что поступил очень по-детски, поленившись пару раз крутануть барабан и заново сделать записи, чтобы первоначальный победитель был запечатлён на видео.
Сергей честно победил в этом случайном отборе в первый раз. И приз был достаточно серьёзный, стоило подготовиться лучше.

Или стоило хотя бы объяснить ситуацию на том же видео, и "покрутить этот барабан" на записи, пока снова не покажется Сергей.
Решил "сэкономить" пару минут, в итоге потратил час времени, нервы людей, и теперь напрягаю людей договариваться о новом билете.
Я косяк. Не делайте так)

Приношу извинения за неразбериху и потрёпанные нервы

p.s. Релиз mini-Lakehouse Lab откладывается до понедельника
  • 😢 6
  • ❤ 3
Post #458 1.43K
rzv Data Engineering Анонс новых учебных стендов по DE Я стремлюсь найти такие способы обучения технологиям, которые помогают разобраться и понять материал. Сейчас работаю над интерактивными стендами в стиле kodekloud, но для дата инженеров. Это такие лабы на 3-5 часов, где…
Заканчиваю полировать, завтра с утра можно будет пробовать)

За эту неделю получилось вылечить многие баги и несостыковки, добавить полезные фичи, улучшить Quality of Life, значительно расширить покрытие лабы. Но наверняка что-то ещё осталось из проблем, будем тестировать вместе) Поэтому цена до 22.08 сохраняется, потом подниму до 2500р. А стоит оно того или нет - решать вам.

Описание стенда "мини-Lakehouse" и ещё несколько скриншотов:

В этом материале описана концепция Lakehouse, показаны многие возможности Iceberg, проведено сравнение с DWH на базе Greenplum. Вы загрузите и обработаете сырые данные на 10 миллионов строк, создадите таблицы Silver слоя и витрины Gold слоя. Стенд содержит нужную теорию для выполнения практики.

Работа с реальной инфраструктурой ведётся через SQL запросы и Linux terminal, Trino UI и MinIO web console. Также есть шаги:
- создание S3 бакета в MinIO
- настройка Trino каталога для загрузки в этот бакет

Содержание:
1. Введение
2. Подключение и разведка
3. Концепции: Trino, Iceberg, Lakehouse
4. Сырые данные — слой Hive
5. Управляемый слой — Iceberg
6. Time travel
7. Schema evolution
8. Partition evolution
9. Row-level операции и MERGE
10. Метаданные Iceberg
11. Обслуживание
12. Витрины (marts)
13. Аналитика
14. Очистка

Доступ выдаётся на 30 дней. Материалы можно сохранить в PDF.
  • 🔥 15
Post #453 1.5K
Опыт миграции небольшого стека с Docker compose на Kubernetes 4/4

🔸 Что это даёт, по крайней мере для меня

Прежде всего - интеграцию с готовой платформой для "прогерских лабораторных работ", где k8s-манифесты это пререквизит

Возможность горизонтального масштабирования за пределы одной ВМ на будущее

Более удобный способ из одного контейнера управлять состоянием другого, например для сервиса выдачи доступов (в docker-compose стеке есть bind-mount /var/run/docker.sock, но идёт вместе с уязвимостью в виде root права на запуск любых контейнеров)


🔸Выводы

Для собственных проектов пока всё ещё не вижу смысла в k8s, как ни пытаюсь разглядеть. Всё в конечном итоге запускается на виртуальных машинах, за которые платишь. Даже в managed сервисе вроде "yandex cloud managed k8s" идёт отдельная аренда за месяц CPU/RAM/disk конкретных ВМ.

Пока продолжаю всей душой любить Docker compose.

Поделитесь в комментах, если есть удачный опыт переноса проектов на кубер, кроме случаев когда это кластеры на десятки ВМ. Я с интересом почитаю)
  • 👍 3
  • ❤ 1
Older posts →

About this channel

How can I read @rzv_de without a Telegram account?
TGViewer shows the public web preview Telegram publishes for rzv Data Engineering: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does rzv Data Engineering have?
rzv Data Engineering (@rzv_de) has 3.01K subscribers on Telegram, refreshed roughly every 30 minutes.
Does rzv Data Engineering know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →