Разговорился как-то с modexp про API hashing. Это очень старая техника, самое раннее упоминание, которое нашлось - статья LethalMind в 29A#4 за 1999 год. Суть проста, для того чтобы вирус мог что-то сделать ему нужны системные функции, мы их можем просто перечислить по именам: ws2_32.dll - bind, wininet.dll - InternetOpenA, за что тут же зацепятся антивирусы, потому вместо имен можно сохранять контрольные суммы, тоже достаточно уникальные, потому биконы Metasploit и Cobalt палятся со страшной силой. И уже в 2000 году Z0mbie предложил использовать случайные хеш-функции, и сразу проверять их на коллизии.
Даже сейчас, спустя двадцать пять лет эта нехитрая мысль сбивает большую часть детектов. С другой стороны, если бы я был авером, то я бы обратил внимание на то, что так как значение хорошей хеш-функции не отличимо от случайного, то в 99% 32-битных хешей будет от 10 до 22 единичных битов, и дальше можно ловить конструкции ptr = func(c), ptr(...), где 10 <= popcnt(c) <= 22, или искать высокоэнтропийные блоки, если хеши сложены в массив.
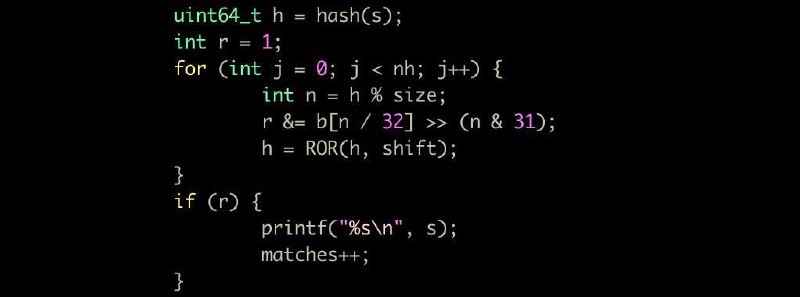
Следующая идея, которая пришла в голову уже мне - не хранить хеши, а воспользоваться фильтром Блума, но с ним другая неприятность. Блуму нужно большое количество разных хеш-функций, что тоже палевно. И тут попалось описание хеш-таблицы, которую придумал Вик Высоцкий в начале 60-х: возмем хеш большей разрядности, чем размер таблицы, и после каждого значения сдвинем побитово по кругу. Размер массива и параметры фильтра можно менять в достаточно широких пределах, и массив будет разреженным. Никаких констант в коде, низкая энтропия, полиморфизм как побочный продукт
Post #1721
22.2K

- 🔥 138
- 🤔 78
- 👍 55
- 🥱 4