TGViewer
Channel Public Channel
Роман с данными

Роман с данными

@roma_data

Все о данных, ML, AI
Founder LLM Arena. Ex-Founder TrainingData.Pro
Окончил ВМК МГУ, 8 лет занимаюсь сбором и разметкой данных
Контакты: @roman_kucev
Subscribers
2.72K
Photos
98
Videos
23
Links
118

Showing posts older than #49 · Back to latest

Older Posts 20 shown
Post #47 1.01K
Мы уже довольно давно занимаемся оценкой релевантности и качества поиска. Даже сделали отдельную страничку на нашем сайте.

Оценка качества поиска - это очень интересная задача. Благодаря собираемым оценкам поисковые движки учатся подбирать наиболее релевантную поисковую выдачу под каждый запрос пользователя. Таким образом все подходящие ссылки/документы оказываются сверху страницы, а неподходящие на страницу не попадают.
Если вы хотите более детально разобраться в принципах работы, советую посмотреть курс от МФТИ на Coursera. 

В вебинаре "Crowdsourcing с механической поддержкой”  Игорь Кураленок (руководитель Yandex.Cloud ML) рассказывал что раньше для оценки качества поиска Яндекс использовал внутренних асессоров и им для работы приходилось изучать инструкцию из более чем 100 страниц. Сейчас же Яндекс довольно много оценок собирает с помощью краудсорсинга, чем сильно упростил и отмаштабировал процесс получения новых данных. А вы пробовали выполнять в Толоке задания от Я.Массалия и Я.Юпитер?

Почему я решил рассказать вам об этом?
Недавно я наткнулся на инструкцию для асессоров из Google. Прикрепляю ее, чтобы вы могли оценить масштаб и сложность задачи. Инструкция состоит из 175 страниц, а чтобы получить работу, необходимо пройти 4 уровня отбора.

Забавно, что для такой работы до сих пор нанимают в штат людей по всему миру, платят по 5-23 доллара за час, хотя эту же задачу можно было решить быстрее, дешевле и качественнее с помощью краудсорсинга.
Post #46 2.05K
Собрал через Толоку 500 GB изображений людей в медицинских масках.

250 000 изображений, 28 000 уникальных лиц, 4 способа ношения масок.
Для каждого человека указан его пол, возраст, способ ношения маски. 
Выложил первую часть данных на kaggle: 
https://www.kaggle.com/tapakah68/medical-masks-part1

Также записал 6-и минутное видео, в котором рассказываю о построении пайплайна по сбору датасета: https://youtu.be/gAt1d-f_CK0

Как вы думаете, для решении какой задачи был собран этот датасет?
Post #45 1.11K
Post #44 1.68K
Вместе с Андреем встроили графический редактор в саму Толоку.
Используем мы его для разных задач, но в основном применяем для теста на узнаваемость и запоминаемость логотипов.

Любой компании хочется, чтобы ее бренд и логотип оставался в памяти у покупателей.
Но как определить, какой логотип запоминается лучше?

Мы используем следующий метод:
В течение 30 секунд показываем толокерам 10 различных логотипов, затем скрываем и просим по памяти нарисовать один из них. Затем анализируем результаты и определяем сколько процентов людей нарисовало логотип правильно.

Результаты всегда получаются очень интересными. Например, пару месяцев назад мы попросили толокеров нарисовать логотип Яндекс.Толоки, и вот что из этого вышло: https://kucev.ru/toloka_logo.html
Post #43 1.03K
Снова поучаствовал в датафесте. 
В прошлый раз я выступал с докладом "Обзор инструментов для разметки в CV”.

В этот раз решил рассказать об одном интересном проекте, который я реализовывал для американского стартапа XIX.ai. Стартап разрабатывает систему биометрической аутентификации человека по лицу. И для обучения системы было необходимо собрать множество спуфинг атак.

О том, что такое спуфинг атаки и как их собрать через Толоку, вы можете узнать из моего выступления “Как собрать датасет для аутентификации человека по лицу через Толоку”.
• 1:15 Биометрическая идентификация человека и виды хакерских атак
• 4:33 Собираем 10 000 spoofing attack за 10 дней и 300$
• 10:34 Заставляем крутить головой 25 000 человек
• 11:44 Собираем еще 11 000 spoofing attack
• 12:51 Интеграция сканера лица в Толоку
• 15:12 Планы на будущее
Post #42 1.04K
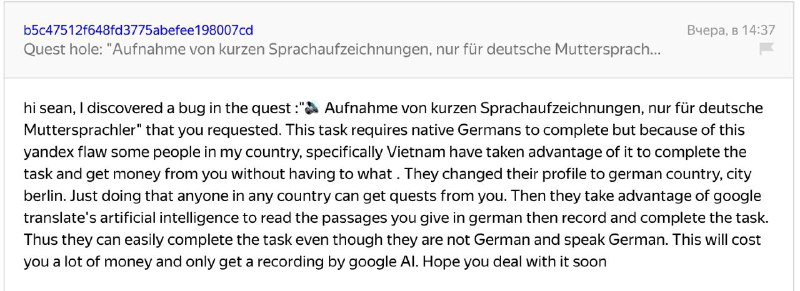
Задание было с постприемкой. Почему же мы принимали аудио, записанные с помощью озвучки Google Translate?
Ответ банален: мы не подумали, что кто-то мог так сделать, поэтому в инструкции для валидаторов не было пункта об отклонении такого типа аудио.

Какие выводы мы сделали из данной ситуации:
• Толокеры очень умные и изобретательные
• Если у вас очень дорогие задания, то шанс фрода со стороны толокеров возрастает
• Для валидаторов нужно тщательно прописывать инструкцию со всевозможными кейсами
• Если случаются какие-то аномалии на проекте, нужно разбираться, почему они произошли
Post #41 943
Но все оказалось не так радужно. Вот вам на обозрение сообщение от честного толокера, который помог нам найти причину
Post #39 971
Очень забавная история случилась с нами на этих выходных.
Мы по своей невнимательности за два дня профукали 1500$ в Толоке😬
Хотите узнать, как так получилось? Тогда усаживайтесь поудобнее!

Уже несколько месяцев мы для одного крупного заказчика собираем аудиозаписи из различных стран. На этих аудиозаписях заказчик обучает своего голосового помощника. Голосовой помощник должен работать во всем мире, поэтому команды мы собираем на разных языках. 

Краудсорсинг отлично подходит для этих целей: ведь на платформе присутствуют исполнители со всего мира, и нам не приходится в каждой стране искать людей. Поэтому, настроив одно задание в Толоке, у нас получилось охватить несколько десяток стран! (А вы уже оценили новую функцию написания инструкции на нескольких языках? Это просто 🔥!)

Самыми трудными для нас стали страны: Франция и Германия. 
Все дело в уровне жизни в этих странах. Если исполнители в Африке и странах СНГ готовы работать за 1.5-2$ в час, то в Европе есть "Минимальный размер оплаты труда в час”, который равен €9,35. Поэтому заманить европейцев на наше задание оказалось сложнее всего. Что мы только не делали: и придумали бонусную систему оплаты за объем, и просили саму Толоку наливать нам трафик, и увеличивали цену в 4 раза.

И вот, 20-го числа, мы получаем такой график:
Объем присылаемых аудио увеличился в 4 раза.
Вот как здорово, подумали мы!)
Post #38 1.15K
Объявляю вторую неофициальную встречу заказчиков Яндекс.Толоки!

Все мы помним ламповые посиделки заказчиков в офисе Яндекса, где мы обсуждали насущные для нас вопросы, делились мнениями и находили решения для различных задач. 
К сожалению, из-за коронавируса Яндекс был вынужден поставить встречи на паузу.

Но это не остановило нас, и мы продолжили встречаться, но уже на нейтральной территории в барах Москвы) 

В этот раз у нас появилась идея расширить наше комьюнити и позвать новых людей.
Поэтому мы с Андреем приглашаем вас присоединиться!) 
Когда: 26 апреля (пн) в 20:00
Где: Brasserie Lambic (метро Таганская)
Повестка: неформальное общение, обмен опытом, обсуждение и поиск новых идей для текущих задач

Если вам интересно присоединиться, пишите в ЛС.
Post #34 955
Посмотрел интересный вебинар от Романа Суворова "Полуавтоматическое составление датасета и активное обучение”.
Какие мысли для себя подчерпнул:

• 5:07 Предельное качество модели, которое можно получить на размечанных данных - это средняя мера качества асессоров.

• 6:34 Для обучения модели лучше сначала разметить немного, но качественно.

• 10:35 Оптимизировать стоимость разметки можно двумя способами: “Снижать стоимость разметки 1-го примера” и “Размечать меньше примеров”.

• 13:58 Сегментация по клику. Интересно, можно ли такое внедрить в Толоку?

• 25:46 Роман рассказывает как Samsung AI использует Яндекс.Толоку.

• 34:05 Стратегрии для Active learning.
YouTube Полуавтоматическое составление датасета и активное обучение. Роман Суворов Лекция посвящена автоматизации процесса разметки. В ней будут разобраны методы активного обучения и другие итерационные подходы. Лекцию читает Роман Суворов, ведущий инженер московского Центра ИИ Samsung, автор курса "Нейронные сети и обработка текста" …
  • 👍 1
Post #33 1.05K
Вместе с @FunFrog интегрировали Яндекс.Формы в Яндекс.Толоку.

О том
• какие сейчас есть варианты проведения опросов через Яндекс.Толоку,
• чем текущие варианты неудобны,
• почему наше решение нравится и толокерам и заказчикам,

смотрите в нашем видео: youtu.be/tTCxHrrj-ho
YouTube Интеграция Яндекс.Форм в Яндекс.Толоку Если вам нужна помощь в проведении опросов на Яндекс.Толоке, пишите в tg: @roman_kucev
Post #32 1.05K
Выложил на kaggle Russian Open Speech To Text (STT/ASR) Dataset.

Датасет содержит 118 000 аудиозаписей. Аудиозаписи были получены с помощью краудсорсинговой платформы Яндекс.Толока. В создании датасета участвовало 66 человек. Людям предлагались предложения для озвучки, необходимо было произносить предложения и записывать этот процесс на телефон.

Изначально датасет создавался для китайского заказчика Gstar-Marketing, но он пропал, так и не заплатив полную стоимость работ за проект. В связи с этим решено было выложить все уже собранные записи в открытый доступ (не пропадать же добру). К сожалению, мы так и не реализовали проект по валидации и проверке аудиозаписей, поэтому датасет немного "шумный" и может содержать "бракованные" аудиозаписи.

Но все-равно надеюсь, что кому-нибудь он пригодится.
Post #31 1.02K
На прошлой неделе совместно с CEO Яндекс.Толоки, Ольгой Мегорской, провели вебинар во ФРИИ.

Ольга рассказала о том, как Толоке позволяет размечать данные в больших масштабах.

Я же рассказал о бизнес задачах, которые можно решить с помощью краудсорсинга.

Ссылка на запись вебинара: https://youtu.be/afeRF2rTh64
YouTube Краудсорсинг для AI/ML Совместно с CEO Яндекс.Толоки, Ольгой Мегорской, провели вебинар во ФРИИ. Ольга рассказала о Толоке и о том, как краудсорсинг позволяет размечать данные на большом масштабе. Я же рассказал о бизнес задачах, которые можно решить с помощью краудсорсинга.
Post #29 976
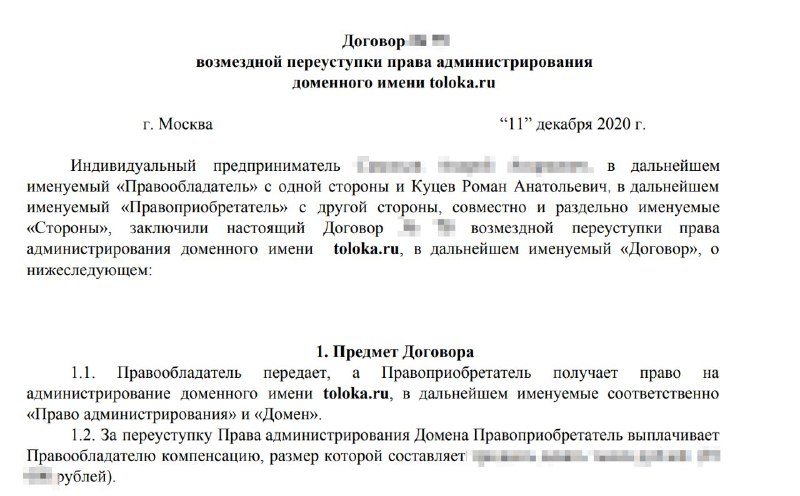
Друзья, на этих выходных я поучаствовал в интереснейшей авантюре и купил домен toloka.ru😀😀😀
Как такое произошло, спросите вы меня?

В октября я готовил материал для семинара в ШАДе. И однажды, заходя на сайт Толоки, я случайно вместо toloka.yandex.ru, ввел в браузере toloka.ru.

К своему удивлению, я не попал на привычный для меня сайт. Вместо этого открылся магазин доменов rf.ru, на котором было написано, что домен toloka.ru продается по договорной цене. Ради интереса я оставил заявку.

На следующий день менеджер rf.ru написала мне и назвала цену, но к сожалению, цена была крайне высока. Сообщив об этом менеджеру, я начал вести переговоры.

По прошествии шести недель переговоров мне удалось снизить цену в несколько раз. 
И я решил его купить. Зачем?

1. Ну блин, это же прикольно владеть доменом toloka.ru

2. Я разместил на нем сайт, посвященный значению слова “Толока”. Пусть лучше на нем будет образовательный контент, чем редирект на страницу о продаже.
Post #27 935
Благодаря слаженной работе у нас получилось за сутки реализовать полноценно работающий MVP, подготовить качественную презу и довольно хорошо выступить.

Результат
Мы выиграли спец секцию хакатона и получили приз в размере 50 000 руб.

Специально для вас я записал видео, в котором подробно рассказываю о нашем решении.

Благодарности:
Спасибо Руслану, Антону, Ринату, Леше за шикарно проведенные выходные!)
Post #26 1.54K
На прошлых выходных прошел хакатон innotechhack.

Задача на хакатоне была очень интересной: требовалось создать сервис для идентификации клиентов банка по фотографии и сбора их финансового профиля из различных открытых источников.

Я уже давно изучаю различные подходы по матчингу и майнингу данных с помощью краудсорсинга. Поэтому сразу понял: этот хакатон — отличная возможность воплотить все мои давние задумки в жизнь, попробовать реализовать работу с краудом в тех направлениях, в которых я еще не работал.

Итак, идея есть, можно приступать к реализации!

Я очень люблю хакатоны, множество раз участвовал в них и в качестве участника и в качестве жюри. На это есть несколько причин:

• Нетворкинг и окружение. В хакатонах участвуют интересные, умные и активные люди. Вы ведь читали Бенжамина Харди "Сила воли не работает. Пусть твое окружение работает вместо нее”? Так вот: окружение влияет на вас сильнее, чем вы думаете. Как говориться в старой доброй пословице «с кем поведешься, от того и наберешься».

• Проверка себя. Всего за 48 часов вы должны разобраться в проблеме компании сделать полноценный MVP, правильно его презентовать и доказать, что именно ваше решение лучшее.

• Умение разбираться в “боли” заказчиков и находить решения. Не всегда заказчик понимает полностью свою проблему. Заметил интересную корреляцию: чем больше команда общается с организаторами во время хакатона, тем лучше команде удается определить проблему, и тем более ценное и таргетированное решение команда может предоставить. Так что, даже если заказчик подробно описал задачу хакатона, не стесняйтесь спрашивать и уточнять все моменты, которые вам не понятны. Это поможет вам лучше понять, что от вас хотят получить. 

• Заработать денег. Для меня это не главная цель, но все-равно приятно, когда за выходные удается заработать больше, чем за месяц на основной работе.

• Пиар и улучшение своего резюме. Каждый выигранный хакатон увеличивает вашу зарплату на 5%.

• Оттачивание навыка работать в команде с новыми людьми. И хоть тут этот пункт последний, но для меня он первый в данном списке. 

Как говорится: «Один в поле не воин». И сильная команда — это важнейший фактор успеха на хакатоне (да и не только на хакатоне).

Обычно мне везло с командами: либо я находил хороших напарников прямо на самом хакатоне, либо меня заранее звали на определенную роль.

В этот же раз я впервые для себя собрал команду сам. 

Это был новый для меня опыт, поэтому я хочу с вами им поделиться.

Шаг 1. Определяем роли
В голове уже есть идея сервиса. Какие компетенции необходимы чтобы его создать? Для начала я выделил несколько пунктов:

1. Умение настраивать Яндекс.Толоку. 

2. Умение продавать, делать красивые презентации и проводить качественный спич. 

3. Разработка базы данных. Мы ведь хотим создать полноценный сервис. Поэтому нам нужно уметь хранить и обмениваться данными.

4. Разработка бэкенда. Мы хотим развернуть полноценный сервис в облаке, который будет работать автоматически.

5. Работа с API сторонних сервисов. На хакатоне довольно мало времени на реализацию и часто бывает выгодно использовать в качестве компонент уже готовые решения, чем писать свои с нуля.

Шаг 2. Ищем людей
Забавно, но все друзья, которым я написал, с радостью согласились присоединиться. 
Перед началом хакатона мы четко распределили роли и зоны ответственности.

1. Я на себя взял роль продакт менеджера, а также обязанность по настройке Толоки.

2. @rinazmeev делал презентации, исследовал существующие решения, общался с организаторами и проводил спич. 

3. @ruslixag и @anleb (мои коллеги из Neatsy) реализовывали базу данных и программировали бэкенд.

4. @alexeytarkhov (Computer Vision Engineer и мой сосед по квартире) интегрировал в наш сервис различные API.

Шаг 3. Пилим код
На время хакатона мы решили собраться все вместе у меня на квартире, заказать много еды из KFC и двое суток писать код. Это была безумно клевая идея. Невольно почувствовал себя героем сериала Silicon Valley.

Шаг 4. Презентуем и побеждаем
Post #25 1.82K
Интро

Всем привет! Я Роман Куцев, окончил ВМК МГУ, с 2016 года в сфере AI, ML, во время учебы выигрывал миллионы в ML хакатонах, преподавал в ШАДе и ВШЭ, работал RnD Engineer в Prisma Labs.

7 лет занимаюсь сбором и разметкой данных для обучения нейронных сетей. Вместе с кофаундерами за 5 лет вырастили компанию до 500м руб выручки и 1500 асессоров.

Автор бенчмарка LLM Arena
Веду соц сети с помощью AI аватара

3 лучших поста в канале
• Почему канал так называется
• Запуск LLM Arena
• Разметка. Тёмная сторона ML
  • ❤ 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →