
Craftax: A Lightning-Fast Benchmark for Open-Ended Reinforcement Learning
Ранее мы уже писали о проблеме сбора данных для обучения рл агентов - регулярный переход с цпу на гпу сильно снижает скорость сбора и качество данных и все такое
В последнее время в области рл произошел бум в связи с jax'ом, который позволяет не только производить компиляцию всего процесса обучения (Just-In-Time Compilation), но и в невероятно огромных масштабах параллелизовать процесс сбора траекторий в средах, не переходя обратно на цпу. Этот феномен имеет название JAX-based environments phenomenon
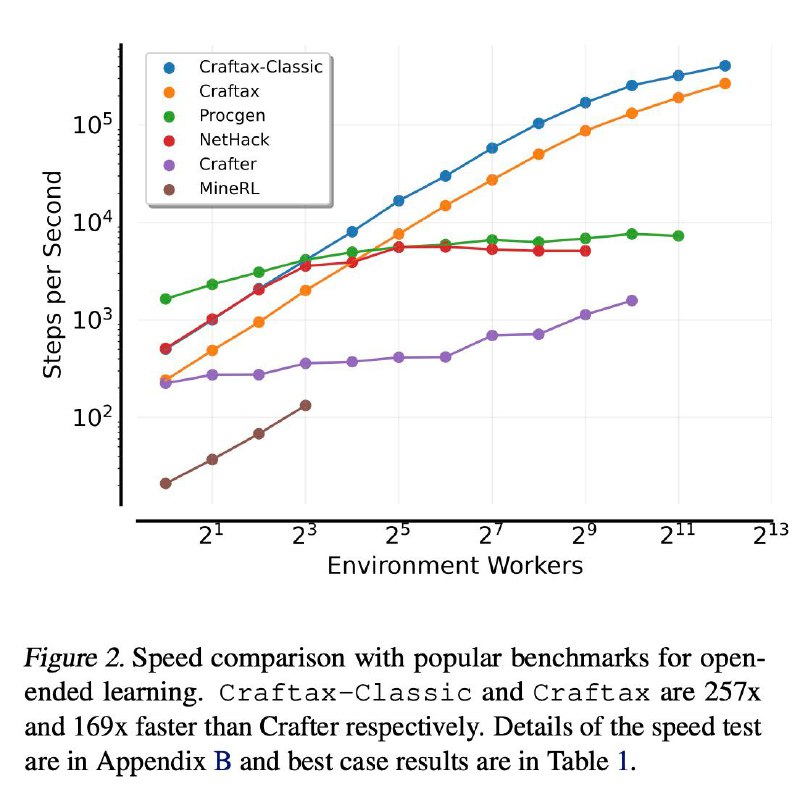
Насколько ускоряется этот процесс? Например, если вы возьмете готовый скрипт PPO из популярной репы cleanrl, то процесс обучения займет несколько часов на нескольких миллионах апдейт шагов
Авторы этой статьи способны обучить на своей среде PPO на миллиард шагов меньше чем за час и достигнуть 90% от оптимального уровня - вот один из плюсов джакса👡
(!) Но это еще не все - поскольку идет такое невероятное ускорение в сотни раз (буквально), то это позволяет и обучать агентов гораздо быстрее => ресерчерам проверять быстрее гипотезы => получать сота результаты по старым средам быстрее => усложнять среды, чтобы двигать область вперед
Крафтакс - оч яркий пример таких джакс сред, который в себя включает достаточную сложность и вопросы бесконечного эксплорейшна, долгосрочного планирования, адаптации к новым уровням и модельной памяти (это буквально инди игра), где можно очень сочно и быстро развивать существующие методы, чтобы рл перестала быть как область топорной непонятной штукой во многих местах и начала пробивать все потолки
👀LINK
#rl #jax #openendedness #compute #exploration #planning #memory #adaptation
Post #79
204

- 🤯 1
- 🤩 1