
Foundation Policies with Hilbert Representations
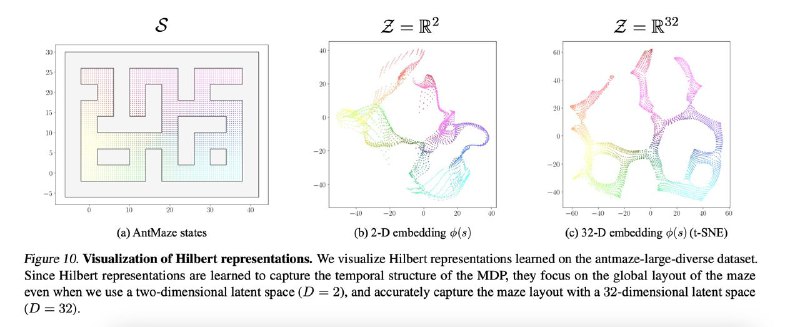
фаундейшн модели остаются открытым вопросом в области рл, поскольку зачастую эти методы требуют большого разнообразия и высокой экспертности данных для того, чтобы хоть что-то завелось. Беркли, а именно Seohong Park, решают эту проблему через латентное представление в Гильбертовом пространстве (звучит умно, а на самом деле в этом пространстве просто достаточно, чтобы inner product соответствовал метрике), которое сохраняет временные зависимости между состояниями в пространственных между эмбеддингами.
Политика же обучается после этого с формулированием подобного же intrinsic reward'a
Что это дает? возможность решать много разных goal-conditioned и zero-shot rl задач, обгоняя алгоритмы, которые затюнены специально под каждую конкретную таску
👀LINK
#rl #zeroshot #goalconditioning #hilbert #offlinerl
Post #65
222

- 👀 2