
Training Diffusion Models with Reinforcement Learning
Беркли и MIT показывают, что процесс денойзинга в диффузиях можно переформулировать в Марковский Процесс принятия решений (MDP), а значит и использовать функцию награды. А еще лучше использовать ее там, где промптом или определенным лоссом нужды извне так просто не выразишь (эстетичность, компрессибилити, соответствие промпту, подсчет объектов и так далее)
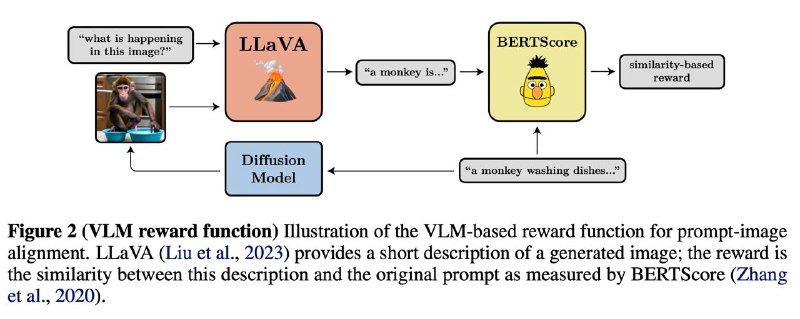
Вопросом остается, как все-таки сделать эту ревард функцию и как именно файнтюнить модель с ее учетом - авторы формулируют ревард функции при помощи других моделек, сохраняя ту семантику, которую они встраивают + используют простой метод reinforce для дообучения
Результаты прикольные, особенно учитывая то, что методы в рл используются относительно примитивные и здесь еще много непаханного поля по улучшению результата (+ генеративные модели здесь так же относительно старые, скорее всего из-за сложностей во времени обучения)
👀LINK
#rl #diffusion #text2img #promptalignment #mdp
Post #61
218

- 🔥 3
- ❤ 1