
Genie: Generative Interactive Environments
мы уже писали про концепцию world models в рл (тут и тут), которая (как и наверное все другие концепции) может сильно продвинуть область, если получить очень классную модель мира
дипмаинды, кажется, сделали супер крутое - foundation world model, которая по почти любому кадру (картиночному промпту) из интернета способна смоделировать траекторию этой “интерактивной среды”
пайплайн же состоит из трех моделек
- видео токенайзер: ето автоэнкодер, но не простой, а который может обработать видео у которых оч много токенов (вплоть до O(10^4), что бы это ни значило). и это Spatial-Temporal Transformer + VQ-VAE. вдвоем они компрессят входные фреймы в дискретные токены, а ST-Transformer используется в том числе и в декодере во время обучения и инференса для учета временной динамики, а не только пространственной
- модель латентных действий (latent action model, LAM): в себя тоже включает кодбуки VQ-VAE, которые и представляют из себя как раз обучаемые латентные действия. последовательность фреймов при том так же обрабатывается через СТ-Трансформер, а латентное действие является просто аутпутом энкодера, через который надо декодировать следующий фрейм, тем самым выявлять возможности изменения среды (действия). на инференсе же вся эта штука убирается и действия появляются от юзера
- модель динамики: по последовательности закодированных фреймов и последовательности латентных действий показывает, что будет дальше. тут так же фигурирует СТ-Трансформер в MaskGIT (видимо потому что у них он завелся именно этот каузальный трансформер)
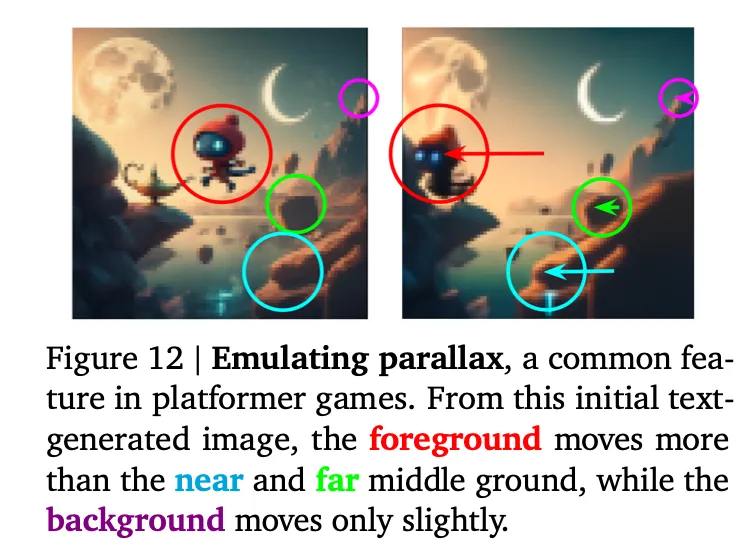
в итоге юзер может подать просто кадр, из этого создатся энва, и управлять в ней даже тем, что посчитается юзером. при том уровень моделирования динамики настолько хорош, что в играх эмулируется постепенная смена заднего фона в зависимости от угла наблюдателся - параплакс. а можно подавать как и фотки, так и какие-то ручные наброски с пиксельными кадрами игр
кода правда так и нет, as always, учитывая, что встает очень много вопросов по имплементации - как подбирать размерность латентных действий, как именно юзер подбирает действия, которые хочет совершить (кроме как метода тыка), почему в модели динамики у них сработало только суммирование акшнов с фрейм токенами (конкатенация не сработала, а пробовали ли что-то еще) и прочее-прочее
👀LINK
Post #559
374



- 🔥 3