Refusal in Language Models Is Mediated by a Single Direction
хотел написать какое-то смешное вступление про, как сейчас забавно обходить можно меры защиты против ЛЛМ и генерить что-то вредное, опасное и всякое такое; и какой интересной и важной задачей является отказ в генерации на такие запросы. но описание вступления - уже вступление
так вот авторы, в свою очередь, задались вопросом - а можно ли на внутреннем уровне модели отличать вредоносные запросы от безопасных? как оказывается, да. если по аналогии с ворд2век свойством Россия - Москва + Париж = Франция поиграть с активациями слоев, то можно найти вектор, который описывает понятие вредоносности - через разницу усредненных векторов активаций вредных и обычных промптов
добавляют/вычитают этот вектор к активациям - и реально работает, при том (почти) безотказно и не влияет на остальные свойства модели в генерации связного, релевантного, серо-буро-малинового текста
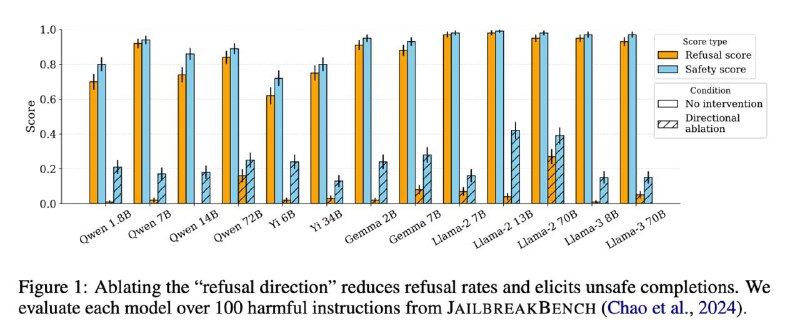
в качестве евала, является ли промпт безопасным (safety_score), использовали затюненную на это дело лламу чтобы результаты были как можно точнее, в качестве метрики использовали log-odds ratio от ее аутпутов. так же считали, отказывалась ли модель отвечать (refusal_score), потому что бывают сценарии, когда модель не отказывается ответить, но при этом ниче опасного не выводит
но добавлять постоянно вектор к активациям не оч удобно. авторы пошли дальше и сформулировали ортогонализацию весов с помощью этого вектора → убираем фактор вредосности из самих параметров и модель начинает отказываться от запросов-плохишей. по метрикам и скейлу моделек выглядит все очень вкусно и появляется желание самому такое заимплементить в своих задачах (потому что код есть, но для такой идеи негромоздким его сделать вряд ли возможно)
при том один вектор отказа от генерации вреда можно найти не только для чат-моделей, но и для обычных лм моделей ⇒ это больше относится к понятию языка в общем и/или пространству параметров, семантическому пространству или чему-либо еще. на практике можно спекулировать, что еще очень много таких векторов можно найти для желаемых целей (и этого будет достаточно для изменения генерации в нужную сторону)
но, несмотря на то, что добавление такой ортогонализации (вроде наверянка) не влияет на другие способности ЛЛМок и напрямую помогает с реджектом вредоносных запросов, если задать мета-вопросы, какие промпты нужно принять/отклонить, начинаются какие-то обтекаемые и непоследовательные ответы (что оптимизировали, по тому результат и улучшился, а не прибавилось понимание модели о понятии вреда в более сложных рассуждениях)
👀LINK
Post #392
381