


another extending for in-context reinfrocement learning
только теперь авторы питают интуицию из учения о социальном обучении живых существ (людей), а именно о понятии cultural accumulation - что же это? если взять цитату из статьи с пабмеда, то получим
Cultural accumulation occurs if the amount of cultural knowledge attained in a population in a given generation increases with the amount of cultural knowledge available in the previous generation.
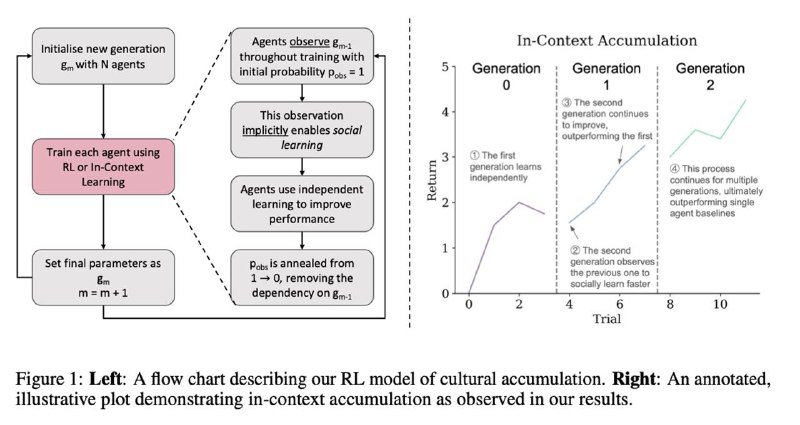
проще говоря, есть группа алгоритмов, которые следующему “поколению” переносят свой максимально достигнутый результат, чтобы в общем по задаче шло улучшение.
авторы сделали такую вещь в ин-контекст рл через мульти-агентное обучение - следующее поколение агентов имеет доступ статическому к поведению предыдущих агентов (которые живут кстати один эпизод для того, чтобы изолировать условие обучения ин-контекст), а основная модель (S5) еще и видит действия суб-оптимального оракула ⇒ сохраняется мульти-агентность, контекст имеет степень случайности и обучаемости + тренировочные семплы оверолл не сбиваются с достижения цели за счет доступа к оракулу
так же есть in-weights learning сетап, где агенты живут не эпизод, а все время обучения
сходимость к оптимальной награде ин-контекст мульти-агента происходит гораздо быстрее классической парадигмы, только дело в том, что они эксперименты проводили на своих же средах. просто до них пока не было развития в этой ветви - область пока настолько нова (как и рл), что только недавно выложили первый адекватный большой датасет для единого знаменателя следующих работ (подробнее про него можно здесь прочитать)
ждем развития событий
👀LINK