
In-Context Reinforcement Learning for Variable Action Spaces
мы уже ни раз писали про восходящую область ин-контекст рля, и эта папира не является исключением в расширении такой крутоты
изначально авторы поднимают тот момент, что вроде область называется ин-контекст, а многое тут связано c in-weights learning понятием. например, если вы переставите на тесте порядок действий, то все поломается (в лучших традициях классической задачи классификации и того принципа, что за каждым классом сохранено определенное порядковое число)
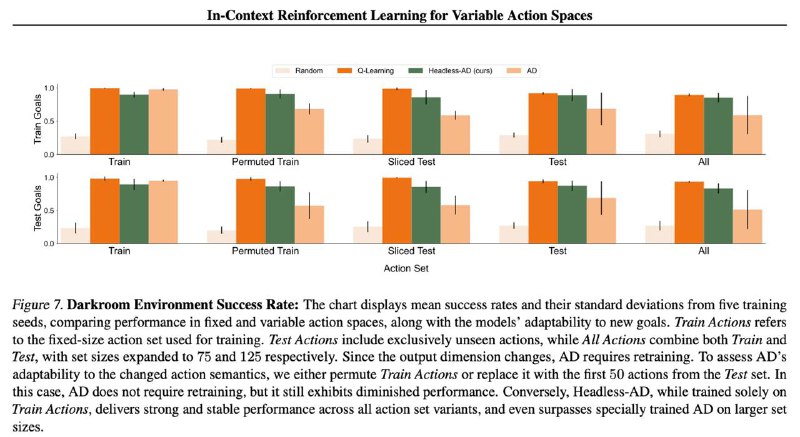
но этим не заканчиваются проблемы. когда бы ни были эти алгоритмы произведены в реальные сценарии, они (почти) смогут адаптироваться к новым задачам, но с тем же сетом действий. что по идее не совсем уж и реалистично. и авторы решают эту проблему, показывая сценарии, что во время евала некоторые действия могут быть скрыты, перемешаны (при том в разных пропорциях относительно того, что было на трейне)
а решается это довольно практично, без придумывания своей теории - за каждым действием фиксируется свой рандомный вектор. и эти векторы подаются на каждом степе в качестве контекста для того, чтобы трансформер мог поставить соответствия между векторами и (интуитивно) какую роль они выполняют в среде. и это работает! (при том лучше всего показывает свой результат ортогональная инициализация векторов, что не далеко от интуиции упрощенной разделимости векторов и действиями, которые за ними скрываются)
правда пока еще не решен питфолл в том, чтобы количество действий по ходу тестового времени увеличивалось, должно быть заранее известно количество максимальное + действия должны быть одной природы (либо дискретными либо непрерывными). но и без этого эта огромная работа, которая в прямом смысле открывает пласт на новую подобласть современного рля (имхо)
👀LINK
by the way, нас читает первый автор этой работы, что очень приятно!
UPD: и не только первый
Post #381
314


- ❤ 5