
Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads
какая боль, какая же боль этот инференс ллмок по скорости и компьюту, но Tri Dao банда решила внести вклад в решение этой проблемы
а именно они продолжают идею спекулятивного декодинга - первый токен последовательности генерируется ллмкой, а дальше остальное генерирует доп модель (мелкая), которая на каждом шаге основывается на своей генерации и первом токене ллмки
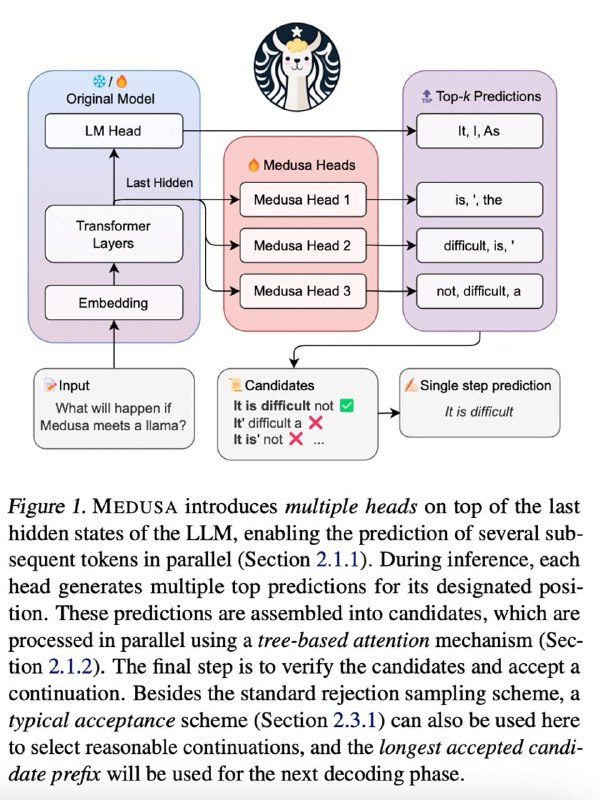
так вот, авторы навешивают сверху ллм декодер головы (небольшие модели, оперируют над выводом ллм первого токена и хидден стейта), которые параллельно генерят токены ⇒ уходим от последовательной генерации, получаем спидап + легко внедрить к существующим моделям. а файнтюнить попробовать можно только добавленные драфт модели
уже с этим происходит ускорение в 1.5 раза, но так же с этой идеей объединяется то, что авторы назвали tree attention, при том sparse tree attention structure, по которой пробегается жадный алгоритм для выбора самых топовых путей из дерева аттеншна (не путать с бим серчем) (ограничиваются 64 штуками)
показывают ускорение в 2.3-2.8 раза на 7b, 13b , 33b моделях если файнтюнить все, а если только спекулятивные головы, то ~2.2. по мне полный разнос и супер крутая идея
👀LINK
Post #311
419


- ❤ 4
- 👍 2
- 🔥 1