
Mixture-of-Depths: Dynamically allocating compute in transformer-based language models
Заводить трансформер и ждать пока обучится - Как страшный сон порой, не правда ли? Все через это проходили и проходят
Но! авторы (дипмаинд, конечно же) призадумались и поняли, что не на все части входных последовательностей нужно одинаковое количество вычислительных ресурсов (ну это давно поняли до них, но они решили это элегантно). Формально говоря, не всем нужно такое же количество компьюта (ФЛОПов), а значит, этой вещью можно сэкономить. но как?
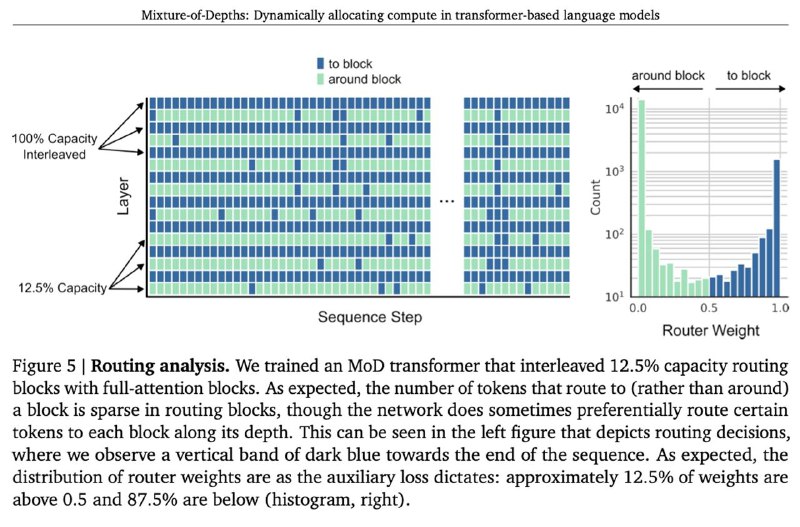
Вот здесь производят аналогию с МоЕ - а давайте динамически решать пропускать ли токен через весь слой трансформера или нет при помощи обучаемого роутера, который будет выдавать вес для каждого токена, а мы будем отсекать все кроме top-k ⇒ экономим в количестве вычислений, модель работает быстрее (да и по памяти последовательность меньшей длины по факту засовываем в трансформер)
Почему именно top-k? Ведь это по сути лишний гиперпараметр - да, но таким образом мы получим граф вычислений с заранее известными размерами тензоров, иначе без этого скорость была бы такой же + можно задаться вопросом, что выбор к токенов из последовательности нарушает каузальность трансформера, и это они тоже решают доп лоссом, который ставит все на свои места при инференсе
В общем статью не грех прочитать самому - довольно понятно и интересно все написано. особенно забавляет тот факт, что есть отдельный пункт Implementing Mixture-of-Depths Transformers, а кода нет
👀LINK
Post #189
347


- 💯 7
- 👍 4